Windows 與 Mac 的硬體影片解碼與編碼:D3D11、CUDA、Vulkan、OpenGL 和 Metal 一次看懂
NVDEC、NVENC、Quick Sync、AMF、D3D11VA、Vulkan Video 和 VideoToolbox 各是什麼,零複製 GPU 管線怎麼運作,硬體編碼什麼時候值得開。
重點速覽
硬體影片解碼與編碼,是把繁重的編解碼工作交給 GPU 上的固定功能引擎,而不是 CPU。在 Windows 上,應用程式透過 D3D11VA、D3D12、NVIDIA 以 CUDA 為基礎的 SDK、AMD AMF、Intel oneVPL 或 Vulkan Video 使用這些引擎;在 Mac 上則透過 VideoToolbox。好處是 CPU 負載更低、匯出更快,畫面也能一直留在 GPU 記憶體裡。
- GPU 內建專用的影片引擎(NVIDIA 的 NVDEC 與 NVENC、Intel Quick Sync、AMD VCN、Apple 的媒體引擎),解碼和編碼與繪圖核心分開進行。
- Windows 透過好幾種 API 使用這些引擎:D3D11VA 與 D3D12 video、NVIDIA 以 CUDA 為基礎的 SDK、AMD AMF、Intel oneVPL 與 Media SDK,以及 Vulkan Video。Mac 則用 VideoToolbox。
- 真正的好處往往是 CPU 負載降低:在我們的測試中,硬體解碼 4K H.264 比軟體解碼少用約 95% 的 CPU 時間。
- 硬體編碼速度快,但同樣畫質要花更多位元。我們用 GPU 編碼 HEVC,VMAF 分數追平 x265,速度快 3.3 倍,位元多用 15%。
- 零複製管線讓畫面在解碼、處理、顯示和編碼之間都留在 GPU 記憶體裡,並靠 D3D11、CUDA、OpenGL、Vulkan 和 Metal 之間的橋接來串起來。
一幀畫面經歷了什麼
每個影片應用程式都跑同樣的四個階段:把壓縮檔 解碼 成畫面,處理 畫面(縮放、色彩、AI 模型),然後在螢幕上 顯示,或 編碼 成新檔案。每個階段都可以在 CPU 或 GPU 上執行,而兩者之間每交接一次都要花時間。
畫面比多數人想的大。一幀 10 位元 4:2:0(GPU 使用的 P010 格式)的 4K 畫面,是 3,840 × 2,160 × 1.5 個樣本 × 2 位元組,約 24.9 MB。以每秒 60 幀計算,如果畫面在系統記憶體和 GPU 記憶體之間來回搬,每個方向每秒就是 1.5 GB。在 GPU 上解碼、處理、編碼而不必這樣來回搬的管線,稱為零複製(zero-copy),現代影片軟體的速度大多來自這裡。
GPU 裡的影片引擎
影片解碼和編碼,並不是在繪製遊戲或執行 AI 模型的那些核心上進行。GPU 為它們配置了獨立的固定功能區塊:
| 廠商 | 解碼引擎 | 編碼引擎 | 使用途徑 |
|---|---|---|---|
| NVIDIA | NVDEC | NVENC | NVIDIA Video Codec SDK(搭配 CUDA)、D3D11VA、D3D12、Vulkan Video |
| Intel | Quick Sync Video | Quick Sync Video | Intel oneVPL(Iris Xe 及更新)、Media SDK(較舊的 GPU)、D3D11VA、D3D12、Vulkan Video |
| AMD | VCN | VCN | AMD AMF、D3D11VA、D3D12、Vulkan Video |
| Apple | 媒體引擎 | 媒體引擎 | VideoToolbox |
NVIDIA 說得很明白:它的 GPU 內含與 CUDA 核心分開的硬體解碼器和編碼器。這帶來兩個結果。一來,硬體解碼和編碼幾乎不會拖慢 GPU 的其他工作,所以 AI 模型可以一邊執行,影片引擎一邊解碼接下來的畫面。二來,引擎能做什麼是寫死在晶片裡的:支援哪些編碼格式、位元深度和色度格式,取決於 GPU 的世代。例如 NVIDIA 的支援對照表就把 4:2:2 編碼列為 Blackwell 世代的新功能。在認定某種編碼格式有硬體加速之前,先查一下廠商的對照表。
Windows 與 Mac 上的解碼與編碼 API
同一個影片引擎,通常能透過好幾種 API 使用,各有長處:
| API | 平台 | 特點 |
|---|---|---|
| D3D11VA | Windows | 不綁定廠商、內建於 Windows,是在各種 GPU 上解碼支援最廣的方式;畫面直接落在 D3D11 紋理裡,可以立刻顯示 |
| D3D12 video | Windows | 同樣不綁定廠商,建立在 Direct3D 12 上,能明確控制記憶體與佇列;也能編碼 |
| NVDEC 與 NVENC(Video Codec SDK) | Windows、Linux | 直接使用 NVIDIA 的引擎,提供全套編碼器控制,畫面放在 CUDA 記憶體裡供 CUDA 處理 |
| AMD AMF | Windows、Linux | 使用 AMD 的影片引擎,另有 GPU 運算可做轉換與縮放 |
| Intel oneVPL 與 Media SDK | Windows、Linux | 使用 Quick Sync:oneVPL 用於 Iris Xe 及更新,Media SDK 用於較舊的 Intel 顯示晶片 |
| Vulkan Video | Windows、Linux 等 | 跨廠商標準:解碼、編碼、運算和繪圖都在同一個明確控制的 API 裡 |
| VideoToolbox | macOS | Apple 的框架,在 Mac 的媒體引擎上做硬體加速編碼與解碼 |
軟體解碼與編碼(libavcodec、x264、x265、SVT-AV1)仍然是硬體處理不了時的後備方案,也是畫質的基準。
五種管線:D3D11、CUDA、OpenGL、Vulkan 和 Metal
解碼產生畫面;管線決定畫面放在哪裡、接下來由誰處理。每種繪圖或運算 API 都是一種不同的管線:
- D3D11 是 Windows 上處理影片的主力。解碼器直接寫進 D3D11 紋理,影片處理器負責轉換和縮放,交換鏈負責顯示。它很成熟,在每張 Windows GPU 上都能用,是硬體解碼畫面最自然的去處。
- CUDA 是 NVIDIA 的運算平台。NVDEC 解碼的畫面可以留在 CUDA 記憶體裡處理,再直接送進 NVENC。NVIDIA 提供 CUDA 與 Direct3D 11 的互通 API,CUDA 的結果不必經過系統記憶體複製,就能變成 D3D11 紋理。
- OpenGL 是可攜性最高的繪圖 API,在播放器和剪輯軟體裡仍很常見。在 Windows 上,它透過互通擴充與 D3D11 共用紋理:NVIDIA 的
WGL_NV_DX_interop2,或不綁定廠商、能把 D3D11 記憶體匯入 OpenGL 的GL_EXT_memory_object_win32。 - Vulkan 是新一代的明確控制 API:繪圖、運算,加上 Vulkan Video 的解碼與編碼都在同一處,各家廠商都能用。
VK_KHR_external_memory_win32擴充讓 Vulkan 能在 Windows 上和 D3D11 共用記憶體。 - Metal 是 Apple 在 Apple Silicon 上用於繪圖與運算的 GPU API。Apple 表示晶片的統一記憶體讓各個元件存取同一份資料,不必在不同記憶體池之間複製,所以透過 VideoToolbox 解碼的畫面不用經過匯流排,就能處理和顯示。
難的不是哪一個 API,而是它們之間的邊界。用 CUDA 解碼、卻用 OpenGL 顯示的畫面需要一座橋;如果這座橋退回系統記憶體,在 GPU 上解碼的優勢就沒了。
我們的測試結果
我們用一台普通筆電測試:Intel Core i7-1360P,內顯為 Intel Iris Xe,搭配 FFmpeg 8.1。FFmpeg 在這台電腦上列出三條硬體路徑:D3D11VA、D3D12VA 和 Vulkan。
解碼 5 秒的 4K H.264(121 幀,25 Mbps):
| 路徑 | CPU 時間(使用者與系統) | 實際耗時 |
|---|---|---|
| 軟體(libavcodec) | 4.45 秒 | 0.55 秒 |
| D3D11VA | 0.22 秒 | 0.40 秒 |
| D3D12VA | 0.30 秒 | 0.48 秒 |
| Vulkan | 0.25 秒 | 0.52 秒 |
CPU 把工作分散到許多執行緒上,H.264 解得很快,但花了約 4.5 秒的 CPU 時間。三條硬體路徑完成的速度差不多,CPU 時間卻少了大約 95%,處理器就能空出來給管線裡的其他工作。
以 4 Mbps 為目標編碼 5 秒細節豐富的 1080p 素材:
| 編碼器 | 耗時 | 實際位元率 | VMAF |
|---|---|---|---|
| x264,preset medium(軟體) | 3.7 秒 | 3.4 Mbps | 71.6 |
| x265,preset medium(軟體) | 7.0 秒 | 3.5 Mbps | 72.5 |
| GPU 上的 H.264(D3D12) | 2.1 秒 | 4.3 Mbps | 67.2 |
| GPU 上的 HEVC(D3D12) | 2.1 秒 | 4.1 Mbps | 72.8 |
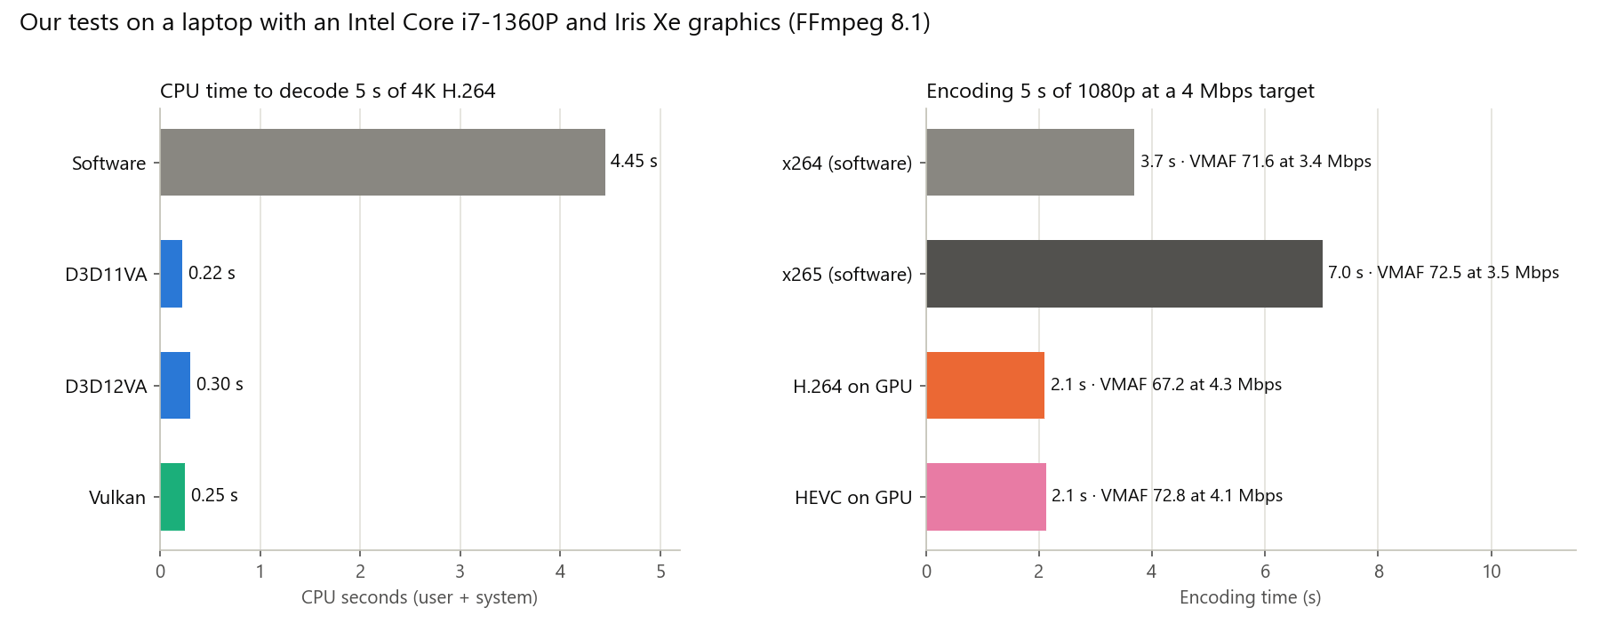
GPU 的 HEVC 編碼器追平了 x265 的 VMAF 分數,快 3.3 倍,但多花了約 15% 的位元;它的 H.264 編碼器比 x264 多用 26% 的位元,分數還是比較低。這是常見的取捨:硬體編碼器為速度和功耗調校,軟體編碼器為每位元的畫質調校。在這個驅動程式上,FFmpeg 的 Vulkan Video 編碼器無法啟動,這也提醒我們,支援程度因 GPU 和驅動程式而異。VMAF 量的是什麼,請見 我們如何評估影片畫質。
KwaFlux 如何運用每一條路徑
KwaFlux 不押寶在單一 API 上。它的媒體引擎為每一條解碼和編碼路徑都準備了外掛,並在管線之間架橋,所以能在每台電腦上挑出一條可用的硬體路線,讓畫面留在 GPU 上。
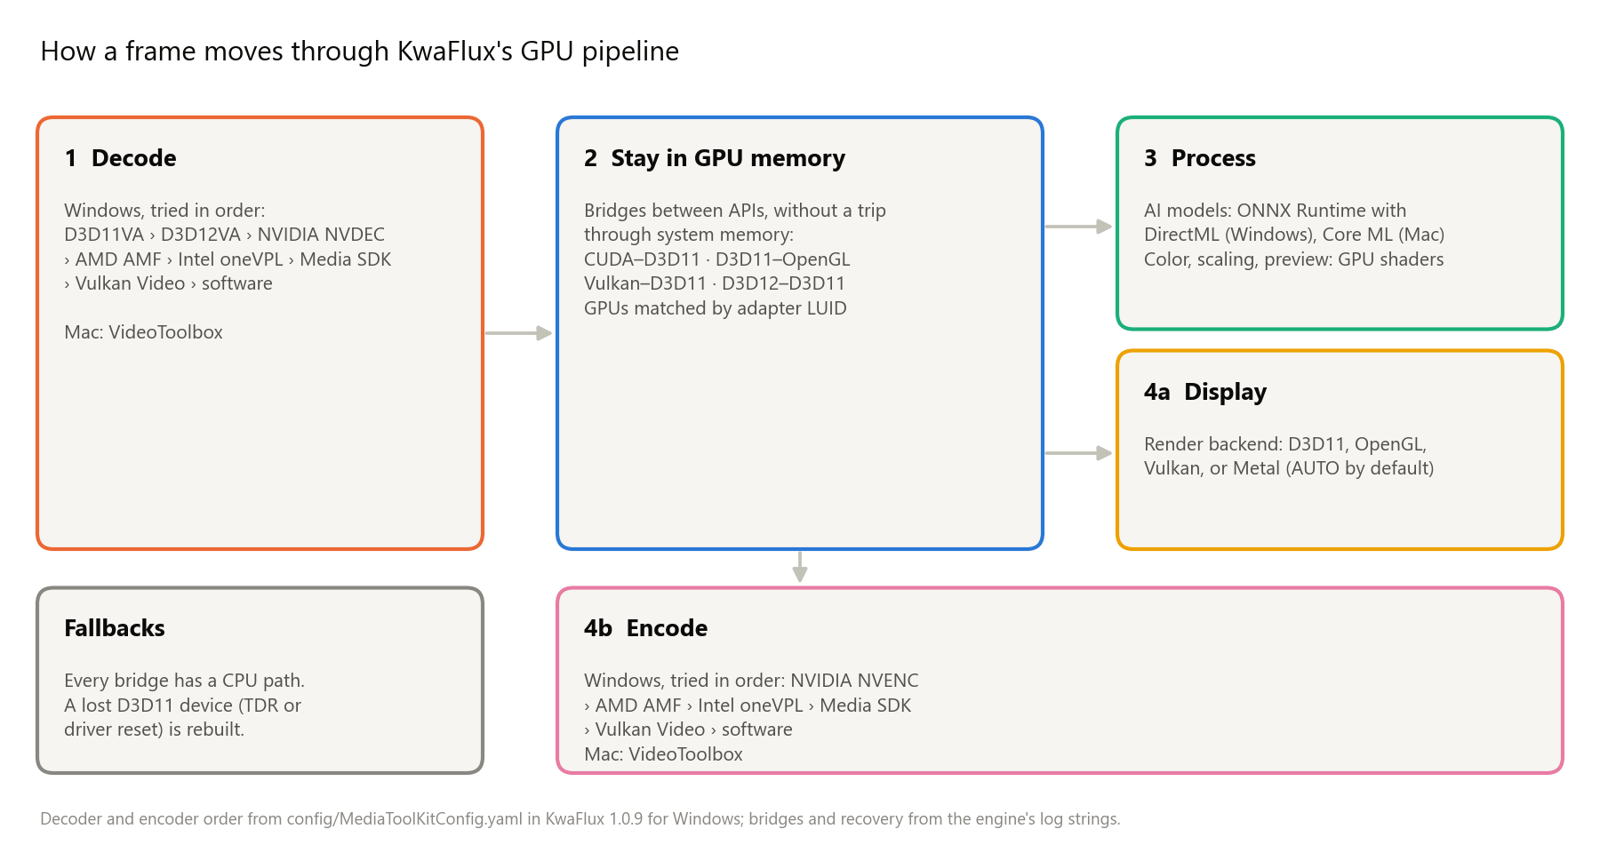
- 八條解碼路徑,依序嘗試。 在 Windows 上,引擎的設定會依序嘗試 D3D11VA、D3D12VA、NVIDIA NVDEC、AMD AMF、Intel oneVPL、Intel Media SDK 和 Vulkan Video,全都接不下這個檔案時才改用軟體解碼。
- 六條編碼路徑。 編碼時,它會先嘗試 NVIDIA NVENC、AMD AMF、Intel oneVPL、Media SDK 和 Vulkan Video,最後才是軟體。它的編碼器清單裡也包含 Apple 的 VideoToolbox 編碼器。
- 四種繪製後端。 畫面用 D3D11、OpenGL、Vulkan 或 Metal 繪製。預設的 AUTO 讓引擎自己選,平台不支援的後端會退回 AUTO。
- 避開系統記憶體的橋接。 NVDEC 的畫面透過 CUDA 的 D3D11 互通進入 D3D11;D3D11 和 OpenGL 透過
WGL_NV_DX_interop2或GL_EXT_memory_object_win32共用紋理;Vulkan 透過VK_KHR_external_memory_win32和 D3D11 共用記憶體;D3D12 和 D3D11 透過共用的 DXGI 控制代碼交換畫面。如果某台電腦上的 OpenGL 沒有有效率的橋接,播放器會改用 D3D11,而不是每一幀都複製。 - 一個任務只用一張 GPU。 在有兩張 GPU 的筆電上,引擎依 LUID 比對介面卡,所以解碼、處理和顯示不會讓畫面在內顯和獨顯之間來回跑。
- 出錯時復原,而不是當掉。 Windows 重設顯示驅動程式(TDR)時,播放器會重建它的 D3D11 裝置。每座橋都有 CPU 路徑可退,GPU 編碼器無法啟動的匯出則改用軟體編碼。
- 近年的 GPU 都能跑 AI。 在 Windows 上,AI 處理透過 ONNX Runtime 搭配 DirectML 執行,能在 Intel、AMD 和 NVIDIA 的 DirectX 12 GPU 上運作。在 macOS 13 或更新版本上,GPU 加速元件透過 Apple 的 Core ML 執行支援的功能。硬體方面請見 需要什麼樣的 GPU 和 KwaFlux 的 Mac 版。
有兩個設定可以讓你掌控它。設定 › 效能 › 硬體加速解碼 可以開關硬體解碼(重新啟動後生效),AI 處理器 則可以為 AI 工作選擇自動、GPU 或 CPU。在 轉換器 中,高速轉換 › GPU 加速 會在顯示卡上編碼 H.264 和 HEVC。它預設是關閉的:KwaFlux 註明它比較快,但在相同位元率下畫質略低於軟體編碼,這和我們的測試一致。每個檔案都會顯示 GPU 編碼 標記;GPU 編碼器無法啟動時,則顯示 已改用軟體編碼。
怎麼檢查你自己的電腦
列出 FFmpeg 能用的硬體路徑:
ffmpeg -hide_banner -hwaccels比較軟體解碼和硬體解碼的 CPU 時間。-benchmark 那一行會回報使用者時間(utime)、系統時間(stime)和實際耗時(rtime):
ffmpeg -hide_banner -benchmark -i input.mp4 -an -f null -ffmpeg -hide_banner -benchmark -hwaccel d3d11va -hwaccel_output_format d3d11 -i input.mp4 -an -f null -透過 D3D12 在 GPU 上編碼 HEVC,再以相同目標和 x265 比較:
ffmpeg -hide_banner -loglevel error -y -init_hw_device d3d12va=gpu -filter_hw_device gpu -i input.mp4 -vf "format=nv12,hwupload" -c:v hevc_d3d12va -rc_mode VBR -b:v 4M -maxrate 6M -c:a copy gpu_hevc.mp4ffmpeg -hide_banner -loglevel error -y -i input.mp4 -c:v libx265 -preset medium -b:v 4M -c:a copy cpu_hevc.mp4然後拿每個檔案和原片比較評分。有些 FFmpeg 版本沒有內建模型,所以先從 Netflix 的 VMAF 儲存庫下載 vmaf_v0.6.1.json 到同一個資料夾:
ffmpeg -hide_banner -i gpu_hevc.mp4 -i input.mp4 -lavfi "[0:v][1:v]libvmaf=model=path=vmaf_v0.6.1.json" -f null -如果硬體編碼在相近的位元率下分數和軟體編碼差不多,就把它用在草稿和快速分享上;存檔則保留軟體編碼。編碼格式本身怎麼選,請見 H.264、H.265 與 AV1 比較。
問題排解
| 問題 | 可能原因 | 解決方法 |
|---|---|---|
| 開了硬體解碼,檔案還是用軟體解碼 | 引擎不支援的編碼、位元深度或色度格式(常見的是 4:2:2 或 4:4:4) | 查廠商的支援對照表;軟體解碼照樣能用 |
| GPU 編碼的檔案看起來比較軟 | 硬體編碼器使用位元的效率較低 | 提高位元率,或最終版本關掉 GPU 加速 |
| GPU 編碼退回軟體編碼 | 不支援的格式、編碼器忙碌中,或驅動程式問題 | 更新顯示驅動程式;轉換器只對 H.264 和 HEVC 做 GPU 編碼 |
| 雙 GPU 筆電上畫面卡頓 | 畫面在內顯和獨顯之間來回傳 | 讓應用程式在連接螢幕的那張 GPU 上執行,或更新驅動程式 |
| 螢幕閃一下,畫面又恢復 | Windows 重設了顯示驅動程式(TDR) | 更新驅動程式;長時間匯出時減少其他 GPU 負載 |
| 硬體解碼好像沒有比較快 | CPU 解這種編碼格式本來就快 | 改看 CPU 負載:好處在於省下的 CPU 時間 |
做不到的事
- 硬體解碼不會讓畫面變好。 解碼器產出的畫面和軟體相同,只是工作換了地方做。
- 論每位元的畫質,硬體編碼贏不過慢速的軟體 preset。 它贏在速度和功耗。
- 沒有哪張 GPU 能加速每一種編碼格式。 支援範圍由晶片世代和驅動程式決定。
- 零複製需要硬體互相配合。 兩個 API 或兩張 GPU 無法共用記憶體時,畫面就得走較慢的 CPU 路線。
結語
硬體解碼與編碼,講的是工作在哪裡做:在固定功能引擎上,而不是 CPU;理想情況下,畫面也不離開 GPU 記憶體。打開硬體解碼讓工作更順,在速度比最後那一點效率更重要時用 GPU 編碼,並在你自己的電腦上把兩者都量一量。
KwaFlux 在你自己的 GPU 上解碼、處理和編碼影片,不論是在 轉換器 還是每個 AI 模組裡。媒體檔案不會為了處理而上傳。可在 Windows 10(64 位元,1809 或更新版本)、Windows 11,以及搭載 Apple Silicon 的 macOS 12 或更新版本上執行。匯入檔案和瀏覽應用程式都不需要帳號。僅在匯出、轉換、檔案修復和從連結下載檔案時需要登入並購買付費方案。
用你自己的真實素材實測效果
下載 KwaFlux,付費前先在自己的素材上免費預覽效果——無需註冊,在你的 GPU 上處理,媒體檔案不上傳。 影片預覽可選 1、3或5 秒;防抖預覽可選 5、15或30 秒。
常見問題
硬體編碼比軟體編碼差嗎?
在相同位元率下,通常是。硬體編碼器優先考慮速度和功耗,而不是效率,所以同樣畫質需要更多位元。在我們的測試中,GPU 的 HEVC 編碼器追平了 x265 的 VMAF 分數,快 3.3 倍,但多用了約 15% 的位元。
硬體解碼能讓播放更快嗎?
有時候可以。它主要的好處是降低 CPU 負載:在我們的 4K H.264 測試中,硬體解碼在速度相近的情況下少用了約 95% 的 CPU 時間。編碼格式吃重、解析度高,或 CPU 正忙著其他工作時,效果最明顯。
D3D11VA 和 NVDEC 有什麼差別?
在 NVIDIA GPU 上,兩者用的是同一套解碼硬體。D3D11VA 是 Microsoft 不綁定廠商的介面,畫面以 D3D11 紋理交付;NVDEC 是 NVIDIA 自己的介面,畫面交給 CUDA 處理。應用程式依畫面接下來要去哪裡來選。
內顯可以解碼和編碼影片嗎?
可以。Intel 的內顯內建 Quick Sync Video,近年的 AMD 和 Apple 晶片也有自己的影片引擎。我們的測試筆電就用 Iris Xe 內顯解碼 4K H.264、編碼 HEVC。支援哪些編碼格式取決於世代。
為什麼我的 4:2:2 檔案是用軟體解碼?
因為許多消費級影片引擎只能解碼 4:2:0,也就是大部分交付影片用的格式,4:2:2 的支援只出現在部分較新的世代。軟體解碼照樣能用,只是 CPU 負擔較重。這些格式的說明請見 色度抽樣一次看懂。
參考資料
- NVIDIA, "NVIDIA Video Codec SDK" (hardware decoders and encoders separate from the CUDA cores; NVENC codecs; 4:2:2 encoding on Blackwell) (2026-10-22 查閱)
- NVIDIA, "Video Encode and Decode GPU Support Matrix" (2026-10-22 查閱)
- NVIDIA, CUDA Runtime API, "Direct3D 11 Interoperability" (2026-10-22 查閱)
- Intel, "Intel Video Processing Library (Intel VPL)" (hardware decode, encode, and processing; VPL runtime for Iris Xe and newer, Media SDK for older graphics) (2026-10-22 查閱)
- AMD GPUOpen, "Advanced Media Framework (AMF) SDK" (access to AMD video engines, compute shaders, and hardware accelerators) (2026-10-22 查閱)
- Microsoft Learn, "Direct3D 11 Video APIs" (2026-10-22 查閱)
- Microsoft Learn, "WDDM support for timeout detection and recovery" (TDR resets an unresponsive graphics card) (2026-10-22 查閱)
- ONNX Runtime, "DirectML Execution Provider" (DirectML is a DirectX 12 library for machine learning across a broad range of hardware) (2026-10-22 查閱)
- Khronos, "VK_KHR_external_memory_win32" reference page (2026-10-22 查閱)
- Khronos OpenGL Registry, "WGL_NV_DX_interop2" (sharing Direct3D 10 and 11 resources with OpenGL) (2026-10-22 查閱)
- Apple Developer, "Video Toolbox" (hardware-accelerated video encoding and decoding) (2026-10-22 查閱)
- Apple Developer, "Metal" (graphics and compute on Apple GPUs) (2026-10-22 查閱)
- Apple Newsroom, "Apple unleashes M1" (unified memory lets the chip's components access the same data without copying it between pools of memory) (2026-10-22 查閱)
- Netflix, "VMAF" repository (vmaf_v0.6.1.json model) (2026-10-22 查閱)
- FFmpeg documentation (`-hwaccel`, `-hwaccel_output_format`, `-init_hw_device`, `-benchmark`) (2026-10-22 查閱)
KwKwaFlux 幕後 的更多文章