Windows と Mac のハードウェア動画デコード・エンコード:D3D11、CUDA、Vulkan、OpenGL、Metal を解説
NVDEC、NVENC、Quick Sync、AMF、D3D11VA、Vulkan Video、VideoToolbox のしくみ、コピーレスな GPU パイプライン、ハードウェアエンコードが役立つ場面を解説。
要点
ハードウェアによる動画のデコードとエンコードは、重いコーデック処理を CPU ではなく GPU 上の固定機能エンジンに任せるしくみです。Windows では、アプリは D3D11VA、D3D12、NVIDIA の CUDA ベースの SDK、AMD AMF、Intel oneVPL、Vulkan Video を通じて、Mac では VideoToolbox を通じてそのエンジンを使います。その結果、CPU 負荷が下がり、書き出しが速くなり、フレームを GPU メモリに置いたままにできます。
- GPU には、グラフィックスのコアとは別に、デコードとエンコードを担う専用の動画エンジン(NVIDIA の NVDEC と NVENC、Intel Quick Sync、AMD VCN、Apple のメディアエンジン)があります。
- Windows ではいくつもの API からそれらを使います。D3D11VA と D3D12 のビデオ API、NVIDIA の CUDA ベースの SDK、AMD AMF、Intel oneVPL と Media SDK、Vulkan Video です。Mac は VideoToolbox を使います。
- 本当の利点は、CPU 負荷の低さであることが多いです。私たちのテストでは、4K H.264 のハードウェアデコードは、ソフトウェアデコードより CPU 時間を約 95% 減らしました。
- ハードウェアエンコードは速いものの、同じ画質により多くのビットを使います。私たちの GPU による HEVC エンコードは、x265 と同じ VMAF スコアに 3.3 倍の速さで達し、ビットは 15% 多く使いました。
- コピーレスなパイプラインは、デコード、処理、表示、エンコードのあいだフレームを GPU メモリに置いたままにし、D3D11、CUDA、OpenGL、Vulkan、Metal のあいだをブリッジでつなぎます。
フレームに何が起きているか
どの動画アプリも同じ 4 つの段階を踏みます。圧縮ファイルをフレームに デコード し、フレームを 処理(拡大縮小、色、AI モデル)して、画面に 表示 するか新しいファイルに エンコード します。どの段階も CPU と GPU のどちらでも実行でき、両者のあいだの受け渡しのたびに時間がかかります。
フレームは多くの人が思うより大きなものです。10 ビット 4:2:0(GPU が使う P010 形式)の 4K フレームは 3,840 × 2,160 × 1.5 サンプル × 2 バイトで、約 24.9 MB です。毎秒 60 フレームなら、フレームがシステムメモリと GPU メモリを行き来する場合、方向ごとに毎秒 1.5 GB になります。この往復なしに GPU 上でデコード、処理、エンコードを行うパイプラインはコピーレス(メモリコピーなし)と呼ばれ、現在の動画ソフトの速さの大半はそこから来ています。
GPU の中の動画エンジン
動画のデコードとエンコードは、ゲームを描画したり AI モデルを動かしたりするコアでは実行されません。GPU はそのための独立した固定機能ブロックを持っています。
| メーカー | デコードエンジン | エンコードエンジン | 利用する API |
|---|---|---|---|
| NVIDIA | NVDEC | NVENC | NVIDIA Video Codec SDK(CUDA と併用)、D3D11VA、D3D12、Vulkan Video |
| Intel | Quick Sync Video | Quick Sync Video | Intel oneVPL(Iris Xe 以降)、Media SDK(旧世代の GPU)、D3D11VA、D3D12、Vulkan Video |
| AMD | VCN | VCN | AMD AMF、D3D11VA、D3D12、Vulkan Video |
| Apple | メディアエンジン | メディアエンジン | VideoToolbox |
NVIDIA ははっきりと、自社の GPU には CUDA コアとは別にハードウェアのデコーダーとエンコーダーがあると述べています。ここから 2 つのことが言えます。1 つ目に、ハードウェアのデコードとエンコードはほかの GPU 処理をほとんど遅くしないので、動画エンジンが次のフレームをデコードしているあいだに AI モデルを動かせます。2 つ目に、エンジンにできることはシリコンに固定されていて、コーデック、ビット深度、クロマ形式の対応は GPU の世代で決まります。たとえば NVIDIA のサポートマトリクスでは、4:2:2 のエンコードは Blackwell 世代で新たに加わったとされています。コーデックがハードウェアで処理されると思い込む前に、メーカーのマトリクスを確認してください。
Windows と Mac のデコード・エンコード API
1 つの動画エンジンには、たいてい複数の API からアクセスできます。それぞれに強みがあります。
| API | プラットフォーム | 特徴 |
|---|---|---|
| D3D11VA | Windows | メーカーを問わず Windows に組み込まれ、どの GPU でもデコードできるもっとも広く対応した方法。フレームは表示可能な D3D11 テクスチャに入る |
| D3D12 ビデオ | Windows | 同じくメーカーを問わない考え方を Direct3D 12 で実現し、メモリとキューを明示的に制御できる。エンコードにも対応 |
| NVDEC と NVENC(Video Codec SDK) | Windows、Linux | NVIDIA のエンジンへの直接アクセス、エンコーダーの全制御項目、CUDA 処理用に CUDA メモリに置かれるフレーム |
| AMD AMF | Windows、Linux | AMD の動画エンジンへのアクセスに加え、変換と拡大縮小のための GPU 演算 |
| Intel oneVPL と Media SDK | Windows、Linux | Quick Sync へのアクセス。Iris Xe 以降は oneVPL、旧世代の Intel グラフィックスは Media SDK |
| Vulkan Video | Windows、Linux ほか | メーカー横断の標準。デコード、エンコード、演算、グラフィックスを 1 つの明示的な API で扱う |
| VideoToolbox | macOS | Mac のメディアエンジンでハードウェアによるエンコードとデコードを行う Apple のフレームワーク |
ソフトウェアによるデコードとエンコード(libavcodec、x264、x265、SVT-AV1)は、ハードウェアで扱えないすべてのものの代替手段であり、画質の基準でもあり続けています。
5 つのパイプライン:D3D11、CUDA、OpenGL、Vulkan、Metal
デコードはフレームを生み出し、パイプラインはそのフレームをどこに置き、次に誰が処理するかを決めます。グラフィックスや演算の API は、それぞれ別の種類のパイプラインです。
- D3D11 は Windows の動画処理の主力です。デコーダーは D3D11 テクスチャに直接書き込み、ビデオプロセッサーがそれを変換・拡大縮小し、スワップチェーンが表示します。成熟していてどの Windows の GPU でも動き、ハードウェアでデコードしたフレームの自然な置き場所です。
- CUDA は NVIDIA の演算プラットフォームです。NVDEC でデコードしたフレームは CUDA メモリに置いたまま処理し、そのまま NVENC に渡せます。NVIDIA は CUDA と Direct3D 11 の相互運用 API を公開しているので、CUDA の結果をシステムメモリ経由のコピーなしに D3D11 テクスチャにできます。
- OpenGL はもっとも移植性の高いグラフィックス API で、プレーヤーや編集ソフトでいまもよく使われています。Windows では相互運用の拡張機能、NVIDIA の
WGL_NV_DX_interop2か、D3D11 のメモリを OpenGL に取り込むメーカー非依存のGL_EXT_memory_object_win32を通じて、D3D11 とテクスチャを共有します。 - Vulkan は現代的な明示型 API です。グラフィックス、演算、そして Vulkan Video によるデコードとエンコードを、どのメーカーでも 1 か所で扱えます。
VK_KHR_external_memory_win32拡張を使うと、Windows で Vulkan と D3D11 がメモリを共有できます。 - Metal は、Apple シリコンでグラフィックスと演算を行う Apple の GPU API です。Apple はチップのユニファイドメモリについて、各部がメモリプール間でコピーせずに同じデータにアクセスできると説明しています。そのため VideoToolbox でデコードしたフレームを、バスをまたがずに処理して表示できます。
難しいのは個々の API ではなく、その境目です。CUDA でデコードして OpenGL で表示するフレームにはブリッジが必要で、そのブリッジがシステムメモリ経由に戻ってしまえば、GPU でデコードした利点は失われます。
テストでわかったこと
テストに使ったのは、Intel Core i7-1360P と内蔵の Intel Iris Xe グラフィックスを積んだごく普通のノートパソコンで、FFmpeg 8.1 を使いました。FFmpeg はこのマシンで D3D11VA、D3D12VA、Vulkan の 3 つのハードウェア経路を表示しました。
4K H.264 の 5 秒(121 フレーム、25 Mbps)のデコード:
| 経路 | CPU 時間(ユーザーとシステム) | 経過時間 |
|---|---|---|
| ソフトウェア(libavcodec) | 4.45 秒 | 0.55 秒 |
| D3D11VA | 0.22 秒 | 0.40 秒 |
| D3D12VA | 0.30 秒 | 0.48 秒 |
| Vulkan | 0.25 秒 | 0.52 秒 |
CPU は処理を多数のスレッドに分けて H.264 を速くデコードしましたが、そのために約 4.5 秒の CPU 時間を使いました。3 つのハードウェア経路はどれもほぼ同じ速さで終わり、CPU 時間はおよそ 95% 少なく、プロセッサーはパイプラインのほかの処理に回せます。
細部の多い 1080p 映像 5 秒を 4 Mbps 目標でエンコード:
| エンコーダー | 時間 | 実際のビットレート | VMAF |
|---|---|---|---|
| x264、preset medium(ソフトウェア) | 3.7 秒 | 3.4 Mbps | 71.6 |
| x265、preset medium(ソフトウェア) | 7.0 秒 | 3.5 Mbps | 72.5 |
| GPU での H.264(D3D12) | 2.1 秒 | 4.3 Mbps | 67.2 |
| GPU での HEVC(D3D12) | 2.1 秒 | 4.1 Mbps | 72.8 |
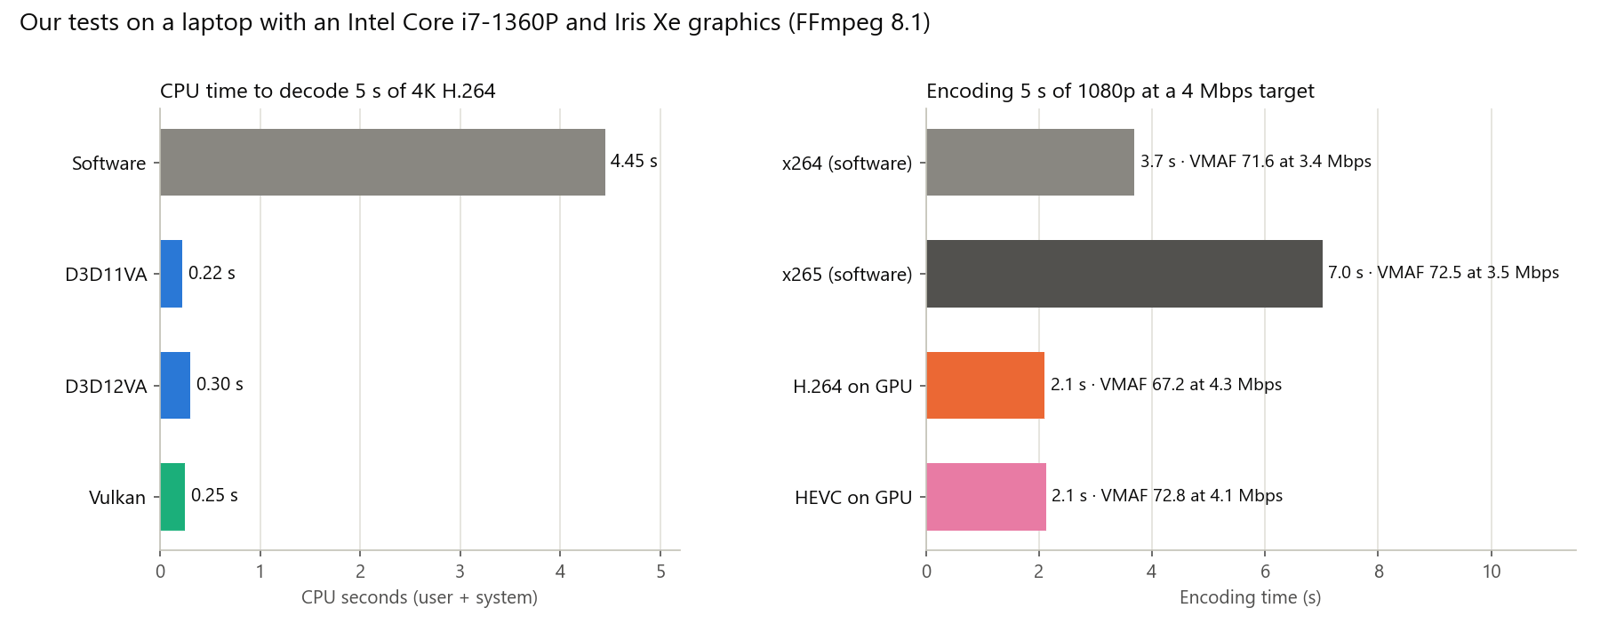
GPU の HEVC エンコーダーは x265 と同じ VMAF スコアに 3.3 倍の速さで達しましたが、そのために約 15% 多くのビットを必要としました。H.264 エンコーダーは x264 より 26% 多くのビットを使っても、スコアは低いままでした。これがよくあるトレードオフです。ハードウェアエンコーダーは速さと電力効率に、ソフトウェアエンコーダーはビットあたりの画質に合わせて調整されています。このドライバーでは FFmpeg の Vulkan Video エンコーダーは起動せず、対応が GPU とドライバーで違うことを思い出させてくれました。VMAF が何を測るかは 動画品質のスコアの付け方 で説明しています。
KwaFlux はすべての経路をどう使うか
KwaFlux は 1 つの API に賭けていません。メディアエンジンがデコードとエンコードの経路ごとにプラグインを持ち、パイプライン間をブリッジでつなぐので、マシンごとに動くハードウェアの経路を選び、フレームを GPU 上に置いたままにできます。
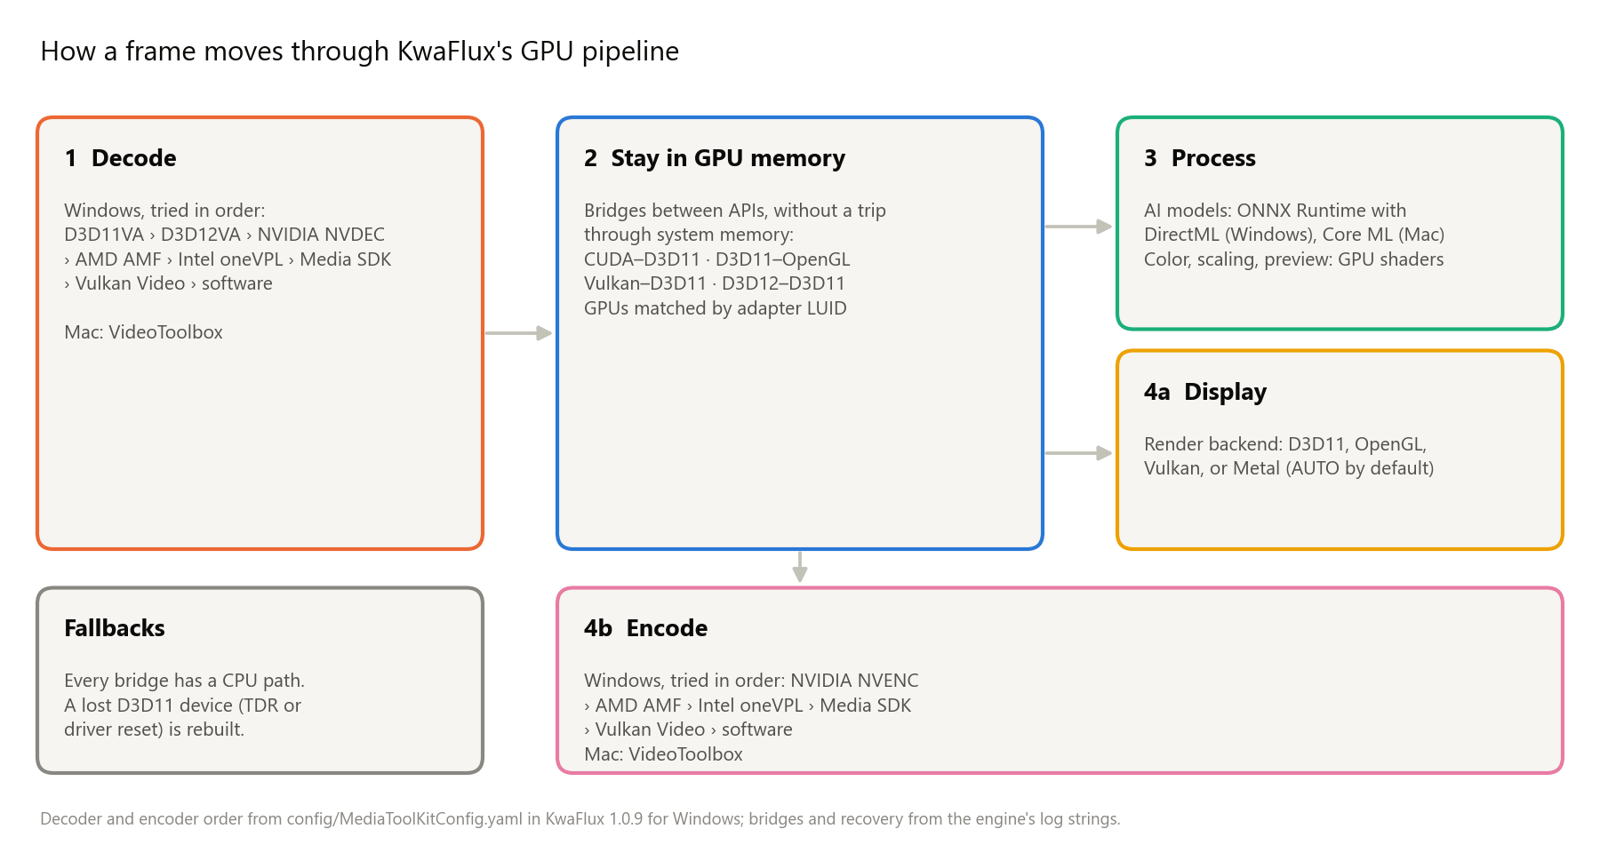
- 8 つのデコード経路を順に試します。 Windows では、エンジンの設定に従って D3D11VA、D3D12VA、NVIDIA NVDEC、AMD AMF、Intel oneVPL、Intel Media SDK、Vulkan Video の順に試し、どれもファイルを扱えない場合だけソフトウェアでデコードします。
- 6 つのエンコード経路。 エンコードでは、ソフトウェアの前に NVIDIA NVENC、AMD AMF、Intel oneVPL、Media SDK、Vulkan Video を試します。エンコーダーの一覧には Apple の VideoToolbox エンコーダーも含まれています。
- 4 つの描画バックエンド。 映像は D3D11、OpenGL、Vulkan、Metal のいずれかで描画されます。既定の AUTO ではエンジンが選び、プラットフォームが対応していないバックエンドは AUTO に戻ります。
- システムメモリを避けるブリッジ。 NVDEC のフレームは CUDA の D3D11 相互運用で D3D11 に渡り、D3D11 と OpenGL は
WGL_NV_DX_interop2かGL_EXT_memory_object_win32でテクスチャを共有し、Vulkan はVK_KHR_external_memory_win32で D3D11 とメモリを共有し、D3D12 と D3D11 は DXGI の共有ハンドルでフレームを受け渡します。マシン上で OpenGL に効率のよいブリッジがない場合、プレーヤーは毎フレームをコピーする代わりに D3D11 に切り替えます。 - 1 つのジョブに 1 つの GPU。 GPU を 2 つ積んだノートパソコンでは、エンジンがアダプターを LUID で照合するので、デコード、処理、表示のあいだにフレームが内蔵 GPU と単体 GPU を行き来しません。
- クラッシュではなく復帰。 Windows がグラフィックスドライバーをリセットした場合(TDR)、プレーヤーは D3D11 デバイスを作り直します。どのブリッジにも CPU の経路があり、GPU エンコーダーが起動できない書き出しはソフトウェアでエンコードされます。
- 最近の GPU なら AI を実行できます。 Windows では、AI 処理は ONNX Runtime と DirectML で実行され、Intel、AMD、NVIDIA の DirectX 12 対応 GPU で動きます。macOS 13 以降では、GPU アクセラレーションコンポーネントが対応機能を Apple の Core ML で実行します。ハードウェア面は 必要な GPU と Mac での KwaFlux で扱っています。
挙動を調整できる設定は 2 つあります。設定 › パフォーマンス › ハードウェアデコード はハードウェアデコードのオン・オフを切り替え(再起動後に反映)、AI プロセッサ では AI 処理に使うものを自動・GPU・CPU から選びます。コンバーターでは、高速変換 › GPU アクセラレーション で H.264 と HEVC をグラフィックスカードでエンコードします。既定ではオフです。KwaFlux は、速いものの同じビットレートではソフトウェアエンコードより画質がやや下がると注記しており、私たちのテスト結果と一致します。各ファイルには GPU エンコード のバッジが表示され、GPU エンコーダーが起動できなかった場合は ソフトウェアエンコードに切替 のバッジになります。
ご自身のマシンを確認する方法
FFmpeg が使えるハードウェア経路を一覧表示します。
ffmpeg -hide_banner -hwaccelsソフトウェアとハードウェアのデコードで CPU 時間を比べます。-benchmark の行に、ユーザー(utime)、システム(stime)、経過(rtime)の時間が表示されます。
ffmpeg -hide_banner -benchmark -i input.mp4 -an -f null -ffmpeg -hide_banner -benchmark -hwaccel d3d11va -hwaccel_output_format d3d11 -i input.mp4 -an -f null -D3D12 経由で GPU で HEVC をエンコードし、同じ目標の x265 と比べます。
ffmpeg -hide_banner -loglevel error -y -init_hw_device d3d12va=gpu -filter_hw_device gpu -i input.mp4 -vf "format=nv12,hwupload" -c:v hevc_d3d12va -rc_mode VBR -b:v 4M -maxrate 6M -c:a copy gpu_hevc.mp4ffmpeg -hide_banner -loglevel error -y -i input.mp4 -c:v libx265 -preset medium -b:v 4M -c:a copy cpu_hevc.mp4次に、それぞれをソースと比べてスコアを出します。内蔵モデルを持たない FFmpeg のビルドもあるので、先に Netflix の VMAF リポジトリから vmaf_v0.6.1.json を同じフォルダーにダウンロードしておきます。
ffmpeg -hide_banner -i gpu_hevc.mp4 -i input.mp4 -lavfi "[0:v][1:v]libvmaf=model=path=vmaf_v0.6.1.json" -f null -似たビットレートでハードウェアエンコードのスコアがソフトウェアに近ければ、下書きや手早い共有にはそちらを使い、保存用にはソフトウェアエンコードを残してください。コーデック自体の選び方は H.264・H.265・AV1 の比較 をご覧ください。
よくあるトラブルと対処
| 問題 | 考えられる原因 | 対処 |
|---|---|---|
| ハードウェアデコードをオンにしてもソフトウェアでデコードされる | エンジンが対応していないコーデック、ビット深度、クロマ形式(4:2:2 や 4:4:4 が多い) | メーカーのサポートマトリクスを確認する。ソフトウェアデコードは引き続き使える |
| GPU でエンコードしたファイルが甘く見える | ハードウェアエンコーダーはビットの使い方の効率が低い | ビットレートを上げるか、最終版では GPU アクセラレーションをオフにする |
| GPU エンコードがソフトウェアに切り替わる | 非対応の形式、エンコーダーの使用中、ドライバーの問題 | グラフィックスドライバーを更新する。コンバーターで GPU エンコードされるのは H.264 と HEVC だけ |
| GPU が 2 つのノートパソコンでカクつく | フレームが内蔵 GPU と単体 GPU のあいだを行き来している | ディスプレイがつながっている GPU でアプリを動かすか、ドライバーを更新する |
| 画面が一瞬暗転して映像が戻る | Windows がグラフィックスドライバーをリセットした(TDR) | ドライバーを更新する。長い書き出し中はほかの GPU 負荷を減らす |
| ハードウェアデコードが速く感じない | このコーデックは CPU でも速くデコードできる | CPU 負荷を見る。利点は節約された CPU 時間にある |
できないこと
- ハードウェアデコードで映像がよくなることはありません。 デコーダーはソフトウェアと同じフレームを出力し、処理の場所が移るだけです。
- ハードウェアエンコードは、ビットあたりの画質では遅いソフトウェアのプリセットに勝てません。 勝るのは速さと電力効率です。
- すべてのコーデックを処理できる GPU はありません。 対応はチップの世代とドライバーで決まります。
- コピーレスな処理には相性のよいハードウェアが必要です。 2 つの API や 2 つの GPU がメモリを共有できない場合、フレームは遅い CPU の経路を通ります。
まとめ
ハードウェアのデコードとエンコードは、処理をどこで行うかの話です。CPU ではなく固定機能のエンジンで、できればフレームを GPU メモリから出さずに行います。作業を滑らかにしたいならハードウェアデコードをオンにし、効率の最後のひと押しより速さが大事なときは GPU エンコードを使い、どちらもご自身のマシンで測ってください。
KwaFlux は、コンバーターでもすべての AI モジュールでも、ご自身の GPU で動画をデコード、処理、エンコードします。メディアファイルが処理のためにアップロードされることはありません。Windows 10(64 ビット、バージョン 1809 以降)、Windows 11、Apple Silicon 搭載の macOS 12 以降で動きます。ファイルの読み込みやアプリの操作にアカウントは不要です。ログインと有料プランが必要なのは、書き出し、変換、ファイル修復、リンクからのファイルダウンロードだけです。
ご自身の素材で効果をテスト
KwaFlux を入手し、支払う前に自分の素材で効果を無料プレビュー。アカウント不要、処理はご自身の GPU で行い、メディアはアップロードしません。 動画のプレビューは 1、3、または5 秒、手ぶれ補正のプレビューは 5、15、または30 秒から選べます。
よくある質問
ハードウェアエンコードはソフトウェアエンコードより画質が悪い?
同じビットレートなら、たいていそうです。ハードウェアエンコーダーは効率より速さと電力を優先するので、同じ画質により多くのビットを必要とします。私たちのテストでは、GPU の HEVC エンコーダーは x265 と同じ VMAF スコアに 3.3 倍の速さで達しましたが、ビットは約 15% 多く使いました。
ハードウェアデコードで再生は速くなる?
場合によります。おもな利点は CPU 負荷の低さで、私たちの 4K H.264 のテストでは、ハードウェアデコードは同程度の速さで CPU 時間を約 95% 減らしました。重いコーデック、高解像度、CPU がほかの処理で忙しいときにもっとも効きます。
D3D11VA と NVDEC の違いは?
NVIDIA の GPU では、どちらも同じデコード用ハードウェアを使います。D3D11VA は Microsoft のメーカー非依存のインターフェイスでフレームを D3D11 テクスチャとして渡し、NVDEC は NVIDIA 独自のインターフェイスでフレームを CUDA の処理に渡します。アプリは、フレームの次の行き先で選びます。
内蔵グラフィックスでも動画のデコードとエンコードはできる?
できます。Intel の内蔵 GPU には Quick Sync Video があり、最近の AMD と Apple のチップにも独自の動画エンジンがあります。テストに使ったノートパソコンも、Iris Xe グラフィックスで 4K H.264 をデコードし、HEVC をエンコードしました。対応コーデックは世代によります。
4:2:2 のファイルがソフトウェアでデコードされるのはなぜ?
多くの一般向け動画エンジンは、配信用動画の大半が使う 4:2:0 しかデコードできず、4:2:2 への対応は一部の新しい世代でようやく加わったからです。ソフトウェアデコードは CPU の負担が大きくなりますが、引き続き使えます。形式については クロマサブサンプリングの解説 で扱っています。
参考資料
- NVIDIA, "NVIDIA Video Codec SDK" (hardware decoders and encoders separate from the CUDA cores; NVENC codecs; 4:2:2 encoding on Blackwell) (2026-10-22 閲覧)
- NVIDIA, "Video Encode and Decode GPU Support Matrix" (2026-10-22 閲覧)
- NVIDIA, CUDA Runtime API, "Direct3D 11 Interoperability" (2026-10-22 閲覧)
- Intel, "Intel Video Processing Library (Intel VPL)" (hardware decode, encode, and processing; VPL runtime for Iris Xe and newer, Media SDK for older graphics) (2026-10-22 閲覧)
- AMD GPUOpen, "Advanced Media Framework (AMF) SDK" (access to AMD video engines, compute shaders, and hardware accelerators) (2026-10-22 閲覧)
- Microsoft Learn, "Direct3D 11 Video APIs" (2026-10-22 閲覧)
- Microsoft Learn, "WDDM support for timeout detection and recovery" (TDR resets an unresponsive graphics card) (2026-10-22 閲覧)
- ONNX Runtime, "DirectML Execution Provider" (DirectML is a DirectX 12 library for machine learning across a broad range of hardware) (2026-10-22 閲覧)
- Khronos, "VK_KHR_external_memory_win32" reference page (2026-10-22 閲覧)
- Khronos OpenGL Registry, "WGL_NV_DX_interop2" (sharing Direct3D 10 and 11 resources with OpenGL) (2026-10-22 閲覧)
- Apple Developer, "Video Toolbox" (hardware-accelerated video encoding and decoding) (2026-10-22 閲覧)
- Apple Developer, "Metal" (graphics and compute on Apple GPUs) (2026-10-22 閲覧)
- Apple Newsroom, "Apple unleashes M1" (unified memory lets the chip's components access the same data without copying it between pools of memory) (2026-10-22 閲覧)
- Netflix, "VMAF" repository (vmaf_v0.6.1.json model) (2026-10-22 閲覧)
- FFmpeg documentation (`-hwaccel`, `-hwaccel_output_format`, `-init_hw_device`, `-benchmark`) (2026-10-22 閲覧)
Kw「KwaFlux の舞台裏」のほかの記事
続けて読む

KwaFlux のすべて:機能、対応環境、料金、アップデート
KwaFlux とは何か、何ができるか、どのシステムで動くか、何が無料で何が有料か、ライセンスの仕組み、各バージョンの変更点をまとめました。
Mac 版 KwaFlux:対応する Mac、セットアップ、パフォーマンスのコツ
KwaFlux が動く Mac、インストール方法、GPU アクセラレーションコンポーネントと標準モードの意味、Apple Silicon で処理を速く保つコツを解説します。
AI 動画高画質化を速くする方法:ワークフロー、設定、ハードウェア
AI 動画の高画質化が遅い理由と速くする方法を解説。処理する量を減らす、出力サイズを決める、手順の順番を整える、GPU とアプリの設定を見直す、の 4 点です。