一格畫面不必回家:KwaFlux 怎麼讓影片從解碼到編碼都留在顯示卡裡
一格 4K 10 位元畫面約 24.9 MB,每在記憶體和顯示卡之間搬一次都要時間。看 KwaFlux 怎麼用影格轉接層、三家顯示卡的硬體編解碼和五級互通,讓像素盡量不離開 GPU。
重點速覽
全流程 GPU 影片處理,是指一段影片從解碼、畫面處理、AI 推論到編碼,像素盡量一直留在顯示卡記憶體裡,不在系統記憶體和顯示卡之間來回搬運。搬得越少,匯出越快、預覽越順,CPU 也越清閒。
本文會說明 KwaFlux 的媒體引擎怎麼做到這件事:影格轉接層怎麼讓九種影格類型說同一種語言,Windows 上三家顯示卡的硬體編解碼怎麼評分挑選,D3D11 和 OpenGL 之間的五級互通階梯,Mac 上的 VideoToolbox 和 Metal,以及播放器怎麼把 HDR 送上螢幕。最後是一次匯出中像素的完整路線,和在 KwaFlux 裡能調的幾個設定。
- 一格 4K、10 位元、4:2:0 的畫面約 24.9 MB。每秒 60 格時,每在系統記憶體和顯示卡記憶體之間搬一趟,就是每秒約 1.5 GB 的資料。搬得越多,匯出越慢、預覽越卡。
- KwaFlux 的媒體引擎替每一格畫面發一張「身分證」:CUDA 指標、D3D11 紋理、Metal 紋理或系統記憶體,上層只認得「一格畫面」,需要換 API 時由引擎挑代價最低的橋。
- Windows 上,NVIDIA、Intel、AMD 以及系統層級 D3D11、D3D12 的硬體解碼與編碼都以外掛形式隨安裝檔提供,依顯示卡、顯示卡記憶體和解析度評分,一個失敗就換下一個,最後由軟體解碼接手。
- D3D11 紋理進入 OpenGL 有五級階梯:NVIDIA 零複製、AMD 與 Intel 近零複製、經 CUDA 兩段轉送、非同步傳輸、CPU 備援。快的電腦走上面,舊電腦走下面,畫面都不中斷。
- 它不是「每條路徑都零複製」:階梯的最後兩級要經過系統記憶體。全流程 GPU 的意思是盡量留在顯示卡上,留不住時逐級退回,而不是直接失敗。
為什麼像素「回家」很貴?
像素「回家」,指的是一格畫面從顯示卡記憶體複製回系統記憶體,處理完再傳回顯示卡。硬體解碼器把畫面解在顯示卡記憶體裡,AI 模型和畫質濾鏡也在顯示卡上執行,硬體編碼器同樣從顯示卡記憶體取畫面;中間只要有一個環節只認系統記憶體裡的像素,這格畫面就得跨 PCIe 走一個來回。
先算一格畫面有多大(4:2:0 取樣時,色度只佔亮度的一半):
| 格式 | 一格大小 | 每秒 30 格,每搬一趟 | 每秒 60 格,每搬一趟 |
|---|---|---|---|
| 1080p,8 位元 NV12 | 每格 3.1 MB | 每秒 93 MB | 每秒 187 MB |
| 4K,8 位元 NV12 | 每格 12.4 MB | 每秒 373 MB | 每秒 746 MB |
| 4K,10 位元 P010 | 每格 24.9 MB | 每秒 746 MB | 每秒 1.49 GB |
| 4K,RGBA 半精度浮點(AI 和 HDR 處理常用) | 每格 66.4 MB | 每秒 1.99 GB | 每秒 3.98 GB |
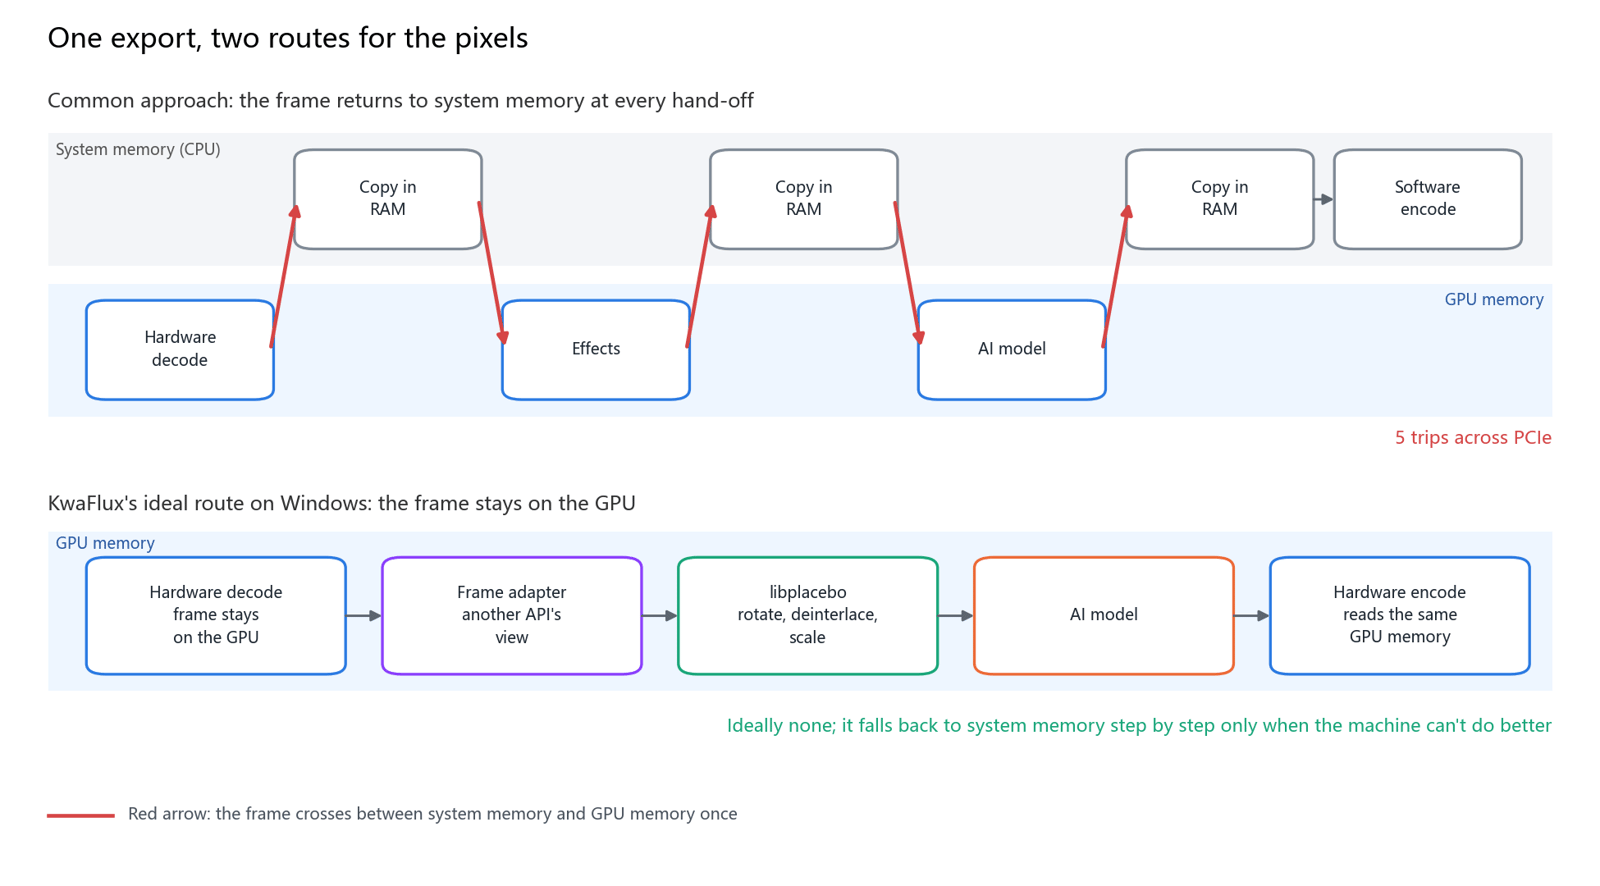
PCIe 4.0 x16 每個方向的理論頻寬約 31.5 GB/s。看起來夠用,但這只是理論峰值;每次搬運還要等 GPU 把手上的工作做完、等驅動程式完成同步,CPU 也得參與調度。下圖上半部是常見做法:解碼、特效、AI 處理、編碼各認各的記憶體,一次匯出中同一格畫面要跨 PCIe 五次;4K 10 位元、每秒 60 格的素材,光是搬運就約每秒 7.5 GB。
影格轉接層:九種影格身分,上層只認一格畫面
影格轉接層是 KwaFlux 媒體引擎中的一層介面,不管一格畫面實際存放在哪一種記憶體裡,對播放器、特效和編碼器來說都只是「一格畫面」。媒體軟體天生是方言區:FFmpeg 說 AVFrame,NVIDIA 說 CUDA 裝置指標,Intel 和 AMD 的硬體解碼交出 D3D11 紋理,Vulkan 說 VkImage,Apple 說 CVPixelBuffer。每一種的生命週期、記憶體對齊和色彩排列都不一樣。
| 畫面的身分 | 實際存放位置 | 由誰產生 |
|---|---|---|
| FFmpeg 影格 | 系統記憶體裡的 AVFrame | 軟體解碼,以及所有備援路徑 |
| D3D11 影格 | ID3D11Texture2D 紋理 | Windows 上 D3D11VA、Intel、AMD 的硬體解碼 |
| D3D12 影格 | D3D12 資源 | D3D12 影片解碼 |
| CUDA 影格 | CUDA 裝置指標 | NVIDIA 的 NVDEC 解碼,也是 NVENC 編碼的原生輸入 |
| OpenGL 影格 | 紋理或影格緩衝物件 | 濾鏡、預覽和跨平台繪製 |
| Vulkan 影格 | VkImage 影像 | Vulkan 影片解碼與繪製 |
| Metal 影格 | MTLTexture 紋理 | macOS 的畫面顯示與 HDR |
| CVPixel 影格 | CVPixelBuffer 緩衝區 | macOS 的 VideoToolbox 解碼 |
| OpenCV 影格 | cv::Mat 矩陣 | 需要直接讀取像素的演算法 |
上層只拿到統一的影格介面,需要另一種身分時說一聲「轉成我要的那種」,由引擎挑這台電腦上代價最低的橋。幾個設計細節讓它換到第三家廠商的顯示卡也不會散架:
- 型別在編譯時就確定。 跨介面查詢是一次靜態轉換,不依賴執行期型別資訊,在動態函式庫的邊界上不會互相打架。
- 只有真正擁有顯示卡資源的影格,才帶 GPU 操作。 複製、轉換、匯出成矩陣這些動作掛在具體的影格型別上,不堆在共用介面裡。
- 所有權寫清楚。 誰配置誰釋放,共用控制代碼不會重複釋放。顯示卡裝置重建時,依賴它的互通資源一起失效、一起重建,不會發生上一張顯示卡的紋理還掛在下一張顯示卡上的情況。
Windows:三家顯示卡的硬體解碼與編碼
在 Windows 上,KwaFlux 隨安裝檔提供八個影片解碼外掛和六個影片編碼外掛,每個都是獨立的動態函式庫。解多工之後,選擇器依設定挑選;設為自動時,它替每個候選外掛評分,分數高的先上,初始化失敗就換下一個,軟體解碼負責接住剩下的情況。
| 解碼外掛 | 產生的影格 | 支援的編碼 |
|---|---|---|
| NVIDIA 的 NVDEC | CUDA 影格,8 位元 NV12 或 10 位元 P016 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| D3D11VA(系統硬體解碼) | D3D11 NV12 紋理 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| D3D12VA 硬體解碼 | D3D12 資源 | H.264、HEVC、VP9 和 AV1 |
| Intel oneVPL(新一代 Intel 顯示卡) | D3D11 紋理 | H.264、HEVC、VP9、AV1 和 MJPEG |
| Intel Media SDK(第 5 到第 10 代 Core 內建顯示晶片) | D3D11 紋理 | H.264、HEVC、MPEG-2 和 MJPEG |
| AMD 的 AMF | D3D11 紋理,可直接包成 AMF 表面 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| Vulkan 影片介面 | Vulkan 影像 | H.264 和 HEVC |
| FFmpeg 軟體解碼 | 系統記憶體影格 | FFmpeg 能讀的全部格式,包括帶透明通道的 VP8、VP9 |
表格列的是外掛本身支援的編碼;你的顯示卡能不能硬體解碼某種編碼,還要看顯示卡的世代。例如 NVIDIA 的支援表顯示,消費級顯示卡從 RTX 30 系列開始才能硬體解碼 AV1。
評分看什麼。 廠商不符就直接出局:不是 NVIDIA 的顯示卡,NVDEC 得 0 分。顯示卡記憶體吃緊時硬體解碼會扣分,CPU 夠強時軟體解碼可以反超,不會為了「非硬解不可」把電腦拖垮。4K 替硬體解碼加分,那正是固定功能單元該上場的時候。打算用 D3D11 顯示畫面時,D3D11VA 加分;解碼和顯示放在不同的顯示卡上會產生跨卡複製,在評分裡是扣分項目。
編碼:解碼交出什麼,編碼就吃什麼。
| 編碼外掛 | 最順手的輸入 | 輸出編碼 |
|---|---|---|
| NVIDIA 的 NVENC | CUDA 影格;D3D11、D3D12、Vulkan、OpenGL 和系統記憶體影格也都能接 | H.264、HEVC 和 AV1 |
| Intel 的 oneVPL | 同一張顯示卡上的 D3D11 紋理,直接在顯示卡上複製 | H.264、HEVC、AV1、VP9 和 MJPEG |
| AMD 的 AMF | D3D11 紋理直接包成 AMF 表面,非同步取出封包 | H.264、HEVC 和 AV1 |
| Intel 的 Media SDK | D3D11 紋理或系統記憶體影格 | H.264、HEVC、MPEG-2 和 MJPEG |
| Vulkan 影片介面 | Vulkan 影格 | H.264 和 HEVC |
| FFmpeg 軟體編碼 | 系統記憶體影格 | 軟體編碼器支援的格式 |
NVENC 最能說明影格轉接層的價值:它不要求所有影格先變成 CUDA。CUDA 影格在顯示卡內做二維複製;D3D11 影格走互通;D3D12 先經 D3D11 再進 CUDA;Vulkan 走外部記憶體;OpenGL 走像素緩衝橋接;只有本來就在系統記憶體裡的影格,才上傳一次。HEVC 和 AV1 的 HDR 母版資訊與內容亮度寫進編碼器設定,H.264 沒有原生欄位,就手動寫進 SEI。
補充: NVIDIA 的支援表列出,具備編碼器的 GeForce 顯示卡最多同時開 12 個編碼工作階段。工作階段用完時,KwaFlux 的 NVENC 外掛會主動退出,把工作交給下一個編碼器,而不是編到一半才出錯。
外掛帶有版本檢查,不相符就不載入;能力偵測不必真正載入外掛就能評分。換一代顯示卡,加一個外掛即可,上層的播放器和轉檔器都不用改。
五級階梯:D3D11 紋理怎麼進入 OpenGL
解碼器和顯示用的圖形介面常常不是同一家:NVIDIA 解碼在 CUDA 或 D3D11,畫面卻要進 OpenGL;Intel 解碼在 D3D11,濾鏡卻在 OpenGL 紋理上執行。KwaFlux 的圖形核心負責搭橋,D3D11 和 OpenGL 之間是一條五級階梯,電腦能爬多高就爬多高:
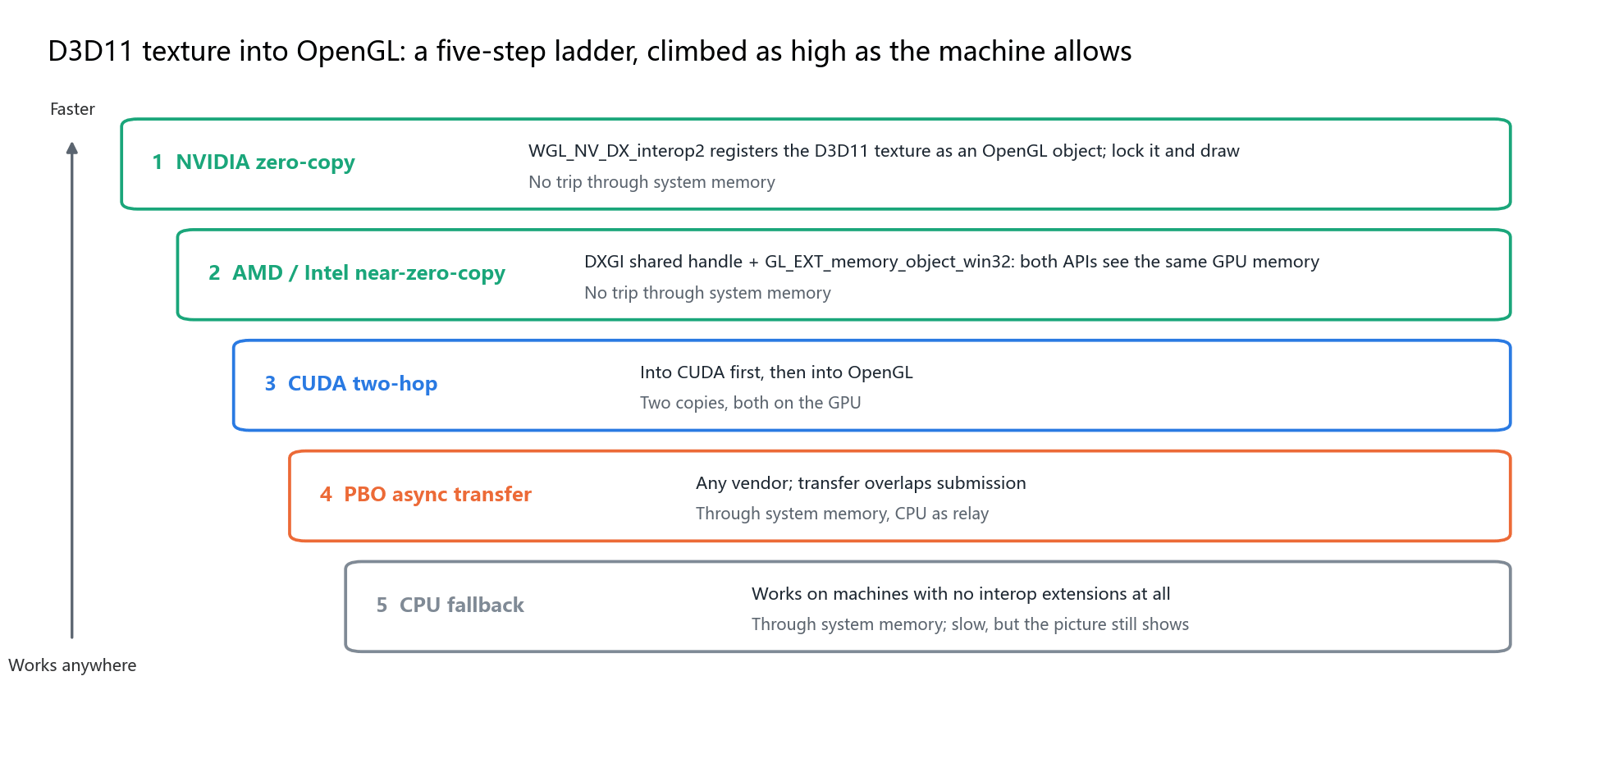
- NVIDIA 零複製。
WGL_NV_DX_interop2擴充功能把 D3D11 紋理註冊成 OpenGL 物件,鎖定後 OpenGL 直接讀寫,像素不經過系統記憶體。 - AMD 與 Intel 近零複製。 DXGI 共用控制代碼加上
GL_EXT_memory_object_win32擴充功能,兩套 API 看的是同一塊顯示卡記憶體。 - 經 CUDA 兩段轉送。 先進 CUDA,再進 OpenGL,兩次複製都在顯示卡上。
- 像素緩衝物件(PBO)非同步傳輸。 不挑廠商,傳輸和提交同時進行,CPU 只當中繼站。
- CPU 備援。 沒有任何互通擴充功能的電腦,畫面照樣出得來,只是比較慢。
階梯之外還有幾座專用的橋:CUDA 和 D3D11 互相註冊;D3D12 和 D3D11 透過 DXGI 共用控制代碼加柵欄同步,D3D12 因此不必替每種 API 各寫一條直連;Vulkan 和 D3D11 走外部記憶體。CUDA 端的色彩轉換核心直接編譯進函式庫,NV12、P016 轉 BGRA 都在顯示卡上完成,10 位元畫面可以保留在 16 位元 RGBA 裡,不會一進門就被砍成 8 位元。
Mac:VideoToolbox 解碼,Metal 上螢幕
在 macOS 上比的不是外掛清單有多長。Apple 把編解碼做進了晶片的媒體引擎,KwaFlux 把這具引擎接進同一套影格語言:
- 解碼 走 VideoToolbox,交出
CVPixelBuffer,包成 CVPixel 影格。支援 H.264、HEVC、VP9 以及 ProRes。 - 編碼 走
h264_videotoolbox、hevc_videotoolbox和prores_videotoolbox,ProRes 匯出同樣交給 VideoToolbox。 - 顯示 走 Metal。
CAMetalLayer先確認顯示器是否支援延伸動態範圍(EDR):支援的話,HDR 透過 EDR 顯示;不支援的話,用和 Windows 同一套數學的色調映射,把 PQ 或 HLG 轉成 SDR。
對播放器、特效和轉檔流程來說,Windows 上的 D3D11 紋理和 Mac 上的 CVPixelBuffer 都只是「一格畫面」,產品功能不必依作業系統寫兩套。
播放器:以音訊當時鐘,HDR 逐格切換
以音訊作為主時鐘。 人耳對聲音抖動的容忍度遠低於眼睛對畫面的容忍度,所以讓畫面追聲音,而不是讓聲音追畫面。時鐘在兩次音訊回呼之間依系統時間線性內插,再用指數移動平均抹平抖動;判斷門檻跟影格間隔成比例,而不是寫死一個毫秒數。每一格只有三種決定:等、畫、丟。丟掉的是來不及顯示的畫面,不是你的播放進度。
拖曳進度列會當成一次完整的交易(transaction)處理。 中斷解碼、清空過期的影格佇列、用世代編號把舊畫面擋在門外、時鐘歸位,直到新位置的畫面真正畫出來,音訊時鐘才重新開始計時。你看到的是目標位置,不是佇列裡還沒清掉的上一秒。
HDR 不是偵測到就整段開啟。 每一格看自己的傳遞特性:只有 PQ 和 HLG 才申請 HDR 交換鏈,下一段如果是 SDR,交換鏈就退回去,一般畫面不會被當成 PQ 訊號,顯示成一片灰。HLG 會在著色器裡轉成 PQ 再交給顯示器。
| 顯示後端 | 用途 | HDR 怎麼處理 |
|---|---|---|
| D3D11 介面 | Windows 的主要路徑 | 10 位元交換鏈,PQ 與 BT.2020 直通;顯示器不支援 HDR 時在著色器裡轉成 SDR |
| Vulkan 介面 | 新一代圖形路徑 | HDR10 表面,10 位元或半精度浮點 |
| Metal 介面 | macOS 系統 | CAMetalLayer 延伸動態範圍,同一套色調映射 |
| OpenGL 介面 | 各平台共用路徑 | 不做 HDR 直通,負責把 HDR 轉成 SDR |
一般顯示器上的 HDR。 四個後端共用同一套色調映射:PQ 或 HLG 先換算成以尼特計的實際亮度,轉到 IPT 色彩空間,查色調表和色域表,再輸出成 BT.709 和 sRGB。色調表跟著畫面峰值走,峰值用一張很小的離屏影像量測,讀回結果時不等待顯示卡,場景切換時平滑過渡。影片沒有寫母版亮度時,以 1,000 尼特起算,而不是隨手給一個好看的常數。字幕從 sRGB 進入 HDR 交換鏈時會提高到 PQ 的參考白,白字在亮畫面裡不會發灰。
對比播放把原始畫面和處理後的畫面分成兩路,分隔線兩側各自記錄亮度歷史:左邊是夜景,也不會讓右邊的白天畫面被映射得變暗。播放時,背景工作會讓出 GPU 資源,停止後再慢慢拿回來:即時畫面優先,匯出排隊。
libplacebo:縮放、色調映射與去色帶
libplacebo 是從 mpv 播放器拆出來的 GPU 畫質函式庫。KwaFlux 把它接成一個特效節點,依輸入的影格選擇後端:OpenGL 影格、軟體解碼影格、CUDA 影格和 CVPixel 影格走 OpenGL;D3D11 的 NV12 直接走 D3D11 後端,少一次色彩來回;Vulkan 影格留在 Vulkan。
- 放大用 EWA Lanczos,縮小用 Lanczos,要求速度時可改用雙線性;
- HDR 轉 SDR 可選 BT.2390、Reinhard、Spline、Hable 曲線,峰值可以跟著畫面量測;
- 去色帶、抖動、抗振鈴,讓漸層的天空不再一條一條;
- 去交錯使用前一格、目前這格和下一格組成的時間視窗,而不是每格單獨猜測;
- 預設分快速與高品質兩檔:預覽和編碼前縮放用快速,成品用高品質。
自動校正(旋轉、像素長寬比、交錯、色度位置)和編碼前縮放優先交給 libplacebo;超解析度改變了解析度時,縮放節點仍排在編碼之前,編碼器拿到的是目標尺寸。libplacebo 無法啟動時,改用 FFmpeg 的 scale、zscale 和 yadif 濾鏡,不會因為某個模組缺席就停擺。
一次匯出中,像素的理想路線
把上面幾段串起來,Windows 上的一次匯出是這樣的:
- 檔案解多工成封包,選擇器挑出這台電腦上合適的硬體解碼器;
- 影格以 CUDA 指標或 D3D11 紋理的身分誕生,而不是先在系統記憶體裡配置一塊空間;
- 需要旋轉、校正長寬比、去交錯,或交付 SDR 版本要做色調映射時,由 libplacebo 在顯示卡上完成;
- AI 模型(超解析度、畫質修復、SDR 轉 HDR 等)在顯示卡上逐格處理,影格的型別可以改變,上層不必知道它中途換過哪座橋;
- 解析度需要對齊目標時,再做一次快速縮放;
- 編碼器依自己的習慣接收影格:NVENC 接 CUDA,oneVPL 和 AMF 接 D3D11;
- 封包進入多工器,時間戳記排好,寫出檔案。
一句話總結:硬體解碼留下紋理,互通讓另一套 API 看見它,畫質處理留在顯示卡上,硬體編碼直接從同一塊顯示卡記憶體讀取畫面、輸出位元流。系統記憶體會出現,只是因為這台電腦沒有更高一級的橋,或某一步演算法確實需要讀取 CPU 上的像素。那是降級,不是設計的核心。
在 Mac 上,是同一句話的另一種說法:VideoToolbox 在媒體引擎裡解碼,影格以 CVPixelBuffer 進入流程,Metal 透過 EDR 把 HDR 送上螢幕,ProRes 和 HEVC 匯出再回到 VideoToolbox。
分段平行匯出會把時間軸切成好幾段,每一段走的仍是這條流程,而不是另寫一套「為了快所以略過色彩處理」的捷徑。
在 KwaFlux 裡能調什麼
這些大多是自動的,下面幾個設定會影響它怎麼走:
- 硬體加速解碼(設定 › 效能):可選 自動(預設)、啟用 和 停用。某個檔案解碼出現花屏或錯誤時,改成停用,用軟體解碼排查。重新啟動應用程式後生效。
- AI 處理器(設定 › 效能):選擇 AI 處理使用 GPU,或交給應用程式自動決定。GPU 通常比較快,下次匯出、預覽或產生遮罩時生效。
- AI 匯出資源佔用:低佔用(只跑一路,多張顯示卡時只用其中一張)、均衡(預設)、全速,以及 自訂(指定使用哪幾張顯示卡、每張最多跑幾路)。調低會立即套用到正在匯出的工作,已完成的片段不會遺失。
問題排解
| 問題 | 可能原因 | 解決方法 |
|---|---|---|
| 某個檔案預覽出現花屏或綠畫面 | 這張顯示卡的硬體解碼器對這種編碼變體支援不完整 | 把硬體加速解碼改成停用,重新啟動後改用軟體解碼 |
| 播放 HDR 時 SDR 段落發灰 | 播放器沒有逐格切換顯示模式,或檔案標籤錯誤 | 用 ffprobe 檢查每一段的傳遞特性標籤 |
| 匯出時 CPU 很忙、顯示卡很閒 | 路徑退到了經過系統記憶體的那幾級,或某個濾鏡只能在 CPU 上執行 | 更新顯示卡驅動程式;檢查是否用了只能在 CPU 上處理的設定 |
| 平行匯出時 NVIDIA 編碼回報工作階段不足 | 同時進行的編碼工作階段超過驅動程式上限 | 減少平行工作,或把資源佔用調成低佔用或均衡 |
| 雙顯示卡筆電匯出很慢 | 解碼和顯示在不同顯示卡上,產生跨卡複製 | 在系統的圖形設定裡讓 KwaFlux 使用獨立顯示卡 |
這套架構做不到的事
- 不是每條路徑都零複製。 五級階梯的第 4、5 級要經過系統記憶體,舊顯示卡和缺少互通擴充功能的驅動程式會走到這裡。
- 不重現杜比視界。 HDR 方面站得住的是靜態 HDR10 和 HLG。
- Mac 上沒有和 Windows 相同的全面互通。 Mac 的強項是 VideoToolbox、ProRes、CVPixel 影格和 Metal EDR,而不是和 Windows 一樣多的互通橋。
- 不提供加速倍數。 少搬幾次能快多少,取決於你的顯示卡、驅動程式、解析度和處理步驟,請用自己的素材預覽並實測。
結語
全流程 GPU 不是一句口號,而是一張能降級的路由表:快的電腦讓像素一路留在顯示卡上,慢的電腦也能逐級退回,把工作做完。下次匯出時看一眼顯示卡和 CPU 的使用率,就知道你的像素走了哪條路。
用你自己的真實素材實測效果
KwaFlux 在你自己的 GPU 上執行格式轉檔和所有 AI 工具,解碼、處理和編碼盡量都在顯示卡上完成。AI 處理在你自己的 GPU 上執行,媒體檔案不會為了處理而上傳。可在 Windows 10(64 位元,1809 或更新版本)、Windows 11,以及搭載 Apple Silicon 的 macOS 12 或更新版本上執行。預覽不需要帳號:任何片段都能渲染 1、3 或 5 秒的預覽。僅在匯出、轉換、檔案修復和從連結下載檔案時需要登入並購買付費方案。
用你自己的真實素材實測效果
下載 KwaFlux,付費前先在自己的素材上免費預覽效果——無需註冊,在你的 GPU 上處理,媒體檔案不上傳。 影片預覽可選 1、3或5 秒;防抖預覽可選 5、15或30 秒。
常見問題
零複製是什麼意思?
零複製是指兩個元件共用同一塊記憶體,交接時只交出存取權,不複製像素。例如 NVIDIA 的 WGL_NV_DX_interop2 擴充功能能把 D3D11 紋理直接註冊成 OpenGL 物件,OpenGL 鎖定後就能讀寫,畫面不經過系統記憶體。
多裝一張顯示卡,匯出會比較快嗎?
有可能。軟體把時間軸切成幾段、分給兩張顯示卡平行處理時,第二張顯示卡才派得上用場。單一路處理用不到它;如果一張顯示卡負責解碼、另一張負責顯示,還會多出跨卡複製,反而更花時間。
消費級 NVIDIA 顯示卡同時能開幾路硬體編碼?
依 NVIDIA 目前的支援表,具備編碼器的 GeForce 顯示卡最多同時 12 路,專業卡和資料中心卡大多沒有限制。超過上限再開新的編碼工作會失敗,所以同時匯出多個檔案時要留意。
硬體解碼比軟體解碼好嗎?
未必。顯示卡記憶體吃緊、編碼格式太新或檔案參數特殊時,硬體解碼可能失敗或花屏;CPU 夠強時,軟體解碼也不慢。合理的設計是兩者都保留、依情況選擇,硬體解不了就退回軟體解碼。
為什麼開了硬體加速,匯出還是很慢?
通常是因為瓶頸不在解碼。AI 推論、濾鏡和編碼同樣耗時,任何一步退回系統記憶體,都會讓整條流程停下來等搬運。先看是哪一段在等:顯示卡使用率低、CPU 使用率高,多半是有環節退回了 CPU。請見本機與雲端 AI 影片處理。
參考資料
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (2026-10-22 查閱)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (2026-10-22 查閱)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (2026-10-22 查閱)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (2026-10-22 查閱)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (2026-10-22 查閱)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (2026-10-22 查閱)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (2026-10-22 查閱)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (2026-10-22 查閱)
KwKwaFlux 幕後 的更多文章