AI 修复为什么有塑料感:损失函数、GAN、扩散模型,以及怎样避免
AI 修复的视频为什么像打了蜡:细节被平均掉、GAN 编造纹理、扩散模型偏离原片、训练数据与素材不匹配,以及怎样发现和避免。
要点速览
AI 修复出现塑料感,是因为模型去掉真实纹理的速度超过了它重建纹理的能力。皮肤变得像打了蜡,头发结成一缕一缕,颗粒和树叶被抹成光滑的色块,画面看起来干净却不真实。原因其实很清楚:训练用的损失函数、模型类型,以及和素材不匹配的训练数据。
- 所谓“塑料感”,是修复把细微纹理(毛孔、发丝、颗粒、树叶)平均掉了,或者换成了与场景对不上的编造纹理。
- 只按像素误差(L1 或 L2)训练的模型,预测的是所有合理答案的平均值,而平均值往往偏平滑。GAN 和扩散模型会把纹理补回来,但其中一部分是编出来的。
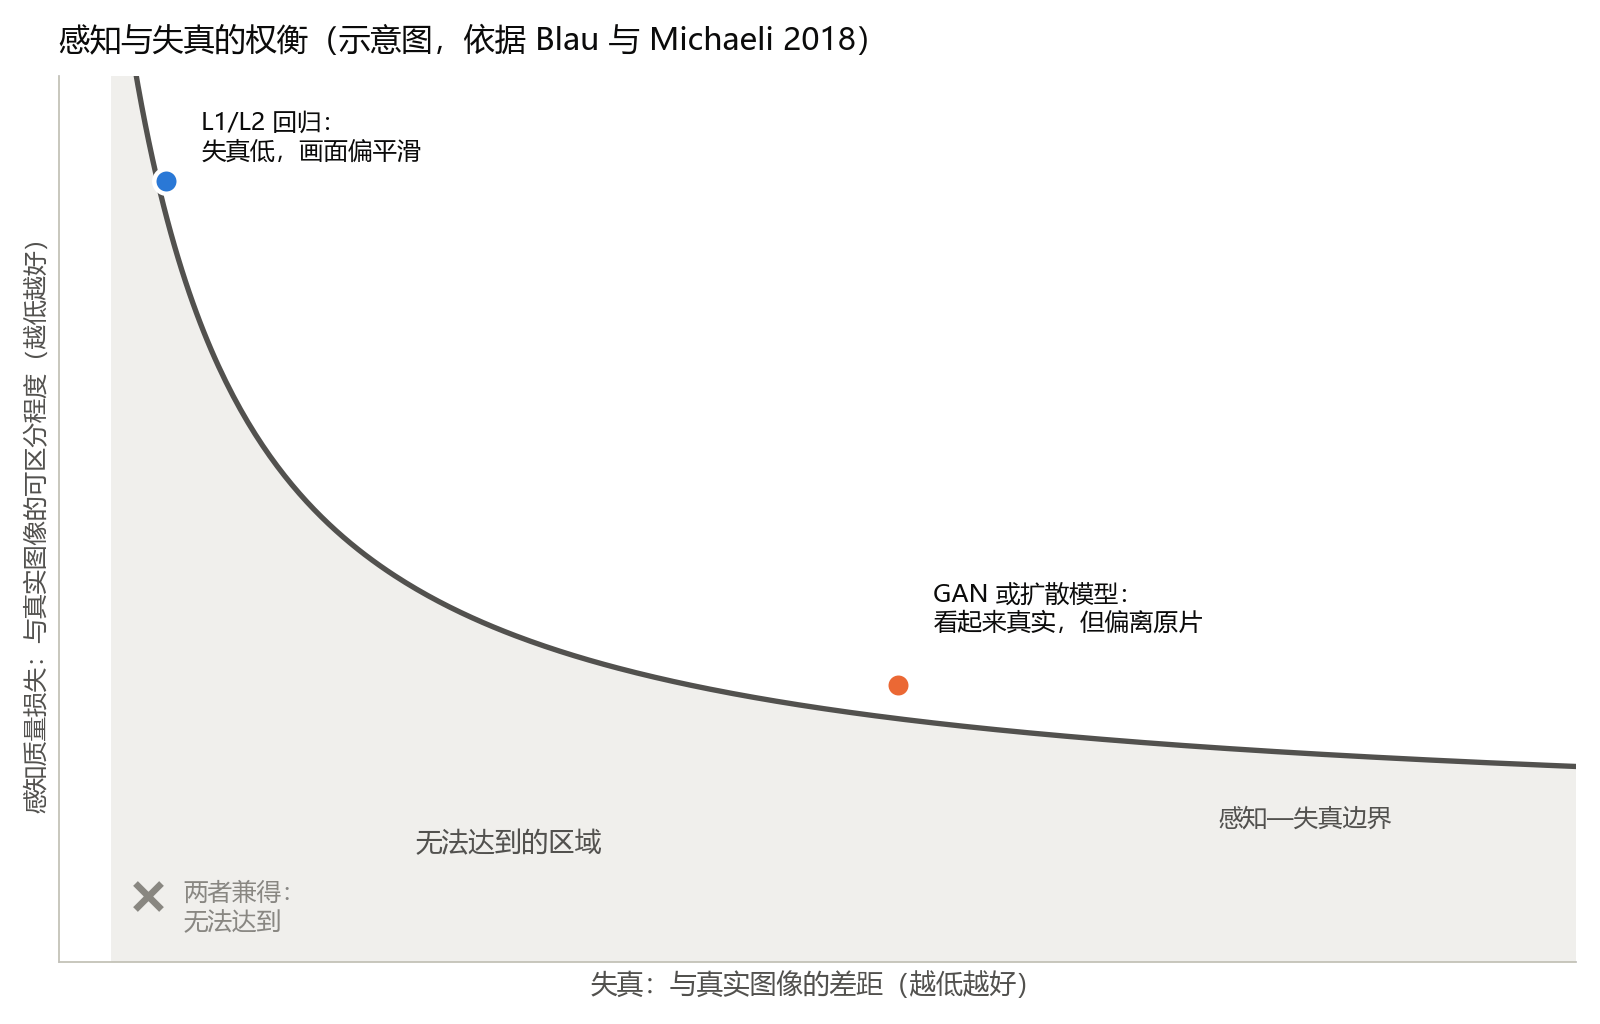
- Blau 和 Michaeli 证明了:无论用哪种失真度量,低失真和高真实感都是相互拉扯的,所以单靠一个分数判断不了哪个结果看着对。
- 另外两大原因是:训练数据和你的素材不匹配,以及人脸先验把人往“大众脸”上拉。
- 在 100% 缩放下、在播放状态下判断;降低强度或与原片混合;保留颗粒或事后补回;先修复再放大。
AI 修复里的“塑料感”指什么?
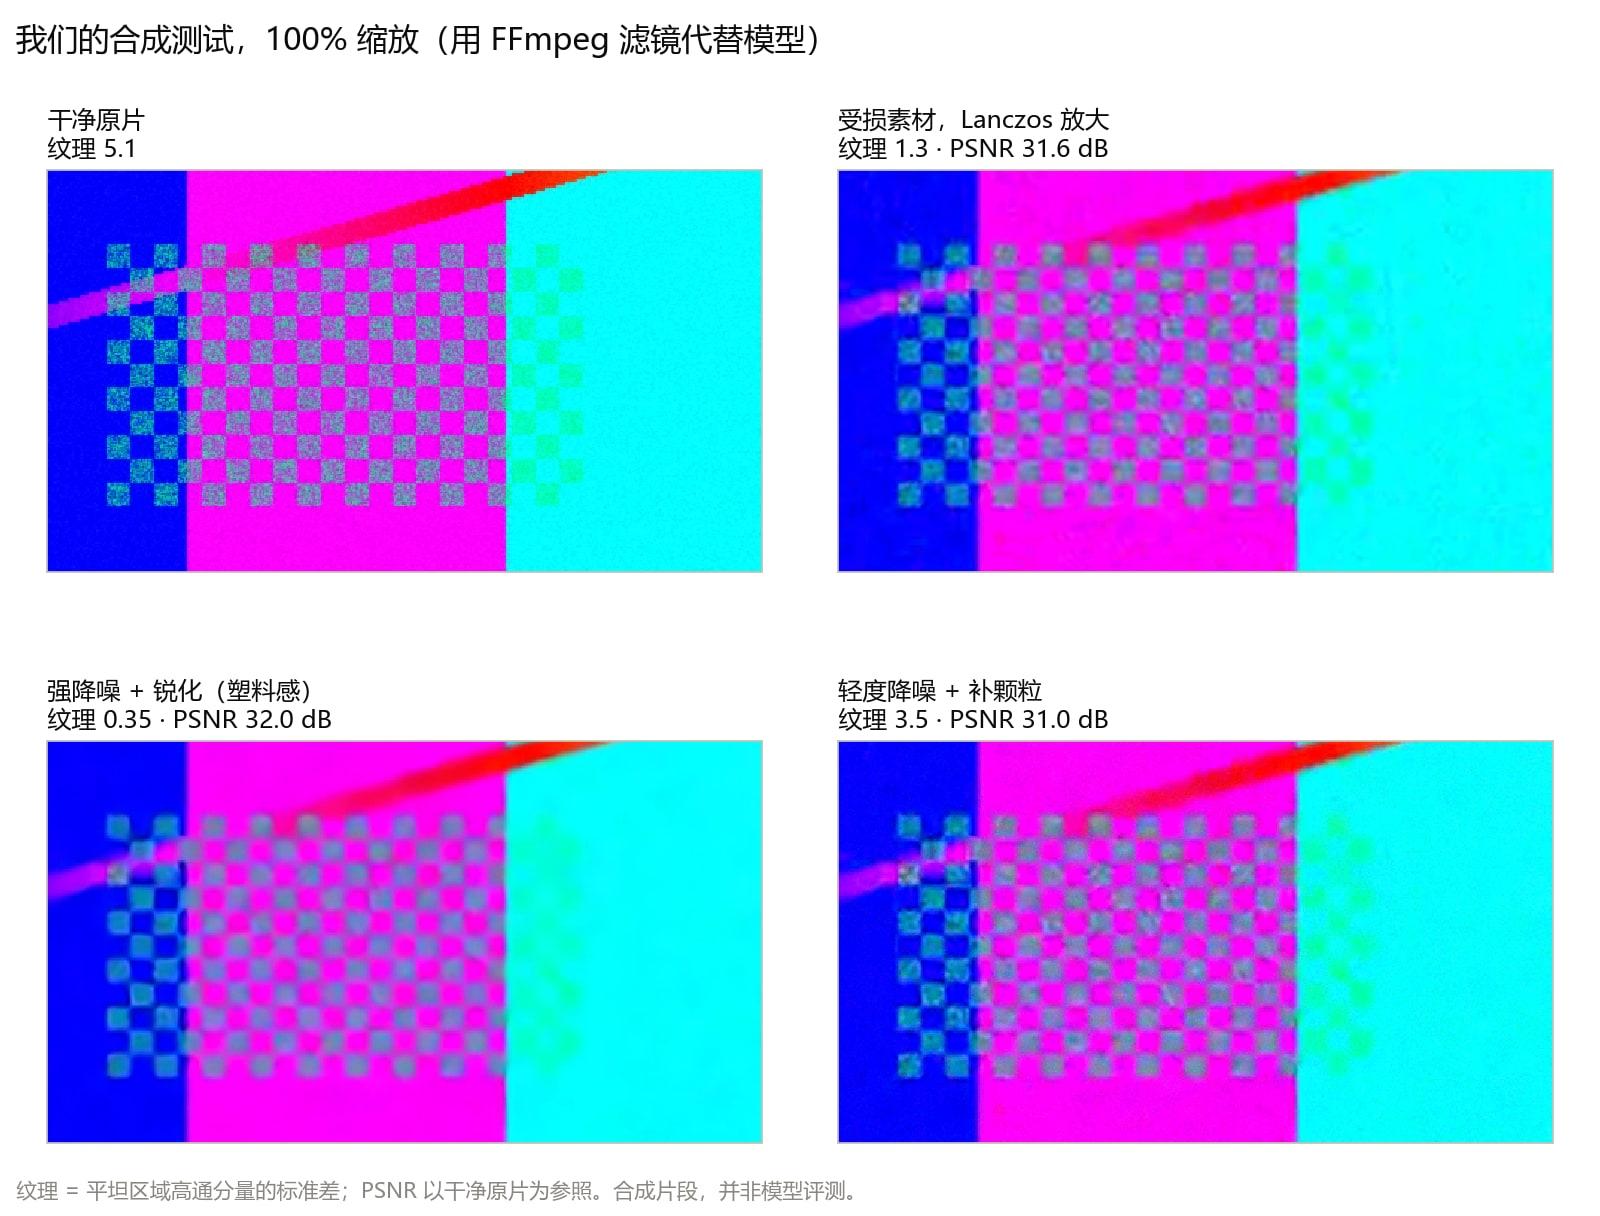
塑料感指修复后的画面表面比真实场景更光滑、更均匀,皮肤、布料、头发和树叶失去了让它们显得有质感的细小不规则纹理。它常常伴随着清晰的轮廓:在下文的 FFmpeg 测试里,强降噪加锐化之后,棋盘格的边缘依然很硬,格子之间的细纹理却没了。清晰的边界包着光滑的填充,人眼看到的就是蜡像或 CG 的感觉。
各类模型分别会怎样出问题
| 模型类型 | 训练依据 | 用力过猛时的典型问题 | 代表方法 |
|---|---|---|---|
| CNN 回归 | 像素损失(L1、L2 即 MSE) | 纹理被平均得过于平滑 | SRGAN 之前以 MSE 训练的网络 |
| GAN 模型 | 像素损失、感知损失和对抗损失 | 编造纹理,产生伪影 | SRGAN、Real-ESRGAN 等 |
| Transformer 模型 | 同样的损失,加上远距离注意力 | 取决于它用的损失函数 | SwinIR、Restormer 等 |
| 循环视频模型 | 来自多帧、对齐后的特征 | 对齐失败处出现拖影或重影 | BasicVSR++ 等 |
| 扩散模型 | 从学到的图像或视频先验逐步去噪 | 细节偏离原片、闪烁、算力开销大 | Upscale-A-Video、STAR、SeedVR2 等 |
用 L1 或 L2 损失训练的 CNN 回归
一个退化后的像素,可能对应很多种清晰的原貌:边缘可能偏左一个像素,也可能偏右一个像素;一块皮肤上的毛孔可以有无数种排列。用 L2(MSE)损失训练的网络,预测这些可能性的平均值会得到奖励,而许多清晰、位置各异的纹理平均下来,就是一片平滑。L1 预测的是中位数,对边缘有帮助,但位置不确定的纹理照样会相互抵消。SRGAN 的作者说得很直接:以 MSE 为优化目标的结果往往缺少高频细节,观感上不令人满意。
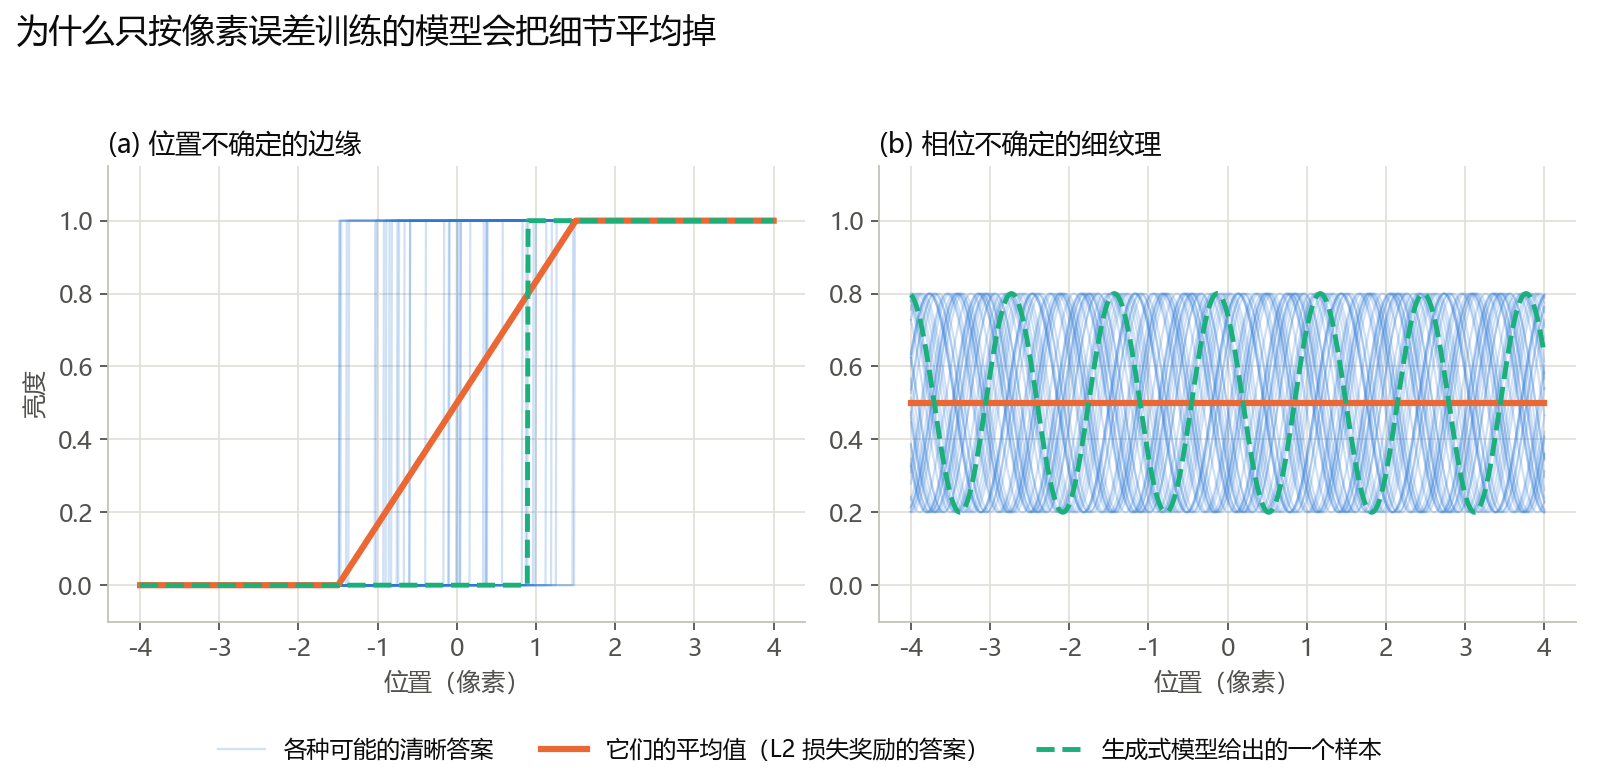
GAN:靠对抗损失生成纹理
SRGAN 加入了一个判别器,学习区分修复结果和真实照片,再配上基于感知相似度而非像素的内容损失;作者把这种效果描述为把结果推向自然图像流形。输出看起来更清晰,但纹理是为了“看着合理”生成的,并不是找回来的。生成器拿不准的时候,也得画出点像纹理的东西,编造的图案和发脆的边缘就是这么来的。Real-ESRGAN 只用合成数据训练,还模拟了真实素材里常见的振铃和过冲,好让模型学会去掉它们。
Transformer 与循环视频模型
SwinIR 和 Restormer 这类 Transformer 用注意力取代卷积,能捕捉远距离的像素关系;Restormer 指出,标准注意力的计算量随分辨率呈平方增长,所以修复用的 Transformer 会采用更高效的注意力设计。有没有塑料感,并不由架构本身决定,而是由损失函数决定。视频方面,BasicVSR++ 这类循环模型借助光流引导的可变形对齐,在片段里前后传播特征,让每一帧能从相邻帧借来真实细节,而不是自己编。在快速运动或遮挡处,对齐一旦失败,借来的细节就会拖影或重影。
扩散修复
扩散模型从学到的先验出发逐步去噪来修复画面,生成的细节最有说服力。这个长处同时也是风险所在。Upscale-A-Video 的作者指出,扩散采样的随机性让时间一致性很难保持,因此他们提供了噪声强度,用来在修复和生成之间取舍。STAR 指出,用静态图片训练的图像扩散模型难以保持时间一致性,大型生成主干也可能削弱保真度。另一个限制是开销:SeedVR2 的作者称扩散式视频修复的推理开销高得难以承受,所以他们把它蒸馏成了单步。
感知与失真的权衡
Blau 和 Michaeli 证明,失真(输出与真实图像的差距)和感知质量(输出与真实图像的难以区分程度)是相互冲突的:平均失真越低,输出就越容易被分辨出不是真实图像。这一结论对任何失真度量都成立,不只是 PSNR 或 SSIM;作者还说明,GAN 提供了一条逼近这条边界的有理论依据的路径。
我们在合成素材上复现了这个现象。把一段带细纹理的测试片段降到一半分辨率,加噪点,再做重度压缩,然后用 FFmpeg 滤镜代替模型,以两种方式“修复”:一种是强降噪加锐化,另一种是轻度降噪后补回颗粒。以干净原片为参照打分:
| 版本 | 细纹理(我们的高通测量值) | 与干净原片的 PSNR | 与干净原片的 SSIM |
|---|---|---|---|
| 干净原片 | 测得 5.1 | 作为参照 | 作为参照 |
| 受损素材,只做 Lanczos 放大 | 测得 1.3 | 约 31.6 dB | 约 0.700 |
| 强降噪加锐化 | 测得 0.35 | 约 32.0 dB | 约 0.721 |
| 轻度降噪,补回颗粒 | 测得 3.5 | 约 31.0 dB | 约 0.651 |
过度平滑的版本在两项像素指标上都得分最高,纹理却只剩原片的十五分之一左右;补颗粒的版本保留了大部分纹理能量,得分反而最低,因为随机颗粒不可能和原来的图案逐像素对上。手里有干净参照时(比如为了测试参数,故意把一段素材弄坏),一条命令就能测出来:
ffmpeg -i restored.mp4 -i reference.mp4 -lavfi "[0:v][1:v]psnr" -f null -指标适合用来发现大幅改写,而不是给观感排名;我们怎样给画质打分解释了为什么相似度分数衡量的是改动大小,而不是画质提升。
退化不匹配与身份漂移
退化不匹配。 模型只能修复它学过的损伤。Real-ESRGAN 的办法是构建高阶退化模型,把模糊、缩放、噪点和压缩反复串起来,因为真实的损伤远比简单的降采样复杂。如果素材里有训练集之外的损伤,比如隔行残留、严重的色度噪点、少见的压缩方式或胶片颗粒,模型可能把它当成细节去锐化,也可能当成噪点,连同纹理一起抹掉。
人脸身份漂移。 人脸修复模型带有很强的先验:GFPGAN 借助预训练的人脸 GAN,CodeFormer 则从学到的五官码本里预测条目。两篇论文都把结果描述为画质与保真度之间的平衡,CodeFormer 还把这个取舍做成了可调的控制项。先验越强,又小又糊的脸就越会被拉向一张“合理的平均脸”:皮肤光滑、牙齿整齐、眼睛千篇一律。该检查什么,见怎样修复视频里的人脸。
2026 年的变化
- 单步扩散。 蒸馏和对抗式后训练把扩散修复压缩到了一步;SeedVR2 报告的效果与多步方法相当,甚至更好。推理变便宜,长片段也能用上扩散式的细节,但保真度的问题依然存在。
- 时间先验。 新的视频超分不再逐帧套用图像模型,而是使用视频先验:Upscale-A-Video 用时间层和循环潜变量传播,STAR 用文生视频主干。
- 端侧 NPU。 微软的 Copilot+ PC 指南介绍,这类 NPU 每秒运算超过 40 万亿次,并指出很多 NPU 运行 INT8 这类整数运算,所以模型要转换成低精度格式才能在上面运行。
怎样识别塑料感
| 在 100% 缩放下看哪里 | 塑料感的迹象 | 自然的迹象 |
|---|---|---|
| 皮肤 | 均匀、没有毛孔、高光像蜡 | 脸颊和鼻子上有毛孔和细微变化 |
| 头发 | 结成一缕缕,或像画上去的纹理 | 发丝分明,边缘逐渐变细 |
| 文字和标志 | 字母被重画成错误的形状 | 形状与原片一致,哪怕有点软 |
| 树叶和碎石 | 糊成一团,或出现重复图案 | 不规则的细节,在画面里各处不同 |
| 天空、墙面等平坦区域 | 出现平滑色带,或多出原本没有的纹理 | 颗粒或噪点和原片相近 |
| 运动画面 | 纹理游移或闪动 | 细节随物体一起移动 |
拿原片和结果的同一处裁切对比。原片用最近邻缩放,这样看到的是它真实的像素:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor,crop=480:270:760:400[a];[1:v]crop=480:270:760:400[b];[a][b]hstack" -frames:v 1 compare.png差异图能显示修复去掉了什么、又加了什么。中灰表示没变;平坦区域出现结构,说明噪点或纹理被去掉了;出现新的图案,说明有编造的细节:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=bicubic,format=gray[a];[1:v]format=gray[b];[b][a]blend=all_mode=grainextract,eq=contrast=4" -frames:v 1 diff.png在我们的测试里,过度平滑版本的差异图显示:平坦区域里原片的噪点和压缩方块,以及棋盘格区域的纹理,全都被去掉了。
怎样避免
方法 1:降低强度,或与原片混合。 很多修复工具都提供强度或保真度控制,比如 CodeFormer 的保真度取舍、Upscale-A-Video 的噪声强度;用能解决问题的最低档就好。如果工具没有这类控制,就把它的输出和原片混合:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=lanczos,format=yuv420p[a];[1:v]format=yuv420p[b];[b][a]blend=all_expr='A*0.7+B*0.3'" -c:v libx264 -crf 16 -c:a copy blended.mp4这条命令保留 70% 的修复结果和 30% 放大后的原片。在我们的测试里,混合找回了一点纹理(按我们的测量是 0.63,原来是 0.35),也带回了一些原片噪点,所以适合轻微的情况。
方法 2:保留颗粒,或最后补回。 颗粒能盖住蜡像感,也给编码器留下可以保留的纹理。只在亮度上加细小的时间颗粒,并让 x264 针对颗粒做调整:
ffmpeg -i restored.mp4 -vf "noise=c0s=6:c0f=t" -c:v libx264 -crf 16 -tune grain -c:a copy regrained.mp4c0s=6 设置亮度噪点强度,c0f=t 让颗粒每帧变化;x264 的 grain 调优会降低去块强度和量化死区,让细颗粒挺过编码。在我们的测试里,纹理测量值从 0.35 升到 3.5,干净原片是 5.1。这是新加的颗粒,不是找回的细节。先分清颗粒和噪点,见颗粒、噪点与压缩伪影的区别。
方法 3:先修复,再放大。 在原始分辨率下去掉压缩方块和噪点,然后再放大。放大器如果把方块和噪点当成细节,就会把它们放大并锐化。
方法 4:在播放状态下判断。 纹理闪动在静帧上看不出来。把原片和结果按原始帧率左右并排,在 100% 缩放下观看:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor[a];[a][1:v]hstack" -c:v libx264 -crf 16 side_by_side.mp4技巧: 先看人脸、文字和树叶。这些地方的编造细节最容易看出来,也最说不过去。
KwaFlux 怎样处理
- 智能修复会参考相邻帧。 在 AI 画质修复 里,智能修复 会先检查片段,再把降噪、锐化、色彩与亮度校正、放大,以及人脸和细节修复组合起来。它参考相邻帧工作,属于上文所说的多帧修复。
- 场景修复的类型逐帧处理。 动漫、夜景、去雾、去雨、上色 和 胶片去噪 各自针对一种损伤。把场景类型用在不对路的素材上,是人脸出现蜡像感的常见原因;怎么选见该选哪种修复类型。
- 导出前先预览。 渲染 1、3 或 5 秒的预览。AI 预览默认最高 15 fps,判断运动或闪动前,先选 跟随源帧率。
- 把相似度分数当成提示。 打开 预览后自动画质对比 后,每次预览都会给出包括 与原片接近程度 (VMAF) 在内的分数,软件自己的说明是“数值高表示改动小,并非画质更好”。分数骤降说明改写幅度大,值得在 100% 缩放下检查。
- 保留你想要的颗粒。 胶片去噪 本来就是用来去颗粒的。如果颗粒是画面风格的一部分,就别用它;导出后如果画面显得太干净,可以用上面的 FFmpeg 命令补回颗粒。
问题排查
| 问题 | 可能原因 | 解决办法 |
|---|---|---|
| 皮肤像蜡、没有毛孔 | 降噪太强,或属于回归式结果 | 降低强度、与原片混合、补一点细颗粒 |
| 头发变成画出来的一缕缕 | 生成式先验编造了纹理 | 降低强度,并与原片裁切对比 |
| 字母变了形 | 模型重画了它看不清的文字 | 这部分保留原片;原本看不清的字找不回来 |
| 纹理游移或闪动 | 逐帧编造,缺少时间一致性 | 改用多帧修复,并按原始帧率判断 |
| 噪点被锐化成发脆的细节 | 模型没学过这种损伤 | 先降噪或去块,再放大 |
| 人脸像换了一个人 | 强人脸先验作用在又小又糊的脸上 | 降低人脸修复强度,在 100% 缩放下检查长相 |
这些方法做不到的事
- 任何修复都找不回摄像机没拍到的细节。 它预测的只是合理的细节。
- 没有哪个设置适合所有镜头。 纹理丰富的画面和平面图形,出问题的方向正好相反。
- 指标挑不出看着自然的结果。 像素分数偏爱平滑,最后得靠你的眼睛判断。
- 补颗粒并不能恢复纹理。 它只是盖住了蜡像感。
结语
AI 修复出现塑料感,要么是平均压过了纹理,要么是编造的纹理和场景对不上。选择保真度更高的设置,在 100% 缩放和播放状态下对比,把干净却没有纹理的画面当作警告,而不是成果。
KwaFlux 在你自己的 GPU 上运行AI 画质修复。AI 处理在你自己的 GPU 上运行,媒体文件不会为了处理而上传。可在 Windows 10(64 位,1809 或更新版本)、Windows 11,以及搭载 Apple Silicon 的 macOS 12 或更新版本上运行。预览不需要账号:任意片段都能渲染 1、3 或 5 秒的预览。仅在导出、转换、文件修复和从链接下载文件时需要登录并购买付费方案。
用你自己的真实素材实测效果
下载 KwaFlux,付费前先在自己的素材上免费预览效果——无需注册,在你的 GPU 上处理,媒体文件不上传。 视频预览可选 1、3或5 秒;防抖预览可选 5、15或30 秒。
常见问题
PSNR 或 SSIM 分数越高,修复效果就越好吗?
不一定。像素指标奖励的是平均意义上接近参照的输出,而平均值偏平滑。在我们的合成测试里,过度平滑的结果在 PSNR 和 SSIM 上都胜过了颗粒更多、更自然的结果。把分数当作发现大幅改动的工具;原因见我们怎样给画质打分。
修复视频时,扩散模型比 GAN 强吗?
要看情况。扩散模型生成的细节通常更有说服力,但运行开销更大,也可能偏离原片或在帧与帧之间闪烁。GAN 更快,但用力过猛时会编造纹理。对视频来说,时间一致性和细节同样重要。
加胶片颗粒能消除塑料感吗?
部分可以。细颗粒能盖住蜡像般的表面,也给编码器留下可保留的纹理,但它是新加的随机纹理,不是找回的细节,修不了变形的轮廓或变了样的人脸。颗粒要放在最后、所有缩放之后再加。
为什么修复出来的细节在播放时会闪动?
因为逐帧单独重建的模型,每一帧编出的纹理都略有不同,人眼就把这些变化看成了闪动或游移。从对齐好的相邻帧借细节的多帧模型能减轻这种现象,所以要按原始帧率判断。
为什么有噪点的视频放大后反而更难看?
因为放大器如果把噪点或压缩方块误当成细节,就会连同画面一起把它们放大并锐化。应该先在原始分辨率下清理画面,再放大,需要颗粒的话最后再加。
参考资料
- Blau and Michaeli, "The Perception-Distortion Tradeoff," CVPR 2018 (distortion and perceptual quality are at odds for any distortion measure) (2026-10-21 查阅)
- Ledig et al., "Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (MSE results lack high-frequency detail; adversarial and content losses) (2026-10-21 查阅)
- Wang et al., "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data" (high-order degradation model, ringing and overshoot) (2026-10-21 查阅)
- Liang et al., "SwinIR: Image Restoration Using Swin Transformer" (2026-10-21 查阅)
- Zamir et al., "Restormer: Efficient Transformer for High-Resolution Image Restoration" (long-range interactions, quadratic cost) (2026-10-21 查阅)
- Chan et al., "BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment" (2026-10-21 查阅)
- Wang et al., "Towards Real-World Blind Face Restoration with Generative Facial Prior" (GFP-GAN; realness and fidelity) (2026-10-21 查阅)
- Zhou et al., "Towards Robust Blind Face Restoration with Codebook Lookup Transformer" (CodeFormer; controllable fidelity and quality) (2026-10-21 查阅)
- Zhou et al., "Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution" (temporal consistency, noise levels) (2026-10-21 查阅)
- Xie et al., "STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution" (image diffusion and temporal consistency) (2026-10-21 查阅)
- Wang et al., "SeedVR2: One-Step Video Restoration via Diffusion Adversarial Post-Training" (one-step restoration, inference cost) (2026-10-21 查阅)
- Microsoft Learn, "Copilot+ PCs developer guide" (NPUs above 40 TOPS, INT8 models) (2026-10-21 查阅)
- FFmpeg Filters Documentation (`psnr`, `blend`, `noise`, `nlmeans`, `unsharp`) (2026-10-21 查阅)
- x264 source, x264.c help text (`--tune grain` settings) (2026-10-21 查阅)
Up画质与超分 的更多文章