Por que a restauração com IA fica com cara de plástico: losses, GANs, difusão e como evitar
Por que o vídeo restaurado com IA fica com pele de cera: detalhe médio, textura inventada por GAN, desvio da difusão e treino inadequado. Veja como evitar.
O essencial
A restauração com IA fica com cara de plástico quando o modelo remove textura real mais rápido do que consegue reconstruí-la. A pele vira cera, o cabelo se junta em mechas, grão e folhagem se desmancham em manchas lisas, e a imagem parece limpa, mas artificial. As causas são bem conhecidas: a função de perda do treino, a família do modelo e dados de treino que não correspondem ao material.
- “Plástico” é a restauração que apagou a textura fina ao tirar a média (poros, cabelo, grão, folhagem) ou a trocou por uma textura inventada que não combina com a cena.
- Modelos treinados só com erro de pixel (L1 ou L2) preveem a média de todas as respostas plausíveis, e médias são lisas. GANs e modelos de difusão devolvem textura, mas parte dela é inventada.
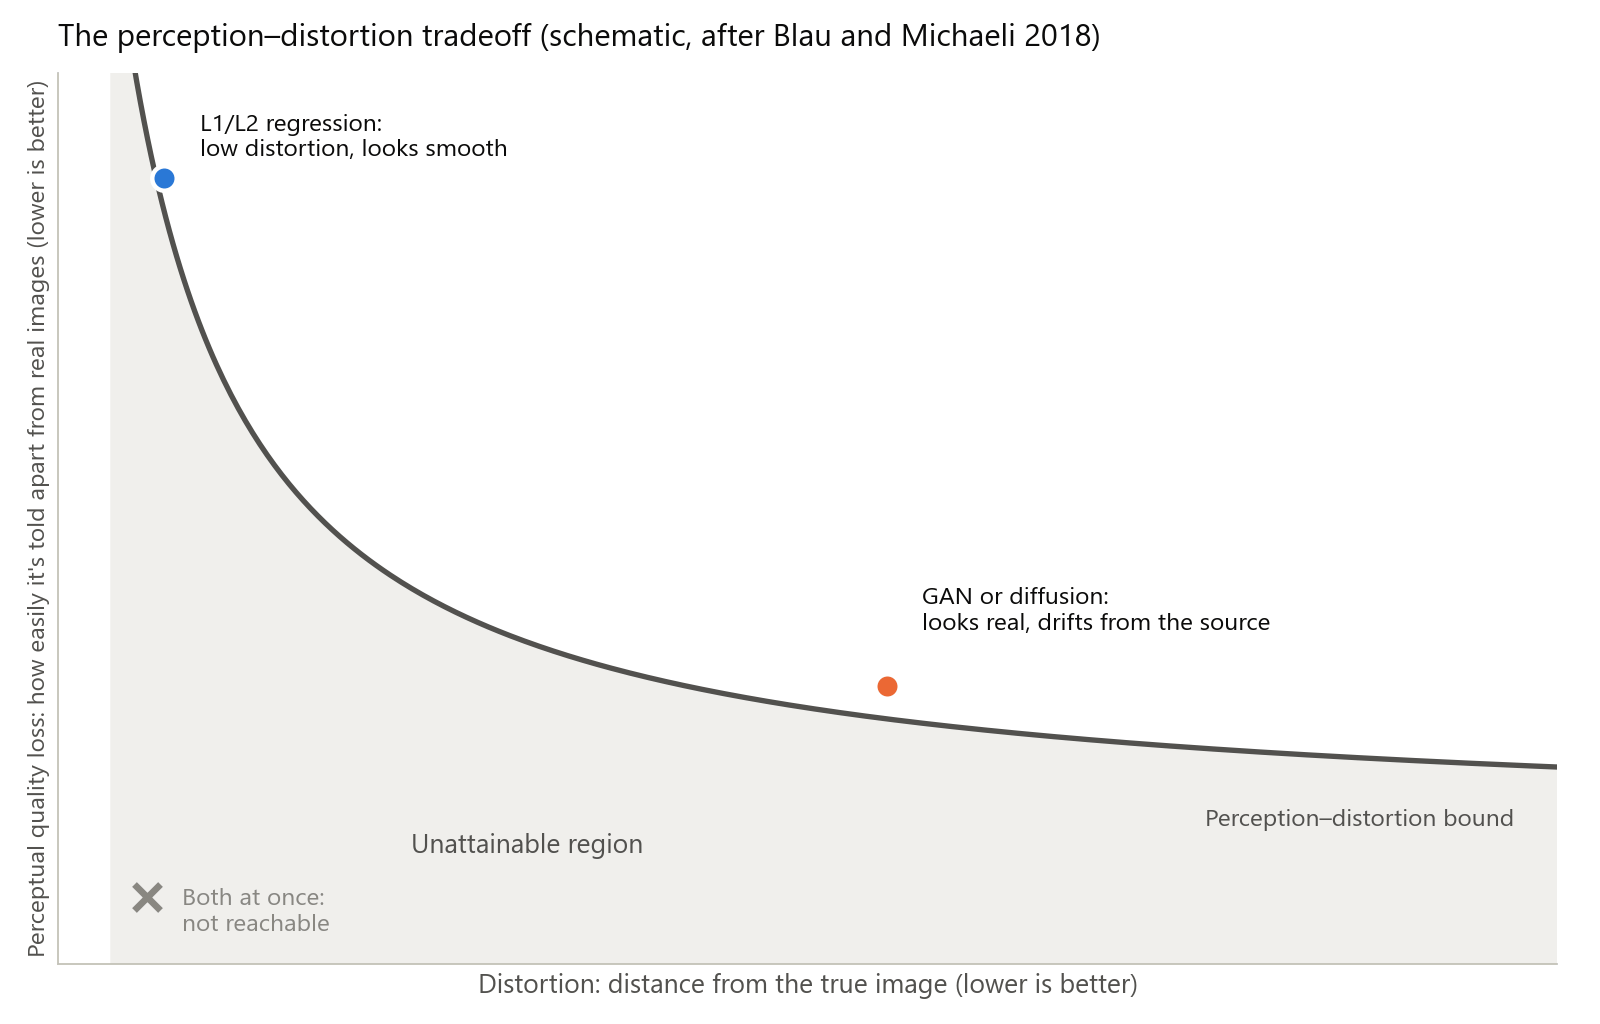
- Blau e Michaeli provaram que baixa distorção e alto realismo puxam em direções opostas, qualquer que seja a medida de distorção; por isso, nenhum score sozinho diz qual resultado parece certo.
- Dados de treino que não correspondem ao seu material e priors de rosto que puxam para um rosto genérico são as outras duas grandes causas.
- Avalie com 100% de zoom e em movimento, reduza a intensidade ou misture com a fonte, mantenha ou devolva o grão e repare antes de fazer upscale.
O que significa “cara de plástico” na restauração com IA?
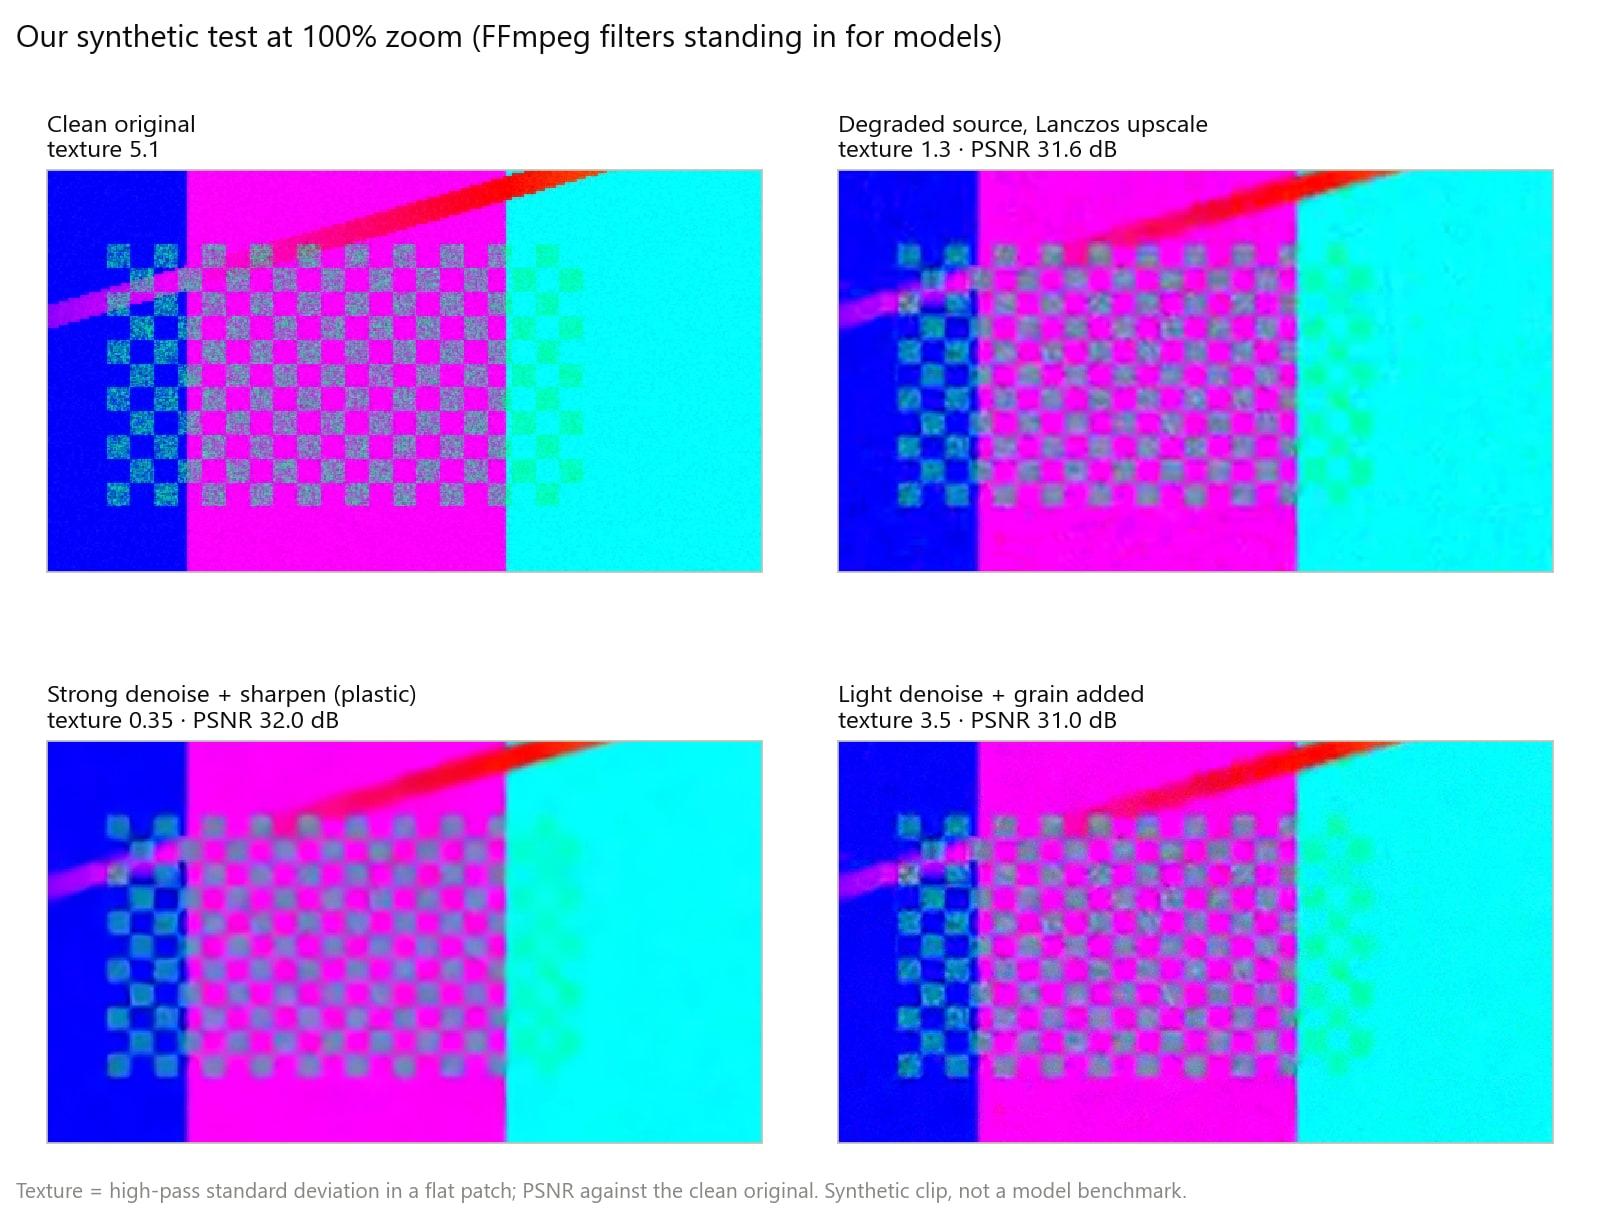
Um resultado plástico é uma imagem restaurada cujas superfícies ficam mais lisas ou mais uniformes que a cena real, de modo que pele, tecido, cabelo e folhagem perdem a pequena textura irregular que os faz parecer físicos. Muitas vezes isso vem junto com contornos bem marcados: no nosso teste com FFmpeg mais abaixo, uma redução de ruído forte com nitidez deixou bordas duras no padrão xadrez e eliminou a textura fina entre elas. Limites nítidos em volta de preenchimentos lisos são o que o olho lê como cera ou CGI.
Como cada família de modelos falha
| Família de modelo | Com o que aprende | Falha típica quando forçada | Exemplos |
|---|---|---|---|
| Regressão com CNN | Perdas de pixel (L1, L2 ou MSE) | Textura lisa, tirada pela média | Redes treinadas com MSE antes do SRGAN |
| GAN | Perdas de pixel, perceptual e adversarial | Textura inventada e artefatos | SRGAN, Real-ESRGAN |
| Transformer | As mesmas perdas, com atenção de longo alcance | A falha que a sua perda produzir | SwinIR, Restormer |
| Modelo recorrente de vídeo | Características alinhadas de vários quadros | Borrões ou fantasmas onde o alinhamento falha | BasicVSR++ |
| Difusão | Remoção iterativa de ruído a partir de um prior aprendido de imagem ou vídeo | Detalhe que se afasta da fonte, cintilação, custo computacional alto | Upscale-A-Video, STAR, SeedVR2 |
Regressão com CNN e perda L1 ou L2
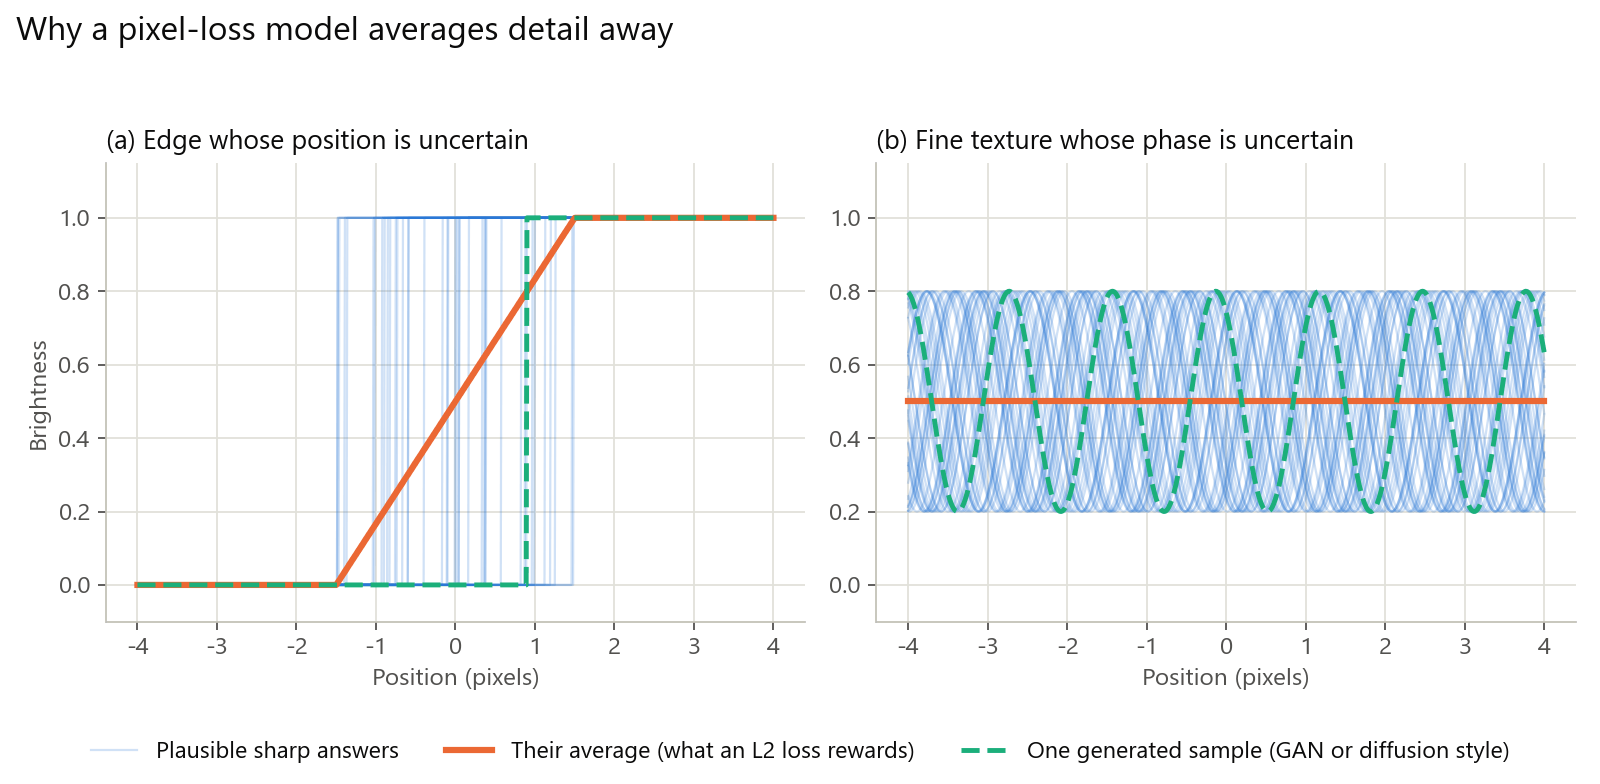
Um pixel degradado é compatível com muitos originais nítidos: uma borda pode estar um pixel à esquerda ou à direita, e um trecho de pele pode ter os poros em incontáveis arranjos. Uma rede treinada com perda L2 (MSE) é recompensada por prever a média dessas possibilidades, e a média de muitas texturas nítidas em posições diferentes é lisa. A L1 prevê a mediana, o que ajuda nas bordas, mas a textura de posição incerta continua se cancelando. Os autores do SRGAN dizem isso com todas as letras: resultados otimizados para MSE muitas vezes não têm detalhe de alta frequência e são insatisfatórios do ponto de vista perceptual.
GANs: textura vinda de uma perda adversarial
O SRGAN acrescentou um discriminador que aprende a distinguir imagens restauradas de fotos reais, além de uma perda de conteúdo baseada em semelhança perceptual em vez de pixels; os autores descrevem o efeito como empurrar a solução para a variedade das imagens naturais. A saída parece mais nítida, mas a textura é gerada para ser plausível, não recuperada. Quando o gerador está em dúvida, ele ainda precisa produzir algo com cara de textura, e é daí que vêm os padrões inventados e as bordas serrilhadas. O Real-ESRGAN, treinado só com dados sintéticos, também simula o ringing e o overshoot que o material real carrega, para aprender a removê-los.
Transformers e modelos recorrentes de vídeo
Transformers como SwinIR e Restormer trocam a convolução pela atenção, que capta interações de longo alcance entre pixels; o Restormer observa que o custo da atenção padrão cresce de forma quadrática com a resolução, por isso os transformers de restauração usam arquiteturas de atenção mais eficientes. A arquitetura não decide sozinha o efeito plástico; quem decide é a perda. Para vídeo, modelos recorrentes como o BasicVSR++ propagam características para a frente e para trás ao longo do clipe com alinhamento deformável guiado por fluxo óptico, então um quadro pode pegar detalhe real dos vizinhos em vez de inventá-lo. Onde o alinhamento falha, em movimentos rápidos ou oclusões, o detalhe emprestado borra ou vira fantasma.
Restauração por difusão
Modelos de difusão restauram removendo ruído de forma iterativa a partir de um prior aprendido, e são os que geram o detalhe fino mais convincente. Essa força também é o risco. Os autores do Upscale-A-Video observam que a aleatoriedade da amostragem por difusão dificulta a consistência temporal, e expõem níveis de ruído para equilibrar restauração e geração. O STAR aponta que modelos de difusão de imagem treinados com fotos têm dificuldade com a consistência temporal e que backbones generativos grandes podem enfraquecer a fidelidade. O custo é o outro limite: os autores do SeedVR2 chamam de proibitivo o custo de inferência da restauração de vídeo por difusão, e é por isso que o destilam em um único passo.
O trade-off entre percepção e distorção
Blau e Michaeli provaram que a distorção (o quanto a saída se afasta da imagem verdadeira) e a qualidade perceptual (o quanto é difícil distinguir a saída de imagens reais) estão em conflito: conforme a distorção média cai, as saídas ficam mais fáceis de distinguir de imagens reais. O resultado vale para qualquer medida de distorção, não só PSNR ou SSIM, e os autores mostram que as GANs oferecem um caminho fundamentado para se aproximar desse limite.
Reproduzimos o efeito em material sintético. Um clipe de teste com textura fina foi degradado para metade da resolução, com ruído e compressão pesada, e depois “restaurado” de duas formas com filtros do FFmpeg no lugar dos modelos: uma redução de ruído forte com nitidez e uma redução de ruído leve com grão devolvido. Comparando com o original limpo:
| Versão | Textura fina (nossa medida passa-alta) | PSNR vs limpo | SSIM vs limpo |
|---|---|---|---|
| Original limpo | 5,1 | Referência | Referência |
| Degradado, só upscale Lanczos | 1,3 | 31,6 dB | 0,700 |
| Redução de ruído forte com nitidez | 0,35 | 32,0 dB | 0,721 |
| Redução de ruído leve, com grão | 3,5 | 31,0 dB | 0,651 |
A versão lisa demais venceu nas duas métricas de pixel mantendo cerca de um quinze avos da textura original; a versão com grão manteve a maior parte da energia de textura e teve a nota mais baixa, porque o grão aleatório não bate pixel a pixel com o padrão original. Quando você tem uma referência limpa, por exemplo depois de degradar um clipe de propósito para testar configurações, a medição leva um comando:
ffmpeg -i restored.mp4 -i reference.mp4 -lavfi "[0:v][1:v]psnr" -f null -Use métricas para pegar reescritas grandes, não para ranquear aparências; como medimos a qualidade de vídeo explica por que um score de semelhança mede mudança, não melhora.
Degradação fora do treino e desvio de identidade
Degradação fora do treino. Um modelo só consegue desfazer o dano que aprendeu. A resposta do Real-ESRGAN foi um modelo de degradação de alta ordem, que encadeia desfoque, redimensionamento, ruído e compressão várias vezes, porque o dano real é mais complexo que uma simples redução de resolução. Quando o material traz um dano fora dessa mistura de treino, como restos de entrelaçamento, ruído de croma forte, compressão incomum ou grão de filme, o modelo pode realçá-lo como se fosse detalhe, ou apagar a textura junto como se tudo fosse ruído.
Desvio de identidade do rosto. Restauradores de rosto trazem priors fortes: o GFPGAN se apoia em uma GAN de rostos pré-treinada, e o CodeFormer prevê entradas de um codebook aprendido de partes do rosto. Os dois artigos tratam o resultado como um equilíbrio entre qualidade e fidelidade, e o CodeFormer expõe esse equilíbrio como um controle. Quanto mais forte o prior, mais um rosto pequeno ou borrado é puxado para um rosto médio plausível, com pele lisa, dentes regulares e olhos genéricos. Veja como restaurar rostos em vídeo para saber o que conferir.
O que está mudando em 2026
- Difusão em um passo. Destilação e pós-treino adversarial reduzem a restauração por difusão a um único passo; o SeedVR2 relata resultados comparáveis ou superiores aos de métodos com vários passos. Uma inferência mais barata torna o detalhe no estilo da difusão viável em clipes longos, mas a questão da fidelidade continua.
- Priors temporais. Em vez de modelos de imagem rodando quadro a quadro, a super-resolução de vídeo mais recente usa priors de vídeo: camadas temporais e propagação latente recorrente no Upscale-A-Video, ou backbones de texto para vídeo no STAR.
- NPUs no próprio dispositivo. O guia de PCs Copilot+ da Microsoft descreve NPUs que passam de 40 trilhões de operações por segundo e observa que muitas trabalham com matemática inteira, como INT8, então os modelos são convertidos para formatos de precisão menor para rodar nelas.
Como identificar um resultado plástico
| Onde olhar com 100% de zoom | Sinal de plástico | Sinal natural |
|---|---|---|
| Pele | Uniforme, sem poros, brilhos de cera | Poros e pequenas variações nas bochechas e no nariz |
| Cabelo | Mechas grudadas ou textura que parece pintada | Fios separados que afinam nas pontas |
| Textos e logos | Letras redesenhadas em formatos errados | Formas que batem com a fonte, mesmo que suaves |
| Folhagem e cascalho | Manchas borradas ou um padrão que se repete | Detalhe irregular que varia pelo quadro |
| Áreas lisas, como céu ou paredes | Faixas lisas, ou textura que não existia | Grão ou ruído parecido com o da fonte |
| Movimento | Textura que nada ou cintila | Detalhe que acompanha o objeto |
Compare o mesmo recorte da fonte e do resultado. Amplie a fonte com interpolação por vizinho mais próximo para ver os pixels reais dela:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor,crop=480:270:760:400[a];[1:v]crop=480:270:760:400[b];[a][b]hstack" -frames:v 1 compare.pngUm mapa de diferença mostra o que a restauração tirou ou acrescentou. Cinza médio significa sem mudança; estrutura em áreas lisas significa ruído ou textura removidos, e padrões novos significam detalhe inventado:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=bicubic,format=gray[a];[1:v]format=gray[b];[b][a]blend=all_mode=grainextract,eq=contrast=4" -frames:v 1 diff.pngNo nosso teste, o mapa da versão lisa demais mostrou o ruído e os blocos da fonte nas áreas lisas, e a textura da região em xadrez, tudo removido.
Como evitar
Método 1: reduza a intensidade ou misture com a fonte. Muitos restauradores expõem um controle de intensidade ou de fidelidade, como o equilíbrio de fidelidade do CodeFormer ou o nível de ruído do Upscale-A-Video; use o ajuste mais baixo que resolva o problema. Se a ferramenta não tiver nenhum, misture a saída dela com a fonte:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=lanczos,format=yuv420p[a];[1:v]format=yuv420p[b];[b][a]blend=all_expr='A*0.7+B*0.3'" -c:v libx264 -crf 16 -c:a copy blended.mp4Isso mantém 70% da restauração e 30% da fonte ampliada. No nosso teste, a mistura trouxe de volta um pouco de textura (0,63 contra 0,35 pela nossa medida) e, junto, parte do ruído da fonte, então serve para casos leves.
Método 2: mantenha o grão ou devolva-o no fim. O grão esconde o aspecto de cera e dá ao encoder uma textura para preservar. Adicione grão temporal fino só na luma e ajuste o x264 para ele:
ffmpeg -i restored.mp4 -vf "noise=c0s=6:c0f=t" -c:v libx264 -crf 16 -tune grain -c:a copy regrained.mp4c0s=6 define a intensidade do ruído na luma e c0f=t faz com que ele mude a cada quadro; o ajuste grain do x264 reduz o deblocking e as zonas mortas do quantizador para que o grão fino sobreviva à codificação. No nosso teste, a medida de textura subiu de 0,35 para 3,5, contra 5,1 do original limpo. É grão novo, não detalhe recuperado. Para diferenciar grão de ruído antes, veja grão vs ruído vs artefatos de compressão.
Método 3: repare antes de fazer upscale. Remova os blocos de compressão e o ruído na resolução da fonte e só depois amplie. Um upscaler que enxerga blocos e ruído como detalhe vai aumentá-los e deixá-los mais nítidos.
Método 4: avalie em movimento. Textura que cintila não aparece em uma imagem parada. Coloque a fonte e o resultado lado a lado, na taxa de quadros da fonte, e assista em 100%:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor[a];[a][1:v]hstack" -c:v libx264 -crf 16 side_by_side.mp4Dica: confira primeiro rostos, textos e folhagem. É neles que o detalhe inventado aparece com mais facilidade e é mais difícil de perdoar.
Como o KwaFlux lida com isso
- O Reparo inteligente trabalha com quadros vizinhos. No Reparo de qualidade, o Reparo inteligente analisa o clipe e combina redução de ruído, nitidez, correção de cor e brilho, upscaling e restauração de rostos e de detalhes finos. Trabalhar com quadros vizinhos faz dele o tipo de restaurador multiquadro descrito acima.
- Os tipos do Reparo por cena trabalham quadro a quadro. Anime, Cena noturna, Remover névoa, Remover chuva, Colorizar e Remoção de grão de filme miram cada um um tipo de dano. Um tipo de cena usado em material para o qual não foi feito é uma causa comum de rostos com cara de cera; qual tipo de reparo escolher trata dessa escolha.
- Gere a prévia antes de exportar. Renderize uma prévia de 1, 3 ou 5 segundos. As prévias de IA são limitadas a 15 fps por padrão, então escolha Acompanhar a origem antes de avaliar movimento ou cintilação.
- Trate o score de semelhança como um alerta. Com Comparar qualidade após a pré-visualização ativado, cada prévia mostra scores que incluem Semelhança com a origem (VMAF), que o app descreve como “Mais alto significa menos mudanças, não qualidade melhor”. Uma queda forte indica uma reescrita pesada que vale conferir com 100% de zoom.
- Mantenha o grão que você quer. A Remoção de grão de filme tira o grão por definição. Se o grão faz parte do visual, pule essa opção e, se o resultado ficar limpo demais, devolva o grão depois da exportação com o comando do FFmpeg acima.
Problemas comuns
| Problema | Causa provável | Solução |
|---|---|---|
| Pele de cera, sem poros | Redução de ruído forte demais, ou resultado no estilo regressão | Reduza a intensidade, misture com a fonte, adicione grão fino |
| O cabelo vira mechas pintadas | Textura inventada por um prior generativo | Reduza a intensidade e compare com o recorte da fonte |
| As letras mudam de formato | O modelo redesenhou um texto que não conseguia ler | Mantenha a fonte nessa área; texto ilegível não tem como ser recuperado |
| A textura nada ou cintila | Invenção quadro a quadro sem consistência temporal | Use um restaurador multiquadro e avalie na taxa de quadros da fonte |
| Ruído realçado como detalhe serrilhado | Dano que o modelo não aprendeu | Reduza o ruído ou os blocos primeiro e depois faça o upscale |
| Um rosto parece de outra pessoa | Prior de rosto forte em um rosto minúsculo ou borrado | Reduza a intensidade da restauração de rostos e confira a identidade com 100% de zoom |
O que isso não resolve
- Nenhum restaurador recupera detalhe que a câmera não captou. Ele prevê um detalhe plausível.
- Não existe um ajuste único que sirva para todas as cenas. Material rico em textura e gráficos chapados falham em direções diferentes.
- Métricas não escolhem o resultado de aparência natural. Scores de pixel recompensam a suavização, então quem decide são os seus olhos.
- Grão adicionado não restaura textura. Ele disfarça o aspecto de cera.
Conclusão
A restauração com IA fica com cara de plástico quando a média vence a textura, ou quando a textura inventada não combina com a cena. Escolha ajustes que preservem a fidelidade, compare com 100% de zoom e em movimento, e trate um quadro limpo mas sem textura como um alerta, não como uma vitória.
O KwaFlux executa o Reparo de qualidade na sua própria GPU. O processamento de IA roda na sua própria GPU e os seus arquivos de mídia não são enviados para processamento. Roda no Windows 10 (64 bits, versão 1809 ou mais recente), no Windows 11 e no macOS 12 ou mais recente em Apple Silicon. As prévias não exigem conta: renderize uma prévia de 1, 3 ou 5 segundos de qualquer clipe. O login com um plano pago só é necessário para exportar, converter, reparar um arquivo ou baixar um arquivo de um link.
Teste no seu próprio material
Baixe o KwaFlux e veja os efeitos de graça no seu próprio material antes de pagar — sem conta, processado na sua GPU, sem enviar sua mídia. As prévias de vídeo duram 1, 3 ou 5 segundos; as de estabilização, 5, 15 ou 30 segundos.
Perguntas frequentes
PSNR ou SSIM mais alto quer dizer restauração melhor?
Não necessariamente. Métricas de pixel recompensam saídas que, em média, ficam perto da referência, e médias são lisas. No nosso teste sintético, um resultado liso demais superou um mais granulado e mais natural tanto em PSNR quanto em SSIM. Trate os scores como uma verificação de mudanças grandes; como medimos a qualidade de vídeo explica por quê.
Difusão ou GAN: qual é melhor para restaurar vídeo?
Depende. Modelos de difusão costumam gerar detalhe mais convincente, mas custam mais para rodar e podem se afastar da fonte ou cintilar entre quadros. GANs são mais rápidas, mas inventam textura quando forçadas. Em vídeo, a consistência temporal importa tanto quanto o detalhe.
Adicionar grão de filme resolve a cara de plástico?
Em parte. O grão fino esconde superfícies de cera e dá ao encoder uma textura para preservar, mas é uma textura aleatória nova, não detalhe recuperado, então não corrige formas erradas nem um rosto alterado. Adicione no fim, depois de qualquer redimensionamento.
Por que o detalhe restaurado cintila quando o vídeo roda?
Porque um modelo que reconstrói cada quadro isoladamente inventa uma textura um pouco diferente a cada vez, e o olho lê essas mudanças como cintilação ou textura “nadando”. Modelos multiquadro, que pegam detalhe de quadros vizinhos alinhados, reduzem isso; por isso, avalie na taxa de quadros da fonte.
Por que fazer upscale de um vídeo com ruído deixa a imagem pior?
Porque um upscaler que confunde ruído ou blocos de compressão com detalhe os amplia e os deixa mais nítidos junto com a imagem. Limpe a imagem na resolução original primeiro, depois faça o upscale e, se quiser, adicione grão no fim.
Fontes
- Blau and Michaeli, "The Perception-Distortion Tradeoff," CVPR 2018 (distortion and perceptual quality are at odds for any distortion measure) (acessado em 2026-10-21)
- Ledig et al., "Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (MSE results lack high-frequency detail; adversarial and content losses) (acessado em 2026-10-21)
- Wang et al., "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data" (high-order degradation model, ringing and overshoot) (acessado em 2026-10-21)
- Liang et al., "SwinIR: Image Restoration Using Swin Transformer" (acessado em 2026-10-21)
- Zamir et al., "Restormer: Efficient Transformer for High-Resolution Image Restoration" (long-range interactions, quadratic cost) (acessado em 2026-10-21)
- Chan et al., "BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment" (acessado em 2026-10-21)
- Wang et al., "Towards Real-World Blind Face Restoration with Generative Facial Prior" (GFP-GAN; realness and fidelity) (acessado em 2026-10-21)
- Zhou et al., "Towards Robust Blind Face Restoration with Codebook Lookup Transformer" (CodeFormer; controllable fidelity and quality) (acessado em 2026-10-21)
- Zhou et al., "Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution" (temporal consistency, noise levels) (acessado em 2026-10-21)
- Xie et al., "STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution" (image diffusion and temporal consistency) (acessado em 2026-10-21)
- Wang et al., "SeedVR2: One-Step Video Restoration via Diffusion Adversarial Post-Training" (one-step restoration, inference cost) (acessado em 2026-10-21)
- Microsoft Learn, "Copilot+ PCs developer guide" (NPUs above 40 TOPS, INT8 models) (acessado em 2026-10-21)
- FFmpeg Filters Documentation (`psnr`, `blend`, `noise`, `nlmeans`, `unsharp`) (acessado em 2026-10-21)
- x264 source, x264.c help text (`--tune grain` settings) (acessado em 2026-10-21)
UpMais em Upscaling e reparo
Continue lendo
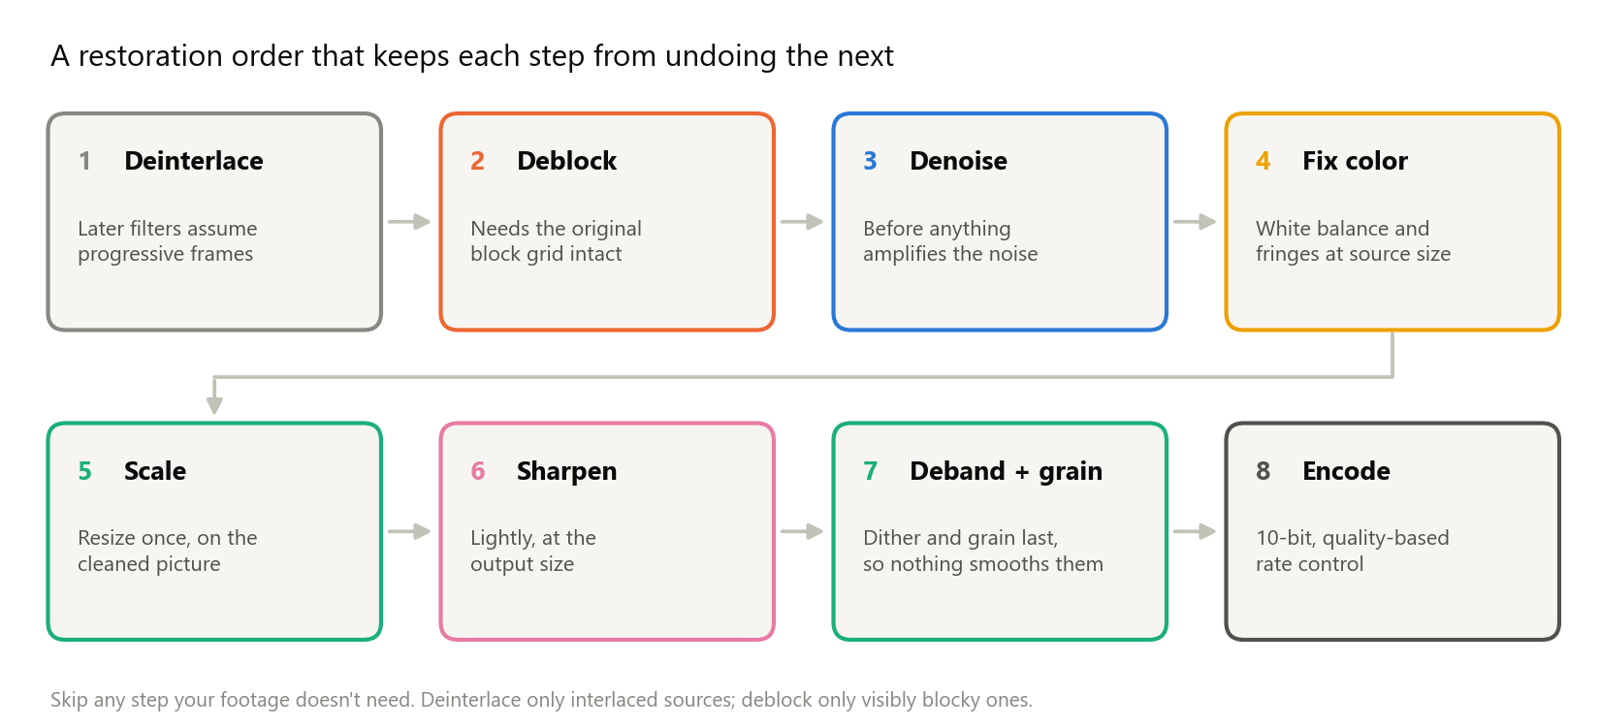
Reduzir ruído, remover blocos, dar nitidez, corrigir a cor: filtros de restauração de vídeo a fundo
Como funcionam redução de ruído, deblocking, debanding, nitidez, balanço de branco e correção de aberração cromática, a ordem certa e testes no FFmpeg.
4K vs 8K: o que realmente muda na tela e quando vale a pena fazer upscaling para 8K
4K vs 8K explicado com cálculo de pixels, bitrate e tamanho de arquivo. Veja quando o 8K compensa, quando o 4K basta e como exportar um upscaling em 8K.
Como aumentar vídeo de 720p para 1080p (e quando parar por aí)
Aumente vídeo de 720p para 1080p com KwaFlux, HandBrake ou FFmpeg. Configurações exatas, o bitrate de exportação e quando não vale a pena ir até 4K.