Pourquoi la restauration IA donne un rendu plastique : pertes, GAN, diffusion et solutions
Pourquoi une vidéo restaurée par IA paraît cireuse : détails moyennés, texture inventée par les GAN, dérive de la diffusion. Comment l’éviter.
L’essentiel
La restauration IA prend un aspect plastique quand le modèle efface la vraie texture plus vite qu’il ne sait la reconstruire. La peau devient cireuse, les cheveux s’agglutinent en mèches, le grain et le feuillage se fondent en aplats lisses, et l’image paraît propre mais artificielle. Les causes sont bien connues : la fonction de perte utilisée à l’entraînement, la famille de modèle, et des données d’entraînement qui ne correspondent pas aux images à traiter.
- Un rendu « plastique », c’est une restauration qui a gommé la texture fine (pores, cheveux, grain, feuillage) à force de moyenner, ou qui l’a remplacée par une texture inventée qui ne colle pas à la scène.
- Un modèle entraîné uniquement sur l’erreur par pixel (L1 ou L2) prédit la moyenne de toutes les réponses plausibles, et une moyenne est lisse. Les GAN et les modèles de diffusion rajoutent de la texture, mais une partie est inventée.
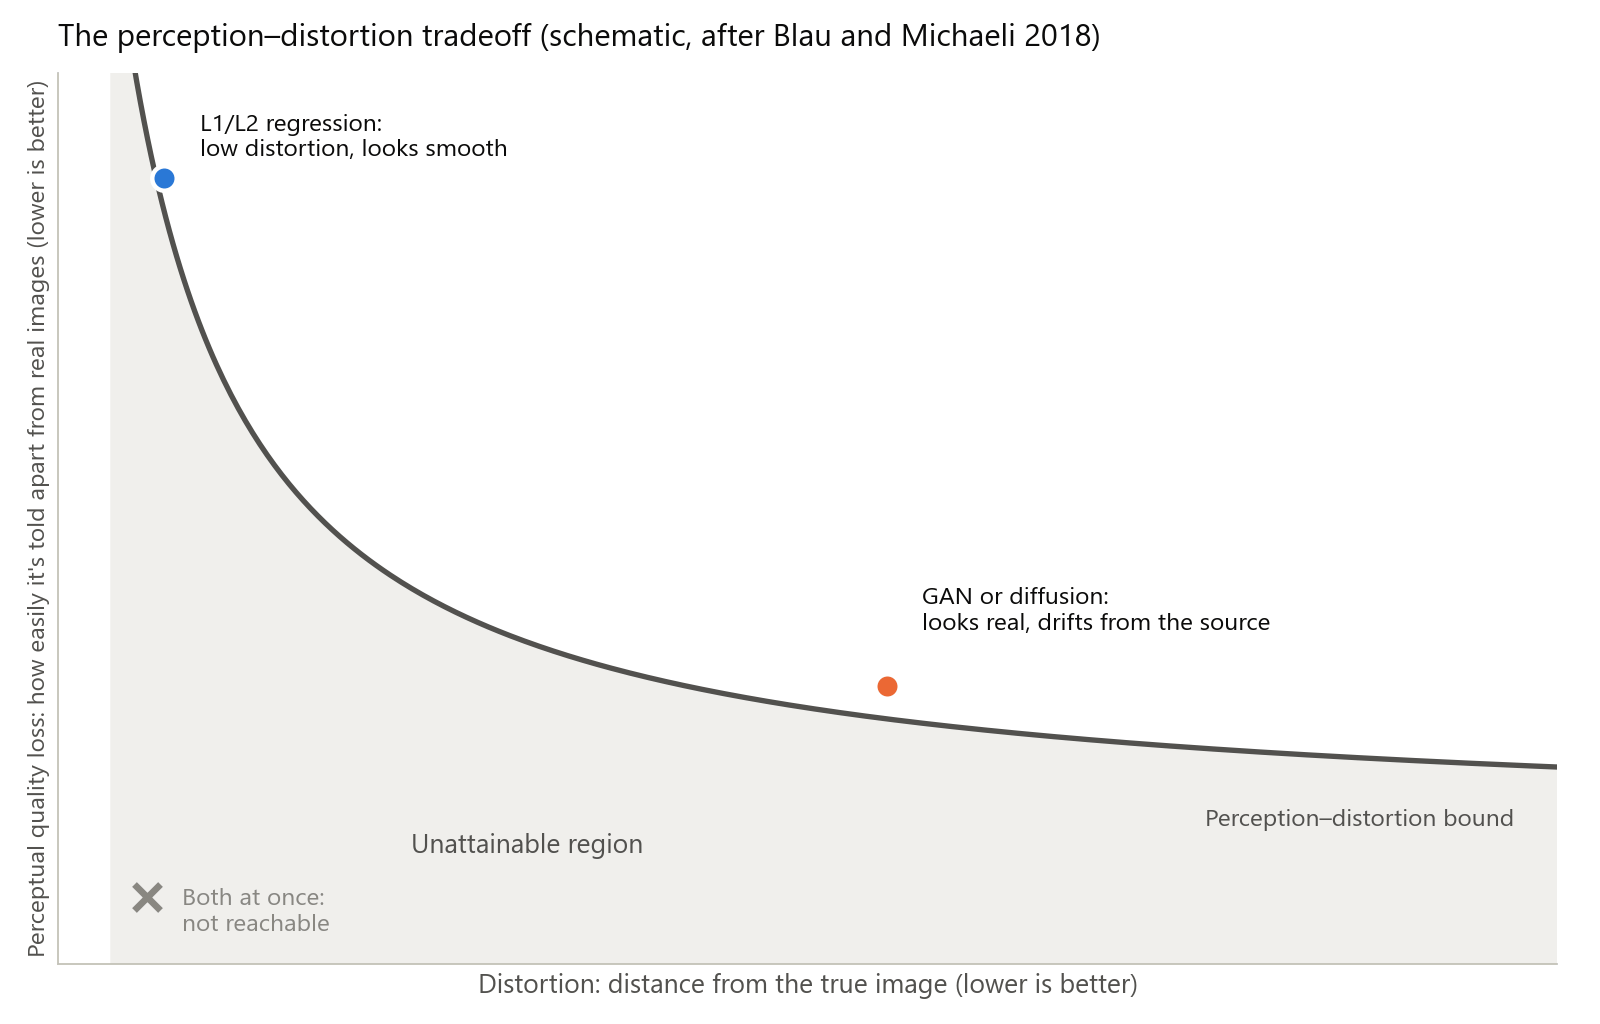
- Blau et Michaeli ont démontré qu’une faible distorsion et un réalisme élevé tirent en sens inverse, quelle que soit la mesure de distorsion : aucun score ne peut donc vous dire à lui seul quel résultat a l’air juste.
- Les deux autres grandes causes : des données d’entraînement qui ne ressemblent pas à vos images, et des a priori de visage qui ramènent vers un visage générique.
- Jugez à 100 % et en mouvement, baissez l’intensité ou mélangez avec la source, gardez ou rajoutez du grain, et réparez avant d’upscaler.
Que veut dire « plastique » en restauration IA ?
Un rendu plastique, c’est une image restaurée dont les surfaces sont plus lisses ou plus uniformes que la scène réelle : la peau, le tissu, les cheveux et le feuillage perdent ces petites irrégularités qui leur donnent une présence physique. Il s’accompagne souvent de contours très nets : dans notre test FFmpeg plus bas, un débruitage fort suivi d’une accentuation a laissé des bords de damier tranchants, sans plus aucune texture fine entre eux. Des limites nettes autour de remplissages lisses, c’est exactement ce que l’œil interprète comme de la cire ou de l’image de synthèse.
Comment chaque famille de modèles déraille
| Famille de modèles | Ce dont elle apprend | Défaut typique quand on force | Exemples |
|---|---|---|---|
| Régression CNN | Pertes par pixel (L1, L2 ou MSE) | Texture lisse, moyennée | Réseaux entraînés en MSE avant SRGAN |
| GAN | Pertes par pixel, perceptuelle et adversariale | Texture inventée et artefacts | SRGAN, Real-ESRGAN |
| Transformer | Les mêmes pertes, avec une attention à longue portée | Le défaut que produit sa perte | SwinIR, Restormer |
| Modèle vidéo récurrent | Caractéristiques alignées sur plusieurs images | Traînées ou images fantômes là où l’alignement échoue | BasicVSR++ |
| Diffusion | Débruitage itératif à partir d’un a priori appris sur l’image ou la vidéo | Détails qui s’écartent de la source, scintillement, calcul lourd | Upscale-A-Video, STAR, SeedVR2 |
Régression CNN avec une perte L1 ou L2
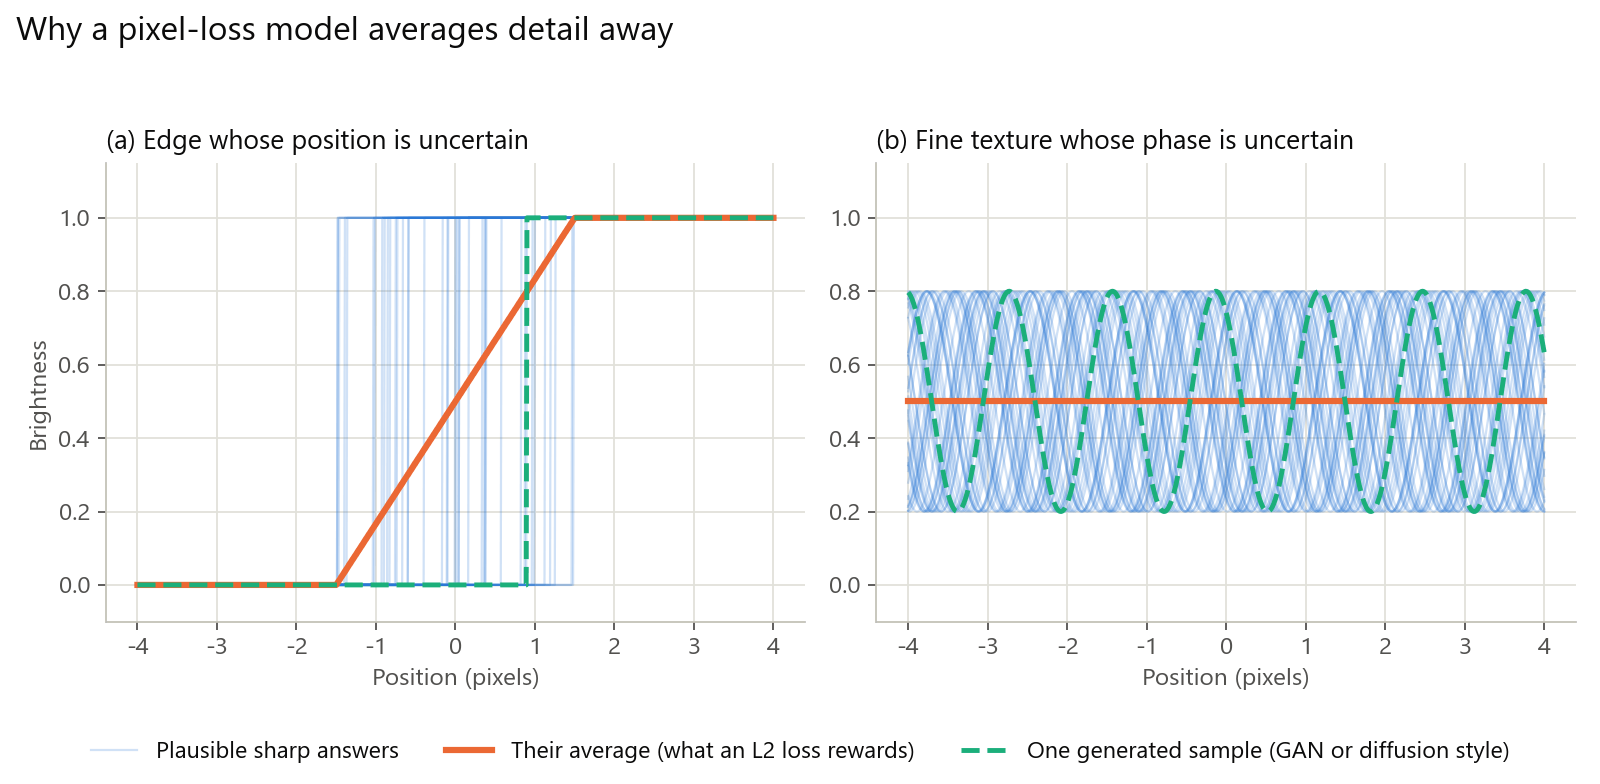
Un pixel dégradé est compatible avec une foule d’originaux nets : un bord peut se trouver un pixel plus à gauche ou plus à droite, et un bout de peau peut avoir ses pores disposés d’innombrables façons. Un réseau entraîné avec une perte L2 (MSE) est récompensé quand il prédit la moyenne de ces possibilités, et la moyenne de nombreuses textures nettes placées différemment est lisse. L1 prédit la médiane, ce qui aide pour les bords, mais une texture dont la position est incertaine s’annule quand même. Les auteurs de SRGAN le disent sans détour : les résultats optimisés en MSE manquent souvent de détails haute fréquence et sont peu satisfaisants à l’œil.
GAN : de la texture grâce à une perte adversariale
SRGAN a ajouté un discriminateur qui apprend à distinguer les images restaurées des vraies photos, ainsi qu’une perte de contenu fondée sur la similarité perceptuelle plutôt que sur les pixels ; ses auteurs décrivent l’effet comme le fait de pousser la solution vers la variété des images naturelles. Le résultat paraît plus net, mais la texture est générée pour être plausible, pas retrouvée. Quand le générateur hésite, il doit malgré tout produire quelque chose qui ressemble à de la texture : c’est de là que viennent les motifs inventés et les bords crénelés. Real-ESRGAN, entraîné uniquement sur des données synthétiques, simule aussi les rebonds (ringing) et les dépassements (overshoot) présents dans les vraies vidéos, pour apprendre à les supprimer.
Transformers et modèles vidéo récurrents
Les transformers comme SwinIR et Restormer remplacent la convolution par l’attention, qui capte les interactions entre pixels éloignés ; Restormer rappelle que le coût de l’attention standard croît de façon quadratique avec la résolution, d’où des variantes d’attention plus économes dans les transformers de restauration. L’architecture ne décide pas à elle seule de l’effet plastique : c’est la perte qui décide. Pour la vidéo, les modèles récurrents comme BasicVSR++ propagent les caractéristiques vers l’avant et vers l’arrière dans le clip, avec un alignement déformable guidé par le flux optique : une image peut ainsi emprunter de vrais détails à ses voisines au lieu de les inventer. Là où l’alignement échoue, dans les mouvements rapides ou les occultations, ces détails empruntés laissent des traînées ou des images fantômes.
Restauration par diffusion
Les modèles de diffusion restaurent par débruitage itératif à partir d’un a priori appris, et ce sont eux qui génèrent les détails fins les plus convaincants. Cette force est aussi le risque. Les auteurs d’Upscale-A-Video notent que le caractère aléatoire de l’échantillonnage par diffusion complique la cohérence temporelle, et ils exposent des niveaux de bruit pour doser restauration et génération. STAR note que les modèles de diffusion d’image entraînés sur des images fixes peinent à rester cohérents dans le temps, et que les grands backbones génératifs peuvent nuire à la fidélité. Le coût est l’autre limite : les auteurs de SeedVR2 jugent prohibitif le coût d’inférence de la restauration vidéo par diffusion, raison pour laquelle ils la distillent en une seule étape.
Le compromis perception-distorsion
Blau et Michaeli ont démontré que la distorsion (l’écart entre le résultat et l’image réelle) et la qualité perceptuelle (la difficulté à distinguer le résultat de vraies images) sont en opposition : plus la distorsion moyenne baisse, plus les résultats deviennent faciles à distinguer de vraies images. Le résultat vaut pour toute mesure de distorsion, pas seulement le PSNR ou le SSIM, et les auteurs montrent que les GAN offrent une manière fondée d’approcher cette limite.
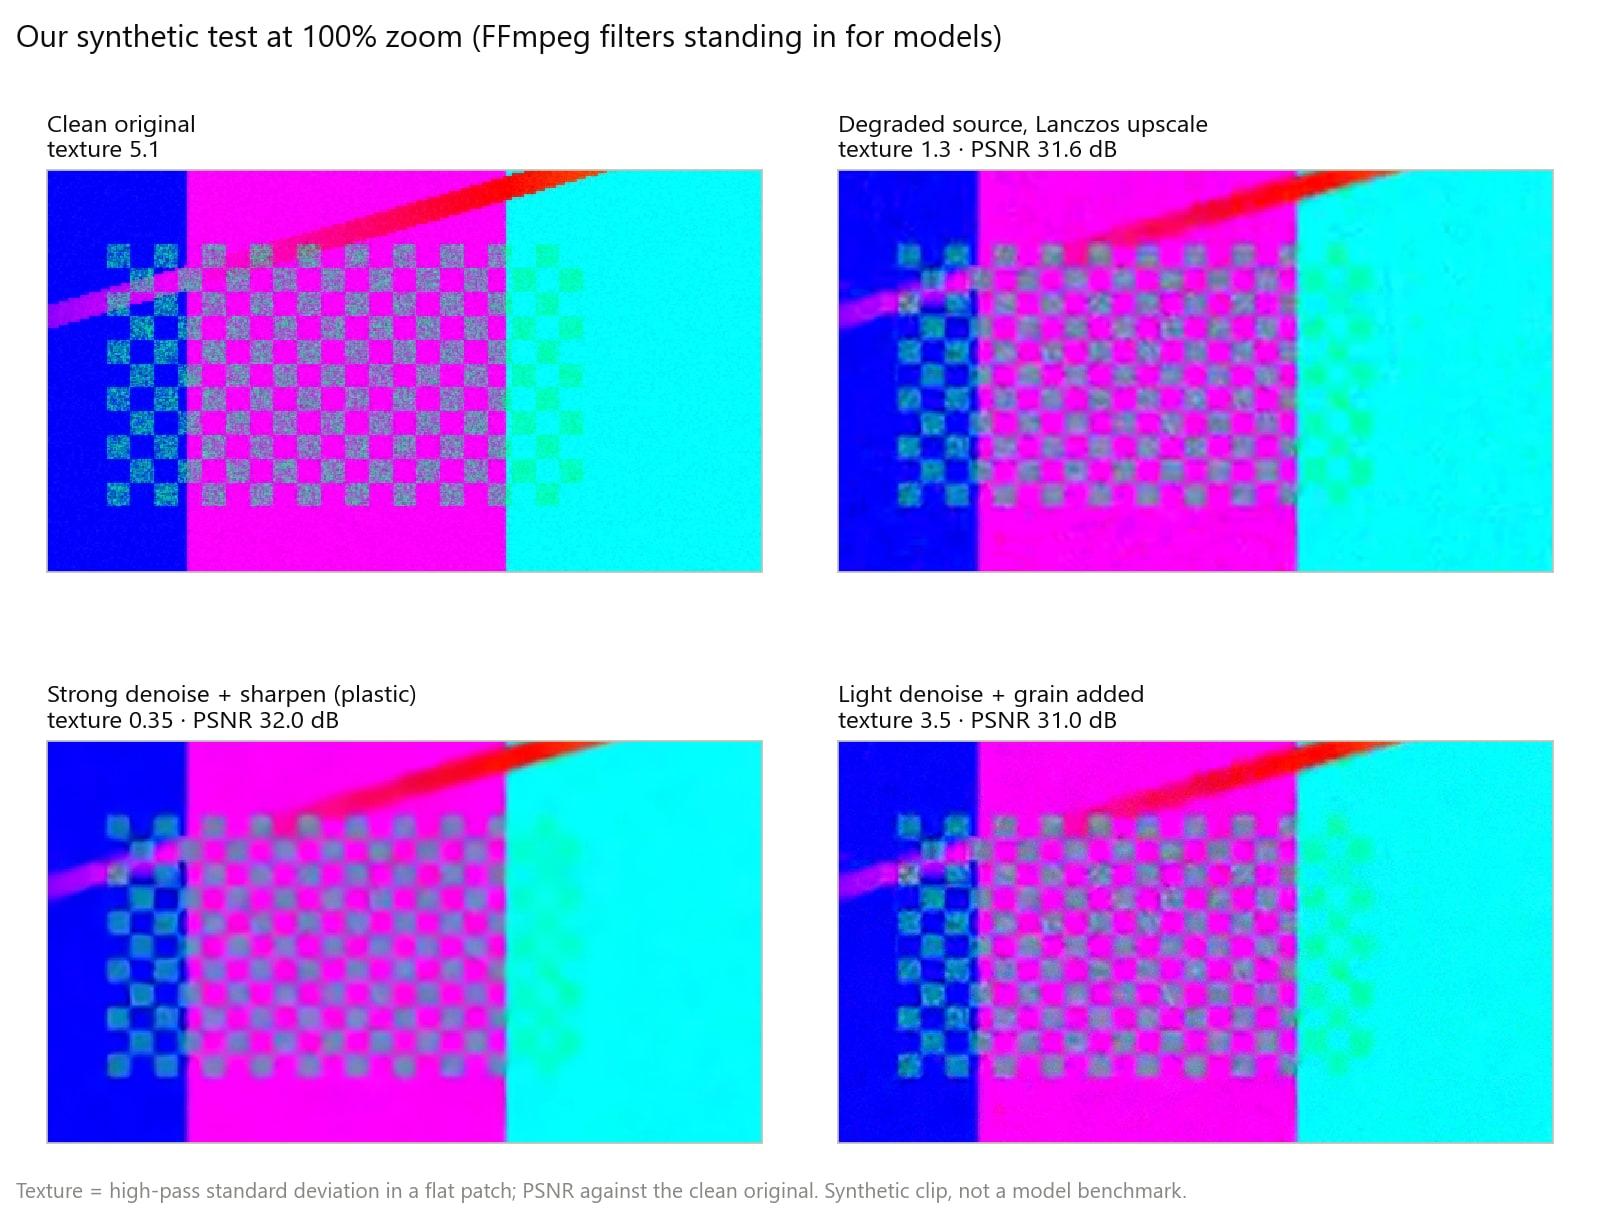
Nous avons reproduit l’effet sur des images synthétiques. Un clip de test finement texturé a été dégradé (demi-résolution, bruit, forte compression), puis « restauré » de deux façons, avec des filtres FFmpeg à la place des modèles : un débruitage fort avec accentuation, et un débruitage léger avec du grain rajouté. Scores par rapport à l’original propre :
| Version | Texture fine (notre mesure passe-haut) | PSNR par rapport à l’original | SSIM par rapport à l’original |
|---|---|---|---|
| Original propre | 5,1 | Référence | Référence |
| Dégradé, simple upscale Lanczos | 1,3 | 31,6 dB | 0,700 |
| Débruitage fort et accentuation | 0,35 | 32,0 dB | 0,721 |
| Débruitage léger, grain ajouté | 3,5 | 31,0 dB | 0,651 |
La version trop lissée remporte les deux métriques par pixel tout en ne gardant qu’environ un quinzième de la texture d’origine ; la version avec grain conserve l’essentiel de l’énergie de texture et obtient les plus mauvais scores, parce qu’un grain aléatoire ne reproduit pas le motif d’origine pixel par pixel. Quand vous disposez d’une référence propre, par exemple après avoir dégradé un clip exprès pour tester des réglages, la mesure tient en une commande :
ffmpeg -i restored.mp4 -i reference.mp4 -lavfi "[0:v][1:v]psnr" -f null -Servez-vous des métriques pour repérer les réécritures importantes, pas pour classer des rendus : notre façon de noter la qualité vidéo explique pourquoi un score de similarité mesure un changement, pas une amélioration.
Dégradations inattendues et dérive d’identité
Dégradations inattendues. Un modèle ne sait défaire que les dégâts qu’il a appris. La réponse de Real-ESRGAN a été un modèle de dégradation d’ordre élevé, qui enchaîne plusieurs fois flou, redimensionnement, bruit et compression, parce que les dégâts réels sont plus complexes qu’un simple sous-échantillonnage. Quand une vidéo porte des dégâts absents du mélange d’entraînement (restes d’entrelacement, fort bruit de chrominance, compression inhabituelle, grain de film), le modèle peut les accentuer comme s’il s’agissait de détails, ou effacer la texture avec eux comme si tout était du bruit.
Dérive d’identité des visages. Les restaurateurs de visages s’appuient sur des a priori puissants : GFPGAN puise dans un GAN de visages pré-entraîné, et CodeFormer prédit des entrées dans un dictionnaire appris de parties du visage. Les deux articles présentent le résultat comme un équilibre entre qualité et fidélité, et CodeFormer en fait un réglage. Plus l’a priori est fort, plus un visage petit ou flou est tiré vers un visage moyen plausible : peau lisse, dents régulières, yeux génériques. Voir comment restaurer les visages dans une vidéo pour savoir quoi vérifier.
Ce qui change en 2026
- La diffusion en une étape. La distillation et le post-entraînement adversarial ramènent la restauration par diffusion à une seule étape ; SeedVR2 annonce des résultats comparables ou supérieurs aux méthodes à plusieurs étapes. Une inférence moins chère rend les détails façon diffusion praticables sur de longs clips, mais la question de la fidélité demeure.
- Les a priori temporels. Au lieu de modèles d’image appliqués image par image, la super-résolution vidéo récente s’appuie sur des a priori vidéo : couches temporelles et propagation latente récurrente dans Upscale-A-Video, ou backbones texte-vers-vidéo dans STAR.
- Les NPU embarqués. Le guide Copilot+ PC de Microsoft décrit des NPU qui dépassent 40 000 milliards d’opérations par seconde et précise que beaucoup calculent en entiers, par exemple en INT8 : les modèles sont donc convertis dans des formats de moindre précision pour y tourner.
Comment repérer un rendu plastique
| Où regarder à 100 % | Signe de plastique | Signe naturel |
|---|---|---|
| Peau | Uniforme, sans pores, reflets cireux | Pores et fines variations sur les joues et le nez |
| Cheveux | Mèches agglutinées ou texture peinte | Mèches séparées qui s’affinent vers les bords |
| Texte et logos | Lettres redessinées avec de mauvaises formes | Formes fidèles à la source, même si elles restent floues |
| Feuillage et gravier | Taches étalées ou motif qui se répète | Détails irréguliers qui varient dans l’image |
| Zones unies comme le ciel ou les murs | Bandes lisses, ou texture qui n’existait pas | Grain ou bruit proche de la source |
| Mouvement | Texture qui flotte ou scintille | Détails qui suivent l’objet |
Comparez le même recadrage de la source et du résultat. Mettez la source à l’échelle en plus proche voisin pour voir ses vrais pixels :
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor,crop=480:270:760:400[a];[1:v]crop=480:270:760:400[b];[a][b]hstack" -frames:v 1 compare.pngUne carte des différences montre ce que la restauration a retiré ou ajouté. Le gris moyen signifie « inchangé » ; une structure dans les zones unies signale du bruit ou de la texture retirés, et de nouveaux motifs trahissent des détails inventés :
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=bicubic,format=gray[a];[1:v]format=gray[b];[b][a]blend=all_mode=grainextract,eq=contrast=4" -frames:v 1 diff.pngDans notre test, la carte de la version trop lissée faisait apparaître le bruit et les blocs de la source dans les zones unies, ainsi que la texture de la zone en damier : tout cela avait été retiré.
Comment l’éviter
Méthode 1 : baissez l’intensité, ou mélangez avec la source. Beaucoup de restaurateurs proposent un réglage d’intensité ou de fidélité, comme le compromis de fidélité de CodeFormer ou le niveau de bruit d’Upscale-A-Video ; prenez le réglage le plus bas qui règle le problème. Si l’outil n’en a pas, mélangez son résultat avec la source :
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=lanczos,format=yuv420p[a];[1:v]format=yuv420p[b];[b][a]blend=all_expr='A*0.7+B*0.3'" -c:v libx264 -crf 16 -c:a copy blended.mp4On garde ainsi 70 % de la restauration et 30 % de la source upscalée. Dans notre test, le mélange a ramené un peu de texture (0,63 contre 0,35 selon notre mesure) et, avec elle, une partie du bruit de la source : il convient donc aux cas légers.
Méthode 2 : gardez le grain, ou rajoutez-le en dernier. Le grain masque l’aspect cireux et donne à l’encodeur une texture à préserver. Ajoutez un grain temporel fin sur la luminance seulement, et réglez x264 en conséquence :
ffmpeg -i restored.mp4 -vf "noise=c0s=6:c0f=t" -c:v libx264 -crf 16 -tune grain -c:a copy regrained.mp4c0s=6 fixe l’intensité du bruit de luminance et c0f=t le fait varier à chaque image ; le réglage grain de x264 réduit le filtre de déblocage et les zones mortes du quantificateur pour que le grain fin survive à l’encodage. Dans notre test, la mesure de texture est passée de 0,35 à 3,5, contre 5,1 pour l’original propre. C’est du grain neuf, pas du détail retrouvé. Pour distinguer d’abord grain et bruit, voir grain, bruit et artefacts de compression.
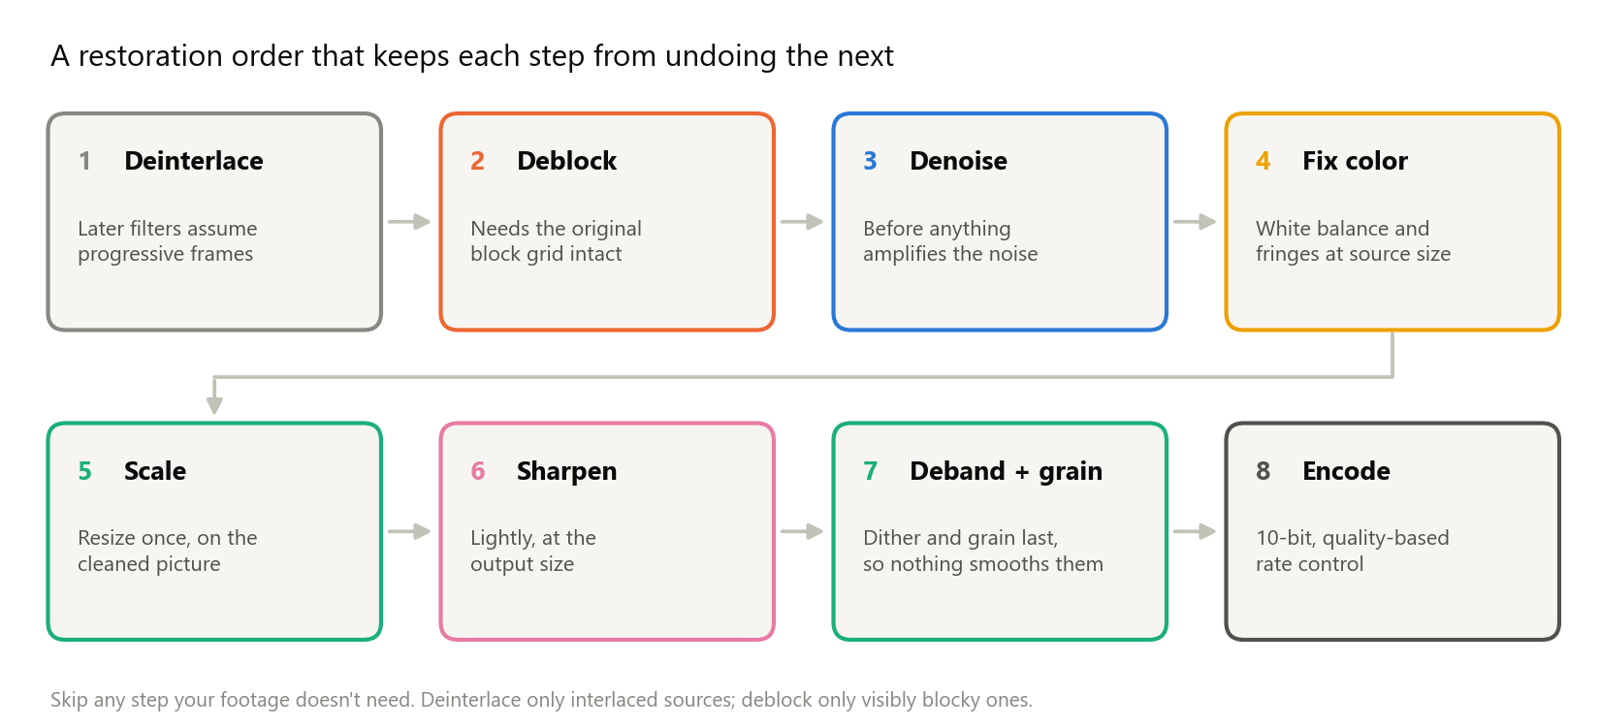
Méthode 3 : réparez avant d’upscaler. Supprimez les blocs de compression et le bruit à la résolution de la source, puis upscalez. Un upscaler qui prend les blocs et le bruit pour du détail va les agrandir et les accentuer.
Méthode 4 : jugez en mouvement. Une texture qui scintille ne se voit pas sur une image fixe. Placez la source et le résultat côte à côte, à la cadence de la source, et regardez à 100 % :
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor[a];[a][1:v]hstack" -c:v libx264 -crf 16 side_by_side.mp4Astuce : vérifiez d’abord les visages, le texte et le feuillage. C’est là que les détails inventés se voient le plus et se pardonnent le moins.
Ce que fait KwaFlux
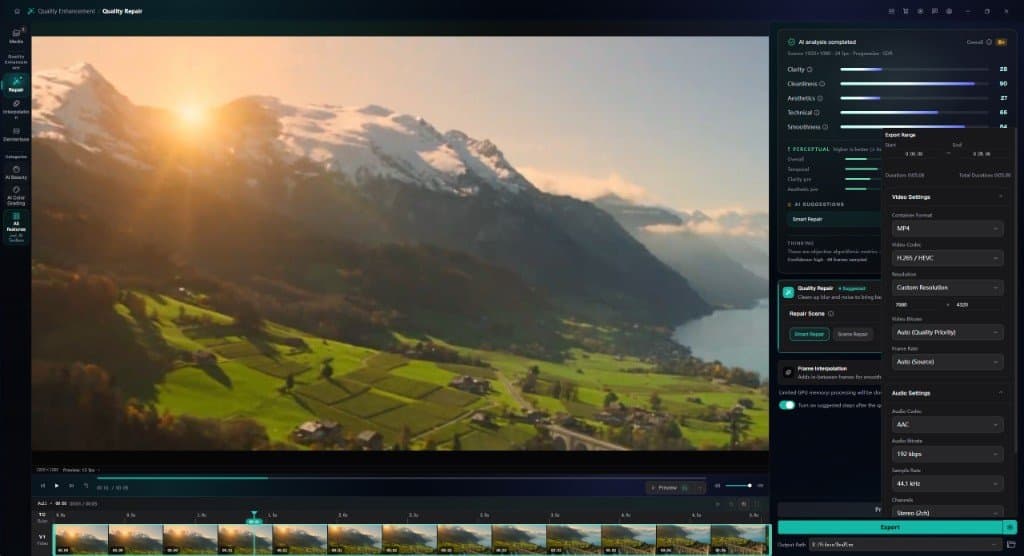
- La Réparation intelligente s’appuie sur les images voisines. Dans Réparation de qualité, Réparation intelligente analyse le clip et combine débruitage, accentuation, correction des couleurs et de la luminosité, upscaling et restauration des visages et des détails fins. Comme elle travaille à partir des images voisines, elle relève des restaurateurs multi-images décrits plus haut.
- Les types de Réparation par scène travaillent image par image. Anime, Scène de nuit, Débrumage, Suppression de la pluie, Coloriser et Suppression du grain film visent chacun un type de dégât. Un type de scène appliqué à des images pour lesquelles il n’est pas fait est une cause fréquente de visages cireux ; quel type de réparation choisir détaille le choix.
- Prévisualisez avant d’exporter. Rendez un aperçu de 1, 3 ou 5 secondes. Les aperçus IA sont limités par défaut à 15 fps : choisissez Suivre la source avant de juger le mouvement ou le scintillement.
- Prenez le score de similarité comme un signal. Avec Comparer la qualité après l’aperçu activé, chaque aperçu affiche des scores, dont Similarité à la source (VMAF), que l’app décrit ainsi : « Plus élevé signifie moins de changements, pas une meilleure qualité ». Une forte baisse signale une réécriture lourde à vérifier à 100 %.
- Gardez le grain que vous voulez. Suppression du grain film retire le grain, c’est sa fonction. Si le grain fait partie du rendu, passez-vous-en, et rajoutez du grain après l’export avec la commande FFmpeg ci-dessus si le résultat paraît trop propre.
Problèmes courants
| Problème | Cause probable | Solution |
|---|---|---|
| Peau cireuse, sans pores | Débruitage trop fort, ou résultat de type régression | Baissez l’intensité, mélangez avec la source, ajoutez un grain fin |
| Les cheveux deviennent des mèches peintes | Texture inventée par un a priori génératif | Baissez l’intensité et comparez avec le recadrage de la source |
| Les lettres changent de forme | Le modèle a redessiné un texte qu’il ne pouvait pas lire | Gardez la source sur cette zone ; un texte illisible ne se récupère pas |
| La texture flotte ou scintille | Invention image par image sans cohérence temporelle | Utilisez un restaurateur multi-images et jugez à la cadence de la source |
| Bruit accentué en faux détails granuleux | Dégâts que le modèle n’a pas appris | Débruitez ou débloquez d’abord, puis upscalez |
| Un visage ressemble à quelqu’un d’autre | Un a priori de visage fort sur un visage minuscule ou flou | Baissez l’intensité de la restauration des visages et vérifiez l’identité à 100 % |
Les limites
- Aucun restaurateur ne récupère des détails que la caméra n’a pas captés. Il prédit des détails plausibles.
- Aucun réglage ne convient à tous les plans. Les images riches en texture et les graphismes en aplats déraillent dans des directions différentes.
- Les métriques ne savent pas désigner le résultat le plus naturel. Les scores par pixel récompensent le lissage : c’est à vos yeux de trancher.
- Le grain ajouté ne restaure pas la texture. Il masque l’aspect cireux.
Conclusion
La restauration IA prend un aspect plastique quand la moyenne l’emporte sur la texture, ou quand une texture inventée ne colle pas à la scène. Choisissez des réglages qui préservent la fidélité, comparez à 100 % et en mouvement, et voyez une image propre mais sans texture comme un signal d’alerte, pas comme une réussite.
KwaFlux exécute la Réparation de qualité sur votre propre GPU. Le traitement IA tourne sur votre propre GPU et vos fichiers média ne sont pas envoyés pour être traités. KwaFlux fonctionne sous Windows 10 (64 bits, version 1809 ou plus récente), Windows 11 et macOS 12 ou plus récent sur Apple Silicon. Les aperçus ne demandent pas de compte : rendez un aperçu de 1, 3 ou 5 secondes sur n’importe quel clip. Une connexion avec un forfait payant n’est requise que pour exporter, convertir, réparer un fichier ou télécharger un fichier depuis un lien.
Testez sur vos propres images
Téléchargez KwaFlux et prévisualisez gratuitement les effets sur vos propres images avant de payer — sans compte, traitement sur votre GPU, sans envoi de vos médias. Les aperçus vidéo durent 1, 3 ou 5 secondes, ceux de la stabilisation 5, 15 ou 30 secondes.
Questions fréquentes
Un meilleur PSNR ou SSIM veut-il dire une meilleure restauration ?
Pas forcément. Les métriques par pixel récompensent les résultats proches de la référence en moyenne, et une moyenne est lisse. Dans notre test synthétique, un résultat trop lissé a battu une version plus granuleuse et plus naturelle en PSNR comme en SSIM. Prenez les scores comme un contrôle des gros changements ; notre façon de noter la qualité vidéo explique pourquoi.
Diffusion ou GAN : quoi de mieux pour restaurer une vidéo ?
Ça dépend. Les modèles de diffusion génèrent en général des détails plus convaincants, mais ils coûtent plus cher à exécuter et peuvent s’écarter de la source ou scintiller d’une image à l’autre. Les GAN sont plus rapides mais inventent de la texture quand on les pousse. En vidéo, la cohérence temporelle compte autant que le détail.
Ajouter du grain suffit-il à corriger un rendu plastique ?
En partie. Un grain fin masque les surfaces cireuses et donne à l’encodeur une texture à préserver, mais c’est une texture aléatoire neuve, pas du détail retrouvé : il ne corrige ni les formes fausses ni un visage modifié. Ajoutez-le en dernier, après toute mise à l’échelle.
Pourquoi les détails restaurés scintillent-ils à la lecture ?
Parce qu’un modèle qui reconstruit chaque image isolément invente à chaque fois une texture légèrement différente, et l’œil perçoit ces variations comme un scintillement ou un flottement. Les modèles multi-images, qui empruntent des détails aux images voisines alignées, l’atténuent : jugez donc à la cadence de la source.
Pourquoi l’upscaling d’une vidéo bruitée la rend-il pire ?
Parce qu’un upscaler qui prend le bruit ou les blocs de compression pour du détail les agrandit et les accentue avec le reste de l’image. Nettoyez d’abord l’image à sa résolution d’origine, upscalez ensuite, et ajoutez du grain en dernier si vous en voulez.
Sources
- Blau and Michaeli, "The Perception-Distortion Tradeoff," CVPR 2018 (distortion and perceptual quality are at odds for any distortion measure) (consulté le 2026-10-21)
- Ledig et al., "Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (MSE results lack high-frequency detail; adversarial and content losses) (consulté le 2026-10-21)
- Wang et al., "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data" (high-order degradation model, ringing and overshoot) (consulté le 2026-10-21)
- Liang et al., "SwinIR: Image Restoration Using Swin Transformer" (consulté le 2026-10-21)
- Zamir et al., "Restormer: Efficient Transformer for High-Resolution Image Restoration" (long-range interactions, quadratic cost) (consulté le 2026-10-21)
- Chan et al., "BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment" (consulté le 2026-10-21)
- Wang et al., "Towards Real-World Blind Face Restoration with Generative Facial Prior" (GFP-GAN; realness and fidelity) (consulté le 2026-10-21)
- Zhou et al., "Towards Robust Blind Face Restoration with Codebook Lookup Transformer" (CodeFormer; controllable fidelity and quality) (consulté le 2026-10-21)
- Zhou et al., "Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution" (temporal consistency, noise levels) (consulté le 2026-10-21)
- Xie et al., "STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution" (image diffusion and temporal consistency) (consulté le 2026-10-21)
- Wang et al., "SeedVR2: One-Step Video Restoration via Diffusion Adversarial Post-Training" (one-step restoration, inference cost) (consulté le 2026-10-21)
- Microsoft Learn, "Copilot+ PCs developer guide" (NPUs above 40 TOPS, INT8 models) (consulté le 2026-10-21)
- FFmpeg Filters Documentation (`psnr`, `blend`, `noise`, `nlmeans`, `unsharp`) (consulté le 2026-10-21)
- x264 source, x264.c help text (`--tune grain` settings) (consulté le 2026-10-21)
UpPlus dans Upscaling et réparation
À lire ensuite
Débruiter, débloquer, accentuer, corriger les couleurs : les filtres de restauration vidéo en détail
Débruitage, déblocage, débandage, accentuation, balance des blancs et aberration chromatique : comment ça marche, dans quel ordre, avec des tests FFmpeg.
4K vs 8K : ce qui change vraiment à l’écran, et quand l’upscaling en 8K vaut le coup
4K vs 8K : calcul des pixels, débits et taille des fichiers. Quand la 8K vaut le coup, quand la 4K suffit, et comment exporter un upscaling en 8K.
Comment passer une vidéo de 720p à 1080p (et quand s’arrêter là)
Passez une vidéo de 720p à 1080p avec KwaFlux, HandBrake ou FFmpeg : réglages exacts, débit d’export et quand aller jusqu’en 4K n’en vaut pas la peine.