Por qué la restauración con IA parece de plástico: pérdidas, GAN, difusión y cómo evitarlo
Por qué el vídeo restaurado con IA parece de cera: detalle promediado, textura inventada por GAN, deriva de la difusión y datos que no encajan.
Lo esencial
La restauración con IA parece de plástico cuando el modelo elimina textura real más deprisa de lo que es capaz de reconstruirla. La piel se vuelve cerosa, el pelo se apelmaza en mechones, el grano y el follaje se emborronan en manchas lisas, y la imagen se percibe limpia pero artificial. Las causas se conocen bien: la función de pérdida del entrenamiento, la familia de modelos y unos datos de entrenamiento que no se corresponden con el metraje.
- El aspecto «de plástico» aparece cuando la restauración ha promediado la textura fina (poros, pelo, grano, follaje) hasta borrarla, o la ha sustituido por una textura inventada que no encaja con la escena.
- Los modelos entrenados solo con error de píxel (L1 o L2) predicen la media de todas las respuestas plausibles, y las medias son lisas. Las GAN y los modelos de difusión devuelven textura, pero parte de ella es inventada.
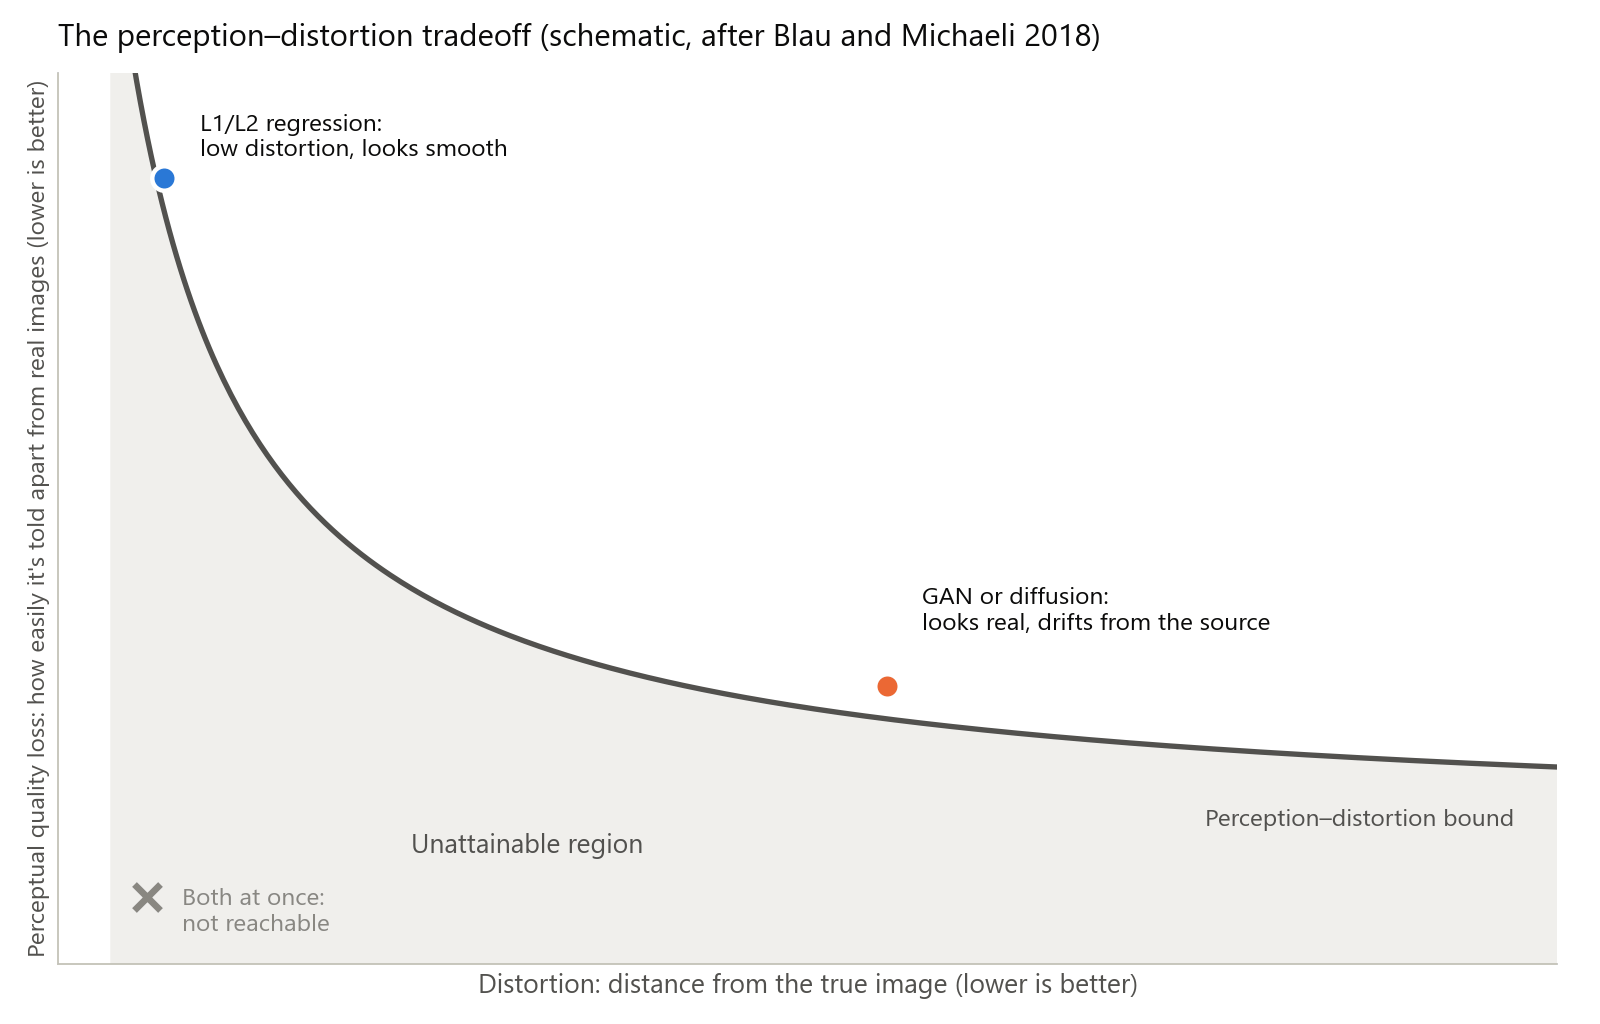
- Blau y Michaeli demostraron que una distorsión baja y un realismo alto tiran en direcciones opuestas sea cual sea la medida de distorsión, así que ninguna puntuación por sí sola le dirá qué resultado se ve bien.
- Las otras dos grandes causas son unos datos de entrenamiento que no se parecen a su metraje y unos priors faciales que arrastran hacia una cara genérica.
- Juzgue al 100 % de zoom y en movimiento, baje la intensidad o mezcle con la fuente, conserve o vuelva a añadir el grano y repare antes de escalar.
¿Qué significa «plástico» en la restauración con IA?
Un resultado plástico es una imagen restaurada cuyas superficies son más lisas o más uniformes que las de la escena real, de modo que la piel, la tela, el pelo y el follaje pierden esa pequeña textura irregular que los hace parecer físicos. Suele venir acompañado de contornos muy definidos: en nuestra prueba con FFmpeg, más abajo, una reducción de ruido fuerte más un enfoque dejó bordes de tablero de ajedrez muy duros sin la textura fina que había entre ellos. Bordes nítidos alrededor de rellenos lisos: eso es lo que el ojo interpreta como cera o CGI.
Cómo falla cada familia de modelos
| Familia de modelos | De qué aprende | Fallo típico al forzarlo | Ejemplos |
|---|---|---|---|
| Regresión con CNN | Pérdidas de píxel (L1, L2 o MSE) | Textura lisa y promediada | Redes entrenadas con MSE anteriores a SRGAN |
| GAN | Pérdidas de píxel, perceptuales y adversarias | Textura inventada y artefactos | SRGAN, Real-ESRGAN |
| Transformer | Las mismas pérdidas, con atención de largo alcance | El fallo que produzca su pérdida | SwinIR, Restormer |
| Modelo de vídeo recurrente | Características alineadas de muchos fotogramas | Emborronado o imágenes fantasma donde falla la alineación | BasicVSR++ |
| Difusión | Eliminación iterativa de ruido a partir de un prior de imagen o vídeo aprendido | Detalle que se aleja de la fuente, parpadeo, gran coste de cálculo | Upscale-A-Video, STAR, SeedVR2 |
Regresión con CNN y pérdida L1 o L2
Un píxel degradado es compatible con muchos originales nítidos: un borde podría estar un píxel a la izquierda o a la derecha, y una zona de piel podría tener los poros en un sinfín de disposiciones. Una red entrenada con pérdida L2 (MSE) recibe premio por predecir la media de esas posibilidades, y la media de muchas texturas nítidas colocadas en sitios distintos es lisa. L1 predice la mediana, lo que ayuda en los bordes, pero la textura cuya posición es incierta se sigue anulando. Los autores de SRGAN lo dicen sin rodeos: los resultados optimizados para MSE a menudo carecen de detalle de alta frecuencia y resultan poco satisfactorios a la vista.
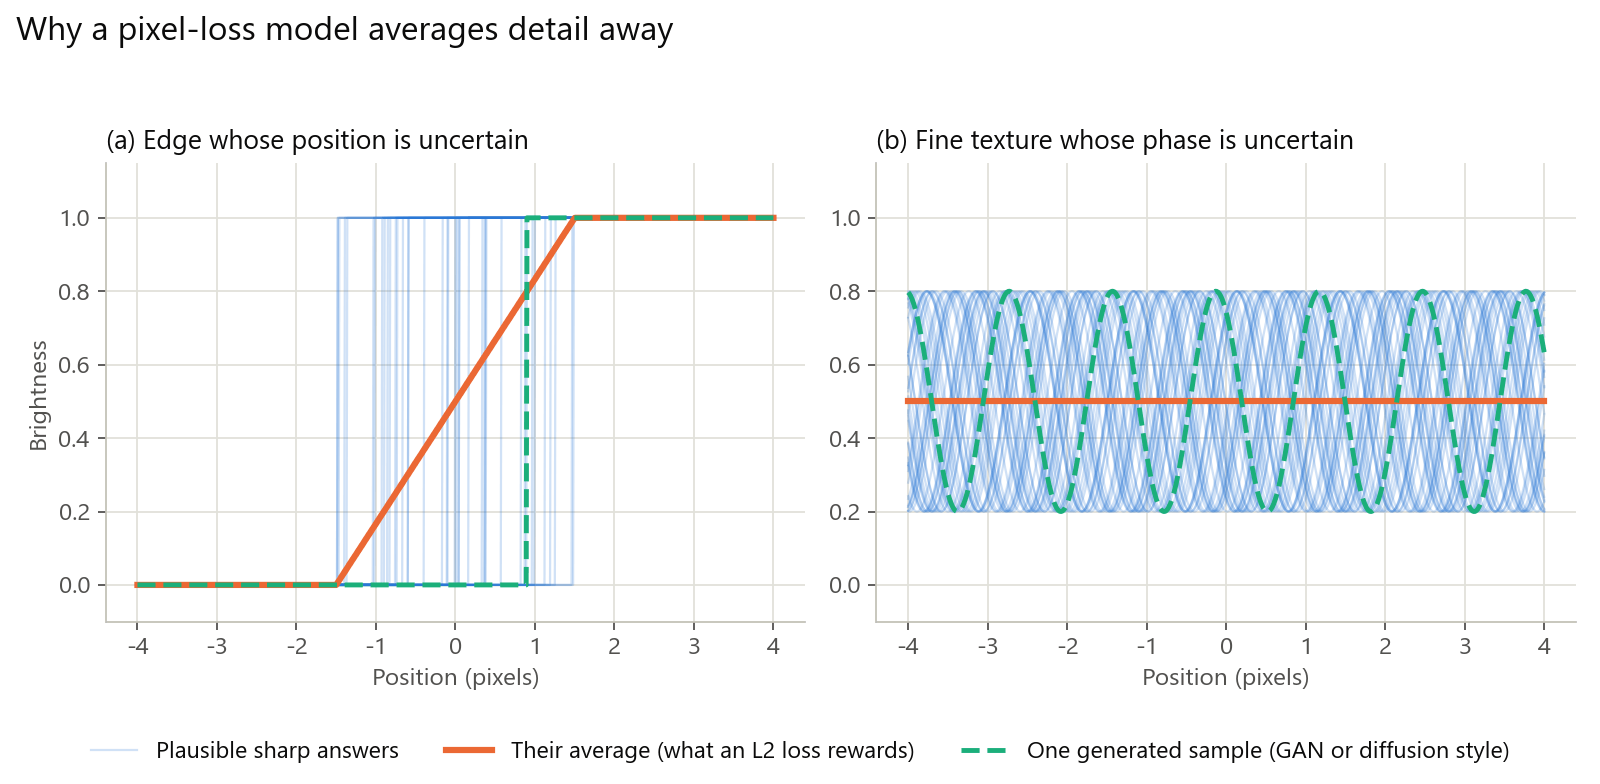
GAN: textura a partir de una pérdida adversaria
SRGAN añadió un discriminador que aprende a distinguir imágenes restauradas de fotos reales, además de una pérdida de contenido basada en la similitud perceptual en lugar de en los píxeles; sus autores describen el efecto como empujar la solución hacia la variedad de las imágenes naturales. El resultado se ve más nítido, pero la textura se genera para que sea plausible, no se recupera. Cuando el generador no está seguro, igualmente tiene que producir algo con aspecto de textura, y de ahí salen los patrones inventados y los bordes sobreafilados. Real-ESRGAN, entrenado con datos puramente sintéticos, simula además el ringing y el overshoot que arrastra el metraje real, de modo que aprende a eliminarlos.
Transformers y modelos de vídeo recurrentes
Los transformers como SwinIR y Restormer sustituyen la convolución por atención, que capta interacciones de largo alcance entre píxeles; Restormer señala que el coste de la atención estándar crece de forma cuadrática con la resolución, por lo que los transformers de restauración usan diseños de atención más eficientes. La arquitectura no decide por sí sola el aspecto plástico; lo decide la pérdida. En vídeo, los modelos recurrentes como BasicVSR++ propagan características hacia delante y hacia atrás a lo largo del clip con alineación deformable guiada por flujo óptico, así que un fotograma puede tomar prestado detalle real de sus vecinos en lugar de inventarlo. Donde falla la alineación, en movimientos rápidos u oclusiones, ese detalle prestado se emborrona o deja imágenes fantasma.
Restauración por difusión
Los modelos de difusión restauran eliminando ruido de forma iterativa a partir de un prior aprendido, y son los que generan el detalle fino más convincente. Esa virtud es también el riesgo. Los autores de Upscale-A-Video señalan que la aleatoriedad del muestreo de difusión complica la coherencia temporal, y exponen niveles de ruido para equilibrar restauración y generación. STAR apunta que los modelos de difusión de imagen entrenados con fotos fijas tienen problemas de coherencia temporal, y que los grandes backbones generativos pueden debilitar la fidelidad. El coste es el otro límite: los autores de SeedVR2 califican de prohibitivo el coste de inferencia de la restauración de vídeo por difusión, y por eso la destilan en un solo paso.
El compromiso entre percepción y distorsión
Blau y Michaeli demostraron que la distorsión (cuánto se aleja el resultado de la imagen verdadera) y la calidad perceptual (lo difícil que resulta distinguir el resultado de imágenes reales) están reñidas: a medida que baja la distorsión media, los resultados se vuelven más fáciles de distinguir de las imágenes reales. El resultado se cumple con cualquier medida de distorsión, no solo con PSNR o SSIM, y los autores muestran que las GAN ofrecen una vía fundamentada para acercarse a ese límite.
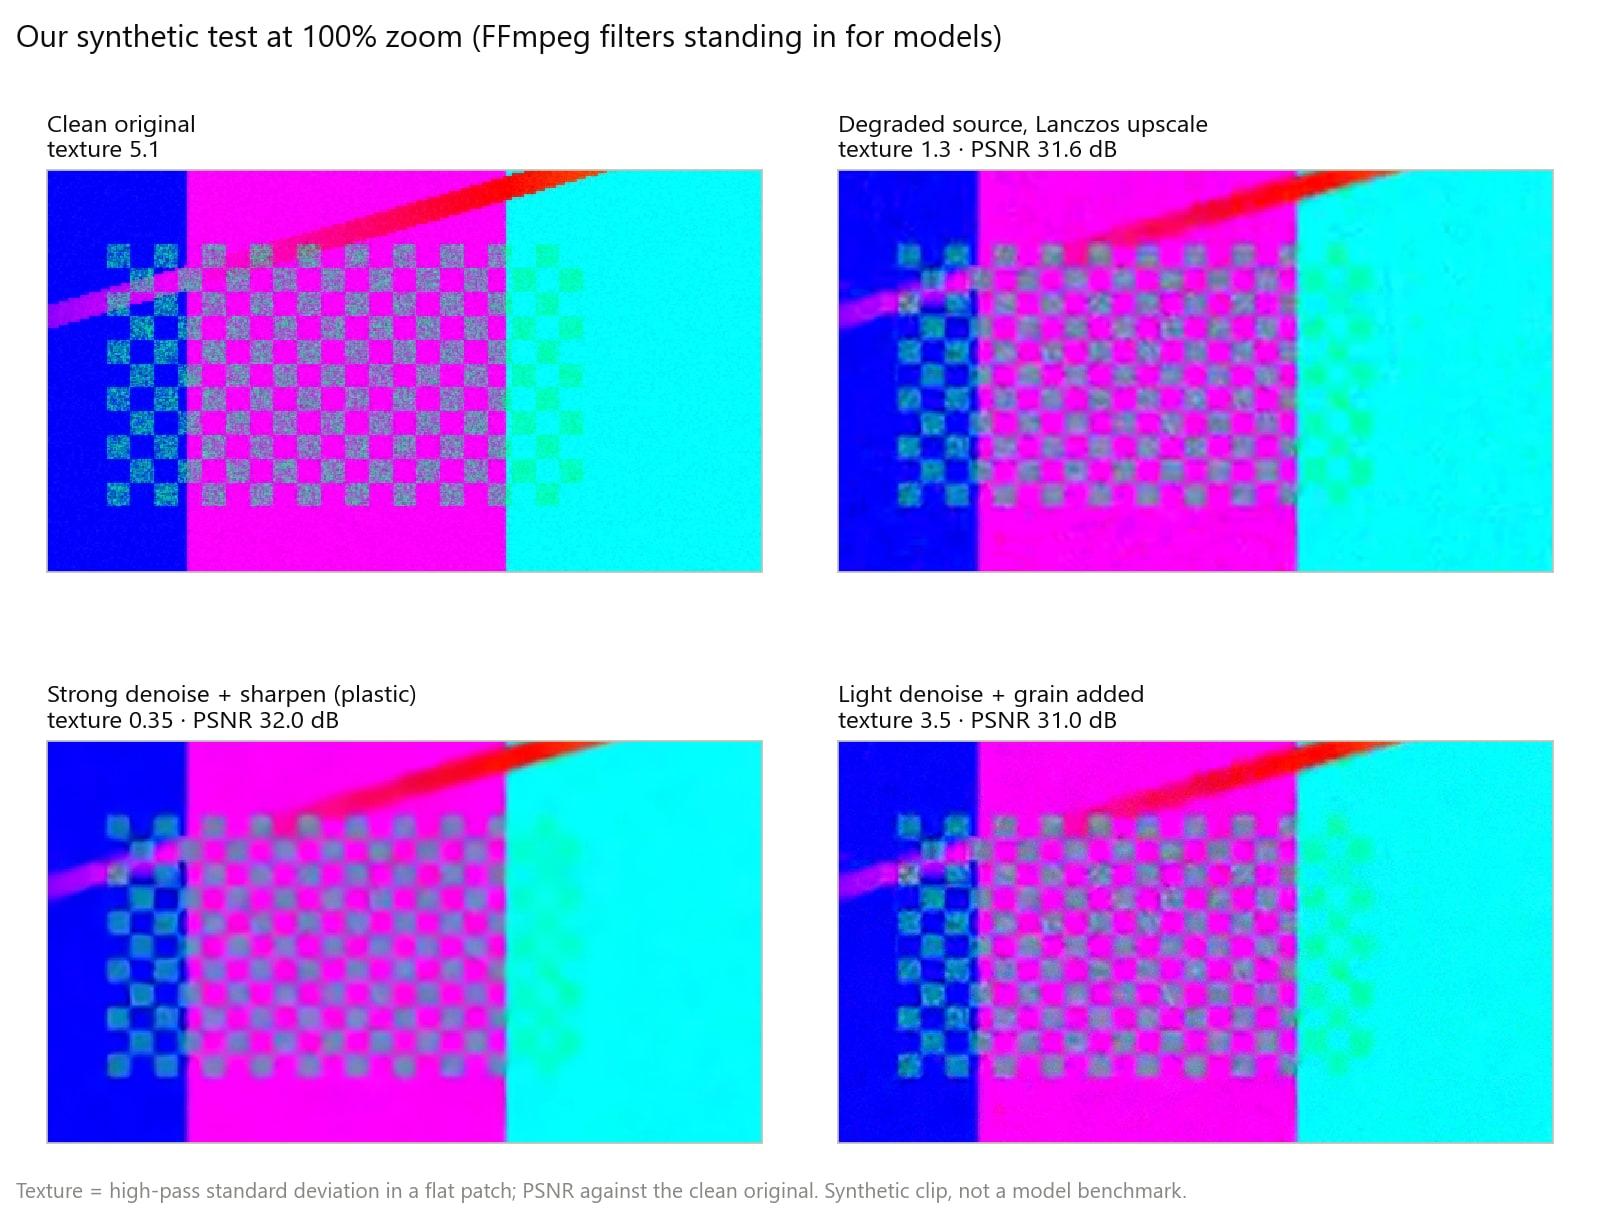
Reprodujimos el efecto con metraje sintético. Degradamos un clip de prueba con textura fina a la mitad de resolución, con ruido y una compresión fuerte, y luego lo «restauramos» de dos formas con filtros de FFmpeg en el papel de los modelos: una reducción de ruido fuerte con enfoque, y una reducción de ruido ligera con grano añadido después. Puntuados frente al original limpio:
| Versión | Textura fina (nuestra medida de paso alto) | PSNR frente al limpio | SSIM frente al limpio |
|---|---|---|---|
| Original limpio | 5,1 | Referencia | Referencia |
| Degradado, solo escalado Lanczos | 1,3 | 31,6 dB | 0,700 |
| Reducción de ruido fuerte y enfoque | 0,35 | 32,0 dB | 0,721 |
| Reducción de ruido ligera, grano añadido | 3,5 | 31,0 dB | 0,651 |
La versión sobresuavizada ganó en las dos métricas de píxel conservando más o menos una quinceava parte de la textura original; la versión con grano mantuvo la mayor parte de la energía de textura y obtuvo la puntuación más baja, porque el grano aleatorio no coincide píxel a píxel con el patrón original. Cuando dispone de una referencia limpia, por ejemplo tras degradar un clip a propósito para probar ajustes, la medición cabe en un solo comando:
ffmpeg -i restored.mp4 -i reference.mp4 -lavfi "[0:v][1:v]psnr" -f null -Use las métricas para detectar reescrituras grandes, no para ordenar estéticas; en cómo puntuamos la calidad de vídeo se explica por qué una puntuación de similitud mide cambio, no mejora.
Degradaciones no aprendidas y deriva de identidad
Degradaciones no aprendidas. Un modelo solo puede deshacer daños que ha aprendido. La respuesta de Real-ESRGAN fue un modelo de degradación de alto orden, que encadena desenfoque, redimensionado, ruido y compresión varias veces, porque el daño real es más complejo que una simple reducción de resolución. Cuando el metraje trae daños fuera de la mezcla de entrenamiento, como restos de entrelazado, mucho ruido de crominancia, una compresión poco habitual o grano de película, el modelo puede enfocarlos como si fueran detalle, o barrer la textura con ellos como si todo fuera ruido.
Deriva de identidad en las caras. Los restauradores de rostros llevan priors muy fuertes: GFPGAN se apoya en una GAN de caras preentrenada, y CodeFormer predice entradas de un codebook aprendido de partes de la cara. Ambos artículos plantean el resultado como un equilibrio entre calidad y fidelidad, y CodeFormer expone ese equilibrio como un control. Cuanto más fuerte es el prior, más se arrastra una cara pequeña o borrosa hacia una cara media plausible, con piel lisa, dientes regulares y ojos genéricos. Consulte cómo restaurar caras en un vídeo para saber qué revisar.
Qué está cambiando en 2026
- Difusión en un paso. La destilación y el post-entrenamiento adversario reducen la restauración por difusión a un solo paso; SeedVR2 informa de resultados comparables o superiores a los de los métodos de varios pasos. Una inferencia más barata hace viable el detalle de tipo difusión en clips largos, pero la cuestión de la fidelidad sigue ahí.
- Priors temporales. En lugar de modelos de imagen aplicados fotograma a fotograma, la superresolución de vídeo más reciente usa priors de vídeo: capas temporales y propagación recurrente en el espacio latente en Upscale-A-Video, o backbones de texto a vídeo en STAR.
- NPU en el propio equipo. La guía de Microsoft para PC Copilot+ describe NPU que superan los 40 billones de operaciones por segundo y señala que muchas trabajan con aritmética entera como INT8, por lo que los modelos se convierten a formatos de menor precisión para ejecutarse en ellas.
Cómo detectar un resultado plástico
| Dónde mirar al 100 % de zoom | Señal de plástico | Señal natural |
|---|---|---|
| Piel | Uniforme, sin poros, brillos de cera | Poros y pequeñas variaciones en mejillas y nariz |
| Pelo | Mechones apelmazados o textura pintada | Cabellos separados que se afinan en los bordes |
| Textos y logotipos | Letras redibujadas con formas erróneas | Formas que coinciden con la fuente, aunque se vean poco nítidas |
| Follaje y grava | Manchas emborronadas o un patrón que se repite | Detalle irregular que varía a lo largo del fotograma |
| Zonas planas como cielo o paredes | Bandas lisas, o textura que no estaba | Grano o ruido parecido al de la fuente |
| Movimiento | Textura que nada o centellea | Detalle que se mueve con el objeto |
Compare el mismo recorte de la fuente y del resultado. Escale la fuente con vecino más próximo para ver sus píxeles reales:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor,crop=480:270:760:400[a];[1:v]crop=480:270:760:400[b];[a][b]hstack" -frames:v 1 compare.pngUn mapa de diferencias muestra lo que la restauración ha quitado o añadido. El gris medio significa sin cambios; la estructura en zonas planas indica que se ha eliminado ruido o textura, y los patrones nuevos delatan detalle inventado:
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=bicubic,format=gray[a];[1:v]format=gray[b];[b][a]blend=all_mode=grainextract,eq=contrast=4" -frames:v 1 diff.pngEn nuestra prueba, el mapa de la versión sobresuavizada mostraba eliminados el ruido y los bloques de la fuente en las zonas planas, y también la textura de la zona del tablero de ajedrez.
Cómo evitarlo
Método 1: Baje la intensidad o mezcle con la fuente. Muchos restauradores exponen un control de intensidad o de fidelidad, como el equilibrio de fidelidad de CodeFormer o el nivel de ruido de Upscale-A-Video; use el ajuste más bajo que resuelva el problema. Si la herramienta no tiene ninguno, mezcle su salida con la fuente:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=lanczos,format=yuv420p[a];[1:v]format=yuv420p[b];[b][a]blend=all_expr='A*0.7+B*0.3'" -c:v libx264 -crf 16 -c:a copy blended.mp4Así se conserva el 70 % de la restauración y el 30 % de la fuente escalada. En nuestra prueba, la mezcla recuperó un poco de textura (0,63 frente a 0,35 según nuestra medida) y, de paso, parte del ruido de la fuente, así que conviene para casos leves.
Método 2: Conserve el grano, o añádalo al final. El grano disimula el aspecto ceroso y le da al codificador textura que conservar. Añada grano temporal fino solo a la luminancia y ajuste x264 para ello:
ffmpeg -i restored.mp4 -vf "noise=c0s=6:c0f=t" -c:v libx264 -crf 16 -tune grain -c:a copy regrained.mp4c0s=6 fija la intensidad del ruido de luminancia y c0f=t hace que cambie en cada fotograma; el ajuste grain de x264 rebaja el desbloqueo y las zonas muertas del cuantificador para que el grano fino sobreviva a la codificación. En nuestra prueba, la medida de textura subió de 0,35 a 3,5, frente a 5,1 del original limpio. Es grano nuevo, no detalle recuperado. Para distinguir antes el grano del ruido, consulte grano, ruido y artefactos de compresión.
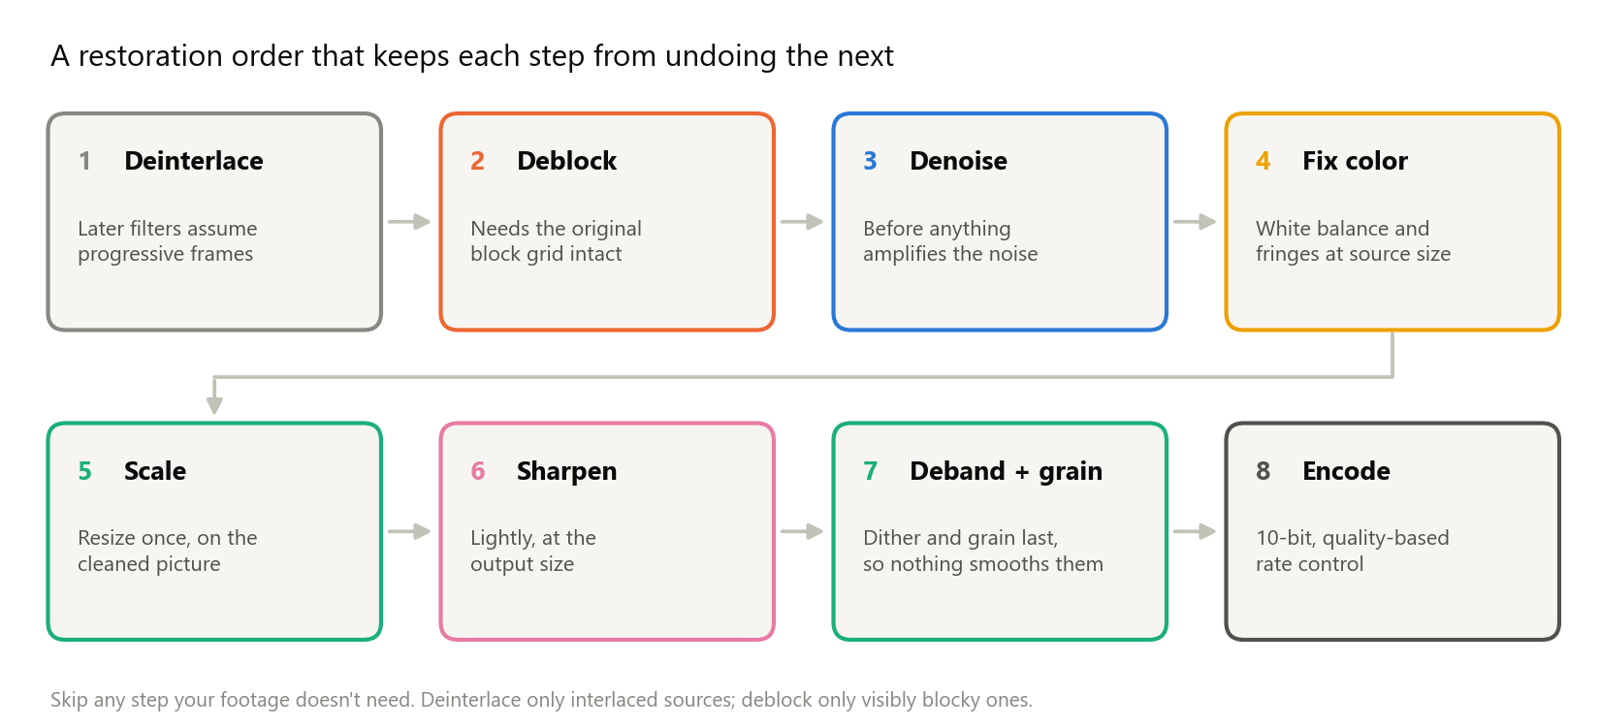
Método 3: Repare antes de escalar. Elimine los bloques de compresión y el ruido a la resolución de origen y luego escale. Un escalador que confunde bloques y ruido con detalle los agrandará y los enfocará.
Método 4: Juzgue en movimiento. La textura que centellea no se ve en un fotograma fijo. Ponga la fuente y el resultado uno junto a otro a la frecuencia de imagen de origen y mírelos al 100 %:
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor[a];[a][1:v]hstack" -c:v libx264 -crf 16 side_by_side.mp4Consejo: Revise primero las caras, los textos y el follaje. Es donde el detalle inventado se ve con más facilidad y se perdona con más dificultad.
Cómo lo aborda KwaFlux
- La Reparación inteligente trabaja a partir de los fotogramas vecinos. En Reparación de calidad, Reparación inteligente analiza el clip y combina reducción de ruido, enfoque, corrección de color y brillo, escalado y restauración de caras y de detalle fino. Al trabajar con los fotogramas vecinos, entra en la categoría de restauradores multifotograma descrita más arriba.
- Los tipos de Reparación por escena trabajan fotograma a fotograma. Anime, Escena nocturna, Quitar niebla, Quitar lluvia, Colorear y Eliminación de grano de película apuntan cada uno a un tipo de daño. Usar un tipo de escena con un metraje para el que no está pensado es una causa frecuente de caras de cera; qué tipo de reparación elegir explica cómo decidir.
- Previsualice antes de exportar. Renderice una vista previa de 1, 3 o 5 segundos. Las vistas previas de IA están limitadas por defecto a 15 fps, así que elija Igualar el origen antes de juzgar el movimiento o el centelleo.
- Tome la puntuación de similitud como un aviso. Con Comparar calidad tras la vista previa activado, cada vista previa muestra puntuaciones, entre ellas Similitud con el origen (VMAF), que la app describe así: «Más alto significa menos cambios, no mejor calidad». Una caída brusca señala una reescritura fuerte que merece revisarse al 100 % de zoom.
- Conserve el grano que quiera. Eliminación de grano de película elimina el grano por diseño. Si el grano forma parte del aspecto, no la use, y si el resultado queda demasiado limpio, vuelva a añadir grano tras exportar con el comando de FFmpeg de arriba.
Problemas habituales
| Problema | Causa probable | Solución |
|---|---|---|
| Piel cerosa, sin poros | Reducción de ruido demasiado fuerte o un resultado de tipo regresión | Baje la intensidad, mezcle con la fuente, añada grano fino |
| El pelo se convierte en mechones pintados | Textura inventada por un prior generativo | Baje la intensidad y compare con el recorte de la fuente |
| Las letras cambian de forma | El modelo redibujó un texto que no podía leer | Conserve la fuente en esa zona; un texto ilegible no se puede recuperar |
| La textura nada o centellea | Invención fotograma a fotograma sin coherencia temporal | Use un restaurador multifotograma y juzgue a la frecuencia de imagen de origen |
| El ruido se enfoca hasta parecer detalle sobreafilado | Daños que el modelo no aprendió | Reduzca primero el ruido o los bloques y luego escale |
| Una cara parece de otra persona | Un prior facial fuerte sobre una cara diminuta o borrosa | Baje la intensidad de la restauración facial y compruebe la identidad al 100 % de zoom |
Lo que esto no puede hacer
- Ningún restaurador recupera detalle que la cámara no captó. Predice detalle plausible.
- No hay un ajuste que sirva para todas las tomas. El metraje rico en textura y los gráficos planos fallan en direcciones distintas.
- Las métricas no saben elegir el resultado de aspecto natural. Las puntuaciones de píxel premian el suavizado, así que tienen que decidir sus ojos.
- El grano añadido no restaura la textura. Disimula el aspecto ceroso.
Conclusión
La restauración con IA parece de plástico cuando el promedio se impone a la textura, o cuando la textura inventada no encaja con la escena. Elija ajustes que conserven la fidelidad, compare al 100 % de zoom y en movimiento, y tome un fotograma limpio pero sin textura como una señal de alarma, no como un logro.
KwaFlux ejecuta la Reparación de calidad en su propia GPU. El procesamiento de IA corre en su propia GPU y sus archivos multimedia no se suben para procesarlos. Funciona en Windows 10 (64 bits, versión 1809 o posterior), Windows 11 y macOS 12 o posterior en Apple Silicon. Las vistas previas no requieren cuenta: renderice una vista previa de 1, 3 o 5 segundos de cualquier clip. Iniciar sesión con un plan de pago solo hace falta para exportar, convertir, reparar un archivo o descargar un archivo desde un enlace.
Pruebe con su propio metraje
Descargue KwaFlux y previsualice gratis los efectos en su propio material antes de pagar: sin cuenta, procesado en su GPU y sin subir sus archivos. Las vistas previas de vídeo duran 1, 3 o 5 segundos; las de estabilización, 5, 15 o 30 segundos.
Preguntas frecuentes
¿Un PSNR o SSIM más alto indica una restauración de más calidad?
No necesariamente. Las métricas de píxel premian los resultados que, de media, se acercan a la referencia, y las medias son lisas. En nuestra prueba sintética, un resultado sobresuavizado superó en PSNR y en SSIM a otro con más grano y más natural. Tome las puntuaciones como un control de cambios grandes; en cómo puntuamos la calidad de vídeo se explica por qué.
¿Qué restaura mejor el vídeo, la difusión o las GAN?
Depende. Los modelos de difusión suelen generar un detalle más convincente, pero cuestan más de ejecutar y pueden alejarse de la fuente o parpadear entre fotogramas. Las GAN son más rápidas, pero inventan textura cuando se las fuerza. En vídeo, la coherencia temporal importa tanto como el detalle.
¿Añadir grano de película quita el aspecto de plástico?
En parte. El grano fino disimula las superficies cerosas y le da al codificador textura que conservar, pero es textura aleatoria nueva, no detalle recuperado, así que no corrige formas erróneas ni una cara cambiada. Añádalo al final, después de cualquier escalado.
¿Por qué centellea el detalle restaurado al reproducir el vídeo?
Porque un modelo que reconstruye cada fotograma por separado inventa una textura ligeramente distinta cada vez, y el ojo percibe esos cambios como centelleo o como una textura que nada. Los modelos multifotograma, que toman detalle prestado de fotogramas vecinos alineados, lo reducen; por eso conviene juzgar a la frecuencia de imagen de origen.
¿Por qué un vídeo con ruido se ve peor al escalarlo?
Porque un escalador que confunde el ruido o los bloques de compresión con detalle los agranda y los enfoca junto con la imagen. Limpie primero la imagen a su resolución original, escale después y, si lo desea, añada grano al final.
Fuentes
- Blau and Michaeli, "The Perception-Distortion Tradeoff," CVPR 2018 (distortion and perceptual quality are at odds for any distortion measure) (consultado el 2026-10-21)
- Ledig et al., "Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (MSE results lack high-frequency detail; adversarial and content losses) (consultado el 2026-10-21)
- Wang et al., "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data" (high-order degradation model, ringing and overshoot) (consultado el 2026-10-21)
- Liang et al., "SwinIR: Image Restoration Using Swin Transformer" (consultado el 2026-10-21)
- Zamir et al., "Restormer: Efficient Transformer for High-Resolution Image Restoration" (long-range interactions, quadratic cost) (consultado el 2026-10-21)
- Chan et al., "BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment" (consultado el 2026-10-21)
- Wang et al., "Towards Real-World Blind Face Restoration with Generative Facial Prior" (GFP-GAN; realness and fidelity) (consultado el 2026-10-21)
- Zhou et al., "Towards Robust Blind Face Restoration with Codebook Lookup Transformer" (CodeFormer; controllable fidelity and quality) (consultado el 2026-10-21)
- Zhou et al., "Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution" (temporal consistency, noise levels) (consultado el 2026-10-21)
- Xie et al., "STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution" (image diffusion and temporal consistency) (consultado el 2026-10-21)
- Wang et al., "SeedVR2: One-Step Video Restoration via Diffusion Adversarial Post-Training" (one-step restoration, inference cost) (consultado el 2026-10-21)
- Microsoft Learn, "Copilot+ PCs developer guide" (NPUs above 40 TOPS, INT8 models) (consultado el 2026-10-21)
- FFmpeg Filters Documentation (`psnr`, `blend`, `noise`, `nlmeans`, `unsharp`) (consultado el 2026-10-21)
- x264 source, x264.c help text (`--tune grain` settings) (consultado el 2026-10-21)
UpMás en Escalado y reparación
Siga leyendo
Reducir ruido, quitar bloques, enfocar y corregir el color: los filtros de restauración de vídeo a fondo
Cómo funcionan la reducción de ruido, el desbloqueo, el debanding, el enfoque, el balance de blancos y la aberración cromática, y en qué orden.
4K vs 8K: qué cambia de verdad en pantalla y cuándo compensa escalar a 8K
4K vs 8K explicado con cálculo de píxeles, bitrates y tamaños de archivo. Cuándo compensa el 8K, cuándo basta el 4K y cómo exportar un escalado a 8K.
Cómo escalar un vídeo de 720p a 1080p (y cuándo detenerse ahí)
Escale vídeo de 720p a 1080p con KwaFlux, HandBrake o FFmpeg: ajustes exactos, la tasa de bits de exportación y cuándo no compensa seguir hasta 4K.