AI 修復がのっぺりしたプラスチックっぽさになる理由:損失関数、GAN、拡散モデルと防ぎ方
AI 修復した動画がろう人形のように見える原因を、平均化された細部、GAN の質感、拡散モデルのずれ、学習データの不一致から解説。見分け方と防ぎ方も紹介します。
要点
AI 修復がプラスチックのように見えるのは、モデルが本物の質感を作り直すより速く取り除いてしまうときです。肌はろうのようになり、髪は束に固まり、グレインや木の葉は滑らかなかたまりににじんで、きれいなのにどこか作り物の映像になります。原因はよくわかっていて、学習の損失関数、モデルの系統、そして映像に合わない学習データの 3 つです。
- 「プラスチックっぽさ」とは、修復によって細かな質感(毛穴、髪、グレイン、木の葉)が平均化されて消えるか、シーンに合わない作り物の質感に置き換わった状態です。
- ピクセル誤差(L1 や L2)だけで学習したモデルは、ありうる答えすべての平均を予測します。平均は滑らかです。GAN や拡散モデルは質感を足し戻しますが、その一部は作り物です。
- Blau と Michaeli は、どんな歪みの尺度でも「歪みの小ささ」と「リアルさ」が引っ張り合うことを証明しました。どの結果が自然に見えるかを、1 つのスコアで判断することはできません。
- 映像に合わない学習データと、ありがちな顔に引き寄せる顔の事前知識も、大きな原因です。
- 100% 表示と再生中の動きで判断し、強度を下げるかソースと混ぜ、グレインを残すか足し戻し、アップスケールの前に修復します。
AI 修復の「プラスチックっぽさ」とは?
プラスチックっぽい結果とは、修復した画像の表面が実際のシーンより滑らかで均一になり、肌、布、髪、木の葉から、物の実在感を生む小さく不規則な質感が失われた状態です。輪郭はくっきりしていることが多く、後述の FFmpeg テストでも、強いノイズ除去とシャープ化をかけると市松模様のエッジだけが硬く残り、そのあいだの細かな質感は消えました。滑らかな塗りをシャープな境界が囲んでいると、目はそれをろう細工や CG のように感じます。
モデルの系統ごとの失敗のしかた
| モデルの系統 | 何から学ぶか | 無理をさせたときの典型的な失敗 | 例 |
|---|---|---|---|
| CNN 回帰 | ピクセル損失(L1、L2 または MSE) | 平均化された滑らかな質感 | SRGAN 以前の MSE 学習ネットワーク |
| GAN | ピクセル損失、知覚損失、敵対的損失 | 作り物の質感とアーティファクト | SRGAN、Real-ESRGAN |
| Transformer | 同じ損失に、長距離のアテンションを加える | 損失関数が生む失敗がそのまま出る | SwinIR、Restormer |
| 再帰型の動画モデル | 複数フレームから位置合わせした特徴 | 位置合わせに失敗した部分でにじみや残像 | BasicVSR++ |
| 拡散モデル | 学習した画像・動画の事前分布からの反復ノイズ除去 | ソースから離れた細部、ちらつき、重い計算 | Upscale-A-Video、STAR、SeedVR2 |
L1・L2 損失の CNN 回帰
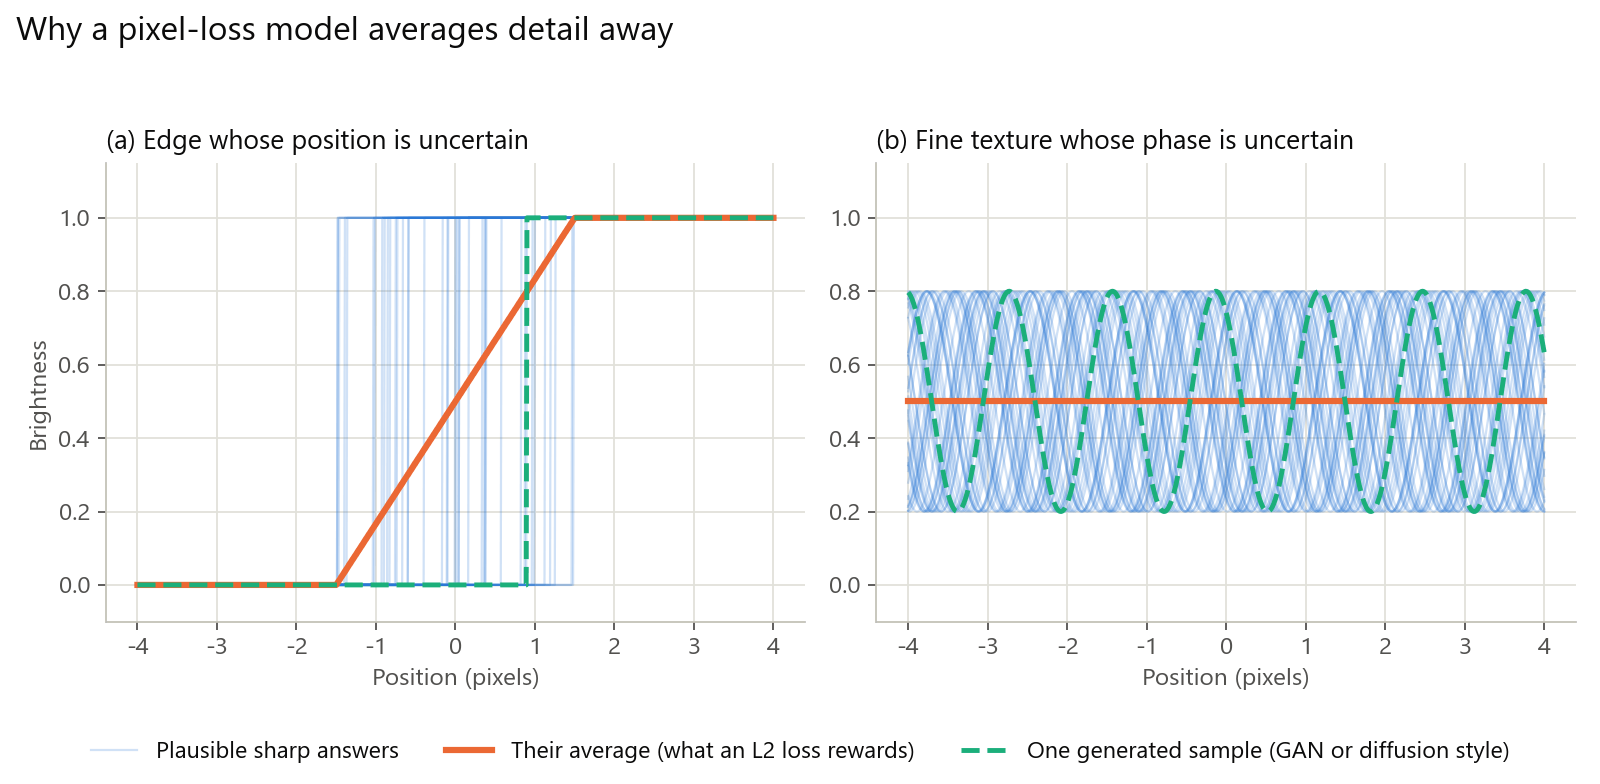
劣化した 1 つのピクセルに当てはまるシャープな元画像はたくさんあります。エッジは 1 ピクセル左にあったかもしれないし右にあったかもしれず、肌の一部の毛穴の並び方は無数に考えられます。L2(MSE)損失で学習したネットワークは、それらの可能性の平均を予測すると得をするように学びます。位置がばらばらのシャープな質感をたくさん平均すれば、滑らかになります。L1 は中央値を予測するのでエッジには効きますが、位置の定まらない質感はやはり打ち消し合います。SRGAN の著者もはっきり書いています。MSE で最適化した結果は高周波のディテールを欠くことが多く、見た目に物足りない、と。
GAN:敵対的損失が生む質感
SRGAN は、修復画像と本物の写真を見分けることを学ぶ識別器を加え、さらにピクセルではなく知覚的な類似度にもとづくコンテンツ損失を使いました。著者はその効果を、解を自然画像の多様体へ押しやるものだと説明しています。出力はシャープに見えますが、その質感はもっともらしく生成されたもので、取り戻されたものではありません。生成器は確信がなくても質感らしきものを出さなければならず、作り物の模様やザラついたエッジはそこから生まれます。完全な合成データで学習した Real-ESRGAN は、実際の映像にあるリンギングやオーバーシュートも模擬しているので、それらを取り除くことを学んでいます。
Transformer と再帰型の動画モデル
SwinIR や Restormer などの Transformer は、畳み込みをアテンションに置き換えて、離れたピクセル同士の関係をとらえます。Restormer によれば、標準的なアテンションの計算量は解像度に対して 2 乗で増えるため、修復用の Transformer はより効率のよいアテンションの設計を使います。のっぺり感を決めるのはアーキテクチャそのものではなく、損失関数です。動画では、BasicVSR++ のような再帰型モデルが、オプティカルフローに導かれた変形可能な位置合わせでクリップの前後方向に特徴を伝えるので、フレームは細部を作り出す代わりに隣のフレームから本物の細部を借りられます。速い動きや遮蔽で位置合わせに失敗すると、借りた細部がにじんだり残像になったりします。
拡散モデルによる修復
拡散モデルは、学習した事前分布から反復的にノイズを取り除いて修復し、もっとも説得力のある細部を生成します。その強みはリスクでもあります。Upscale-A-Video の著者は、拡散のサンプリングのランダム性が時間的な一貫性を難しくすると指摘し、修復と生成のバランスを取るためにノイズレベルを調整できるようにしています。STAR は、静止画で学習した画像拡散モデルは時間的一貫性に苦労すること、大きな生成バックボーンは忠実度を弱めうることを指摘しています。もう 1 つの制約はコストです。SeedVR2 の著者は拡散による動画修復の推論コストを法外なものと呼び、そのため 1 ステップに蒸留しています。
知覚と歪みのトレードオフ
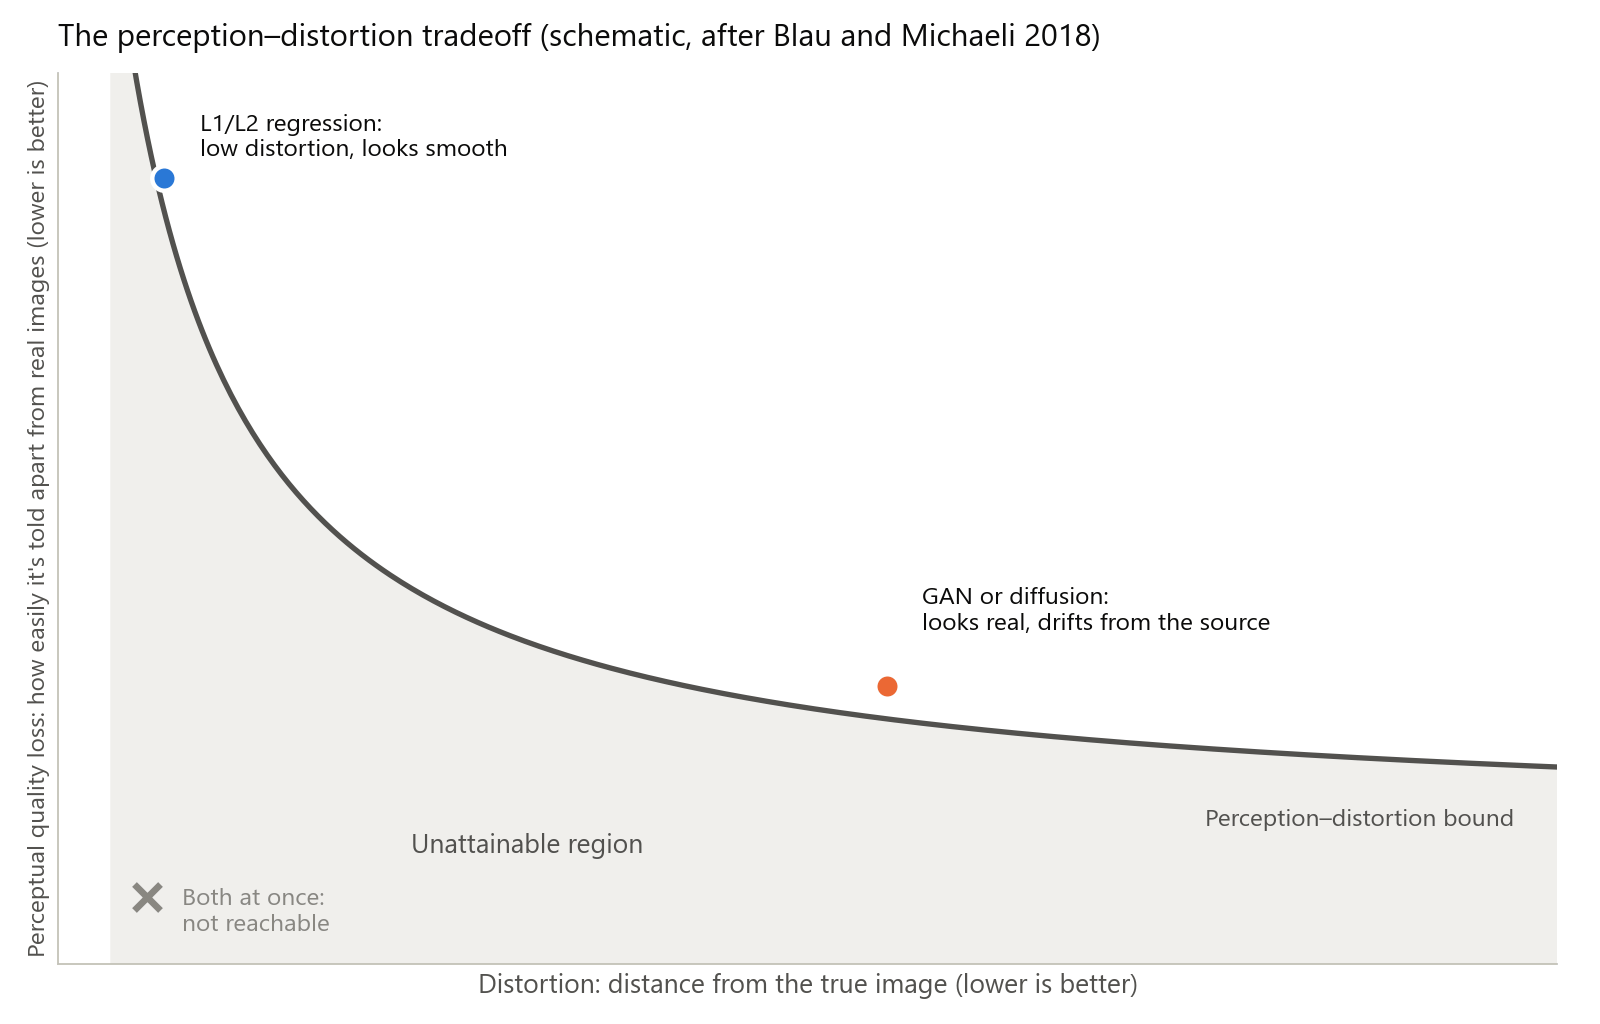
Blau と Michaeli は、歪み(出力が真の画像からどれだけ離れているか)と知覚品質(出力を本物の画像と見分けるのがどれだけ難しいか)が相反することを証明しました。平均の歪みが小さくなるほど、出力は本物の画像と見分けやすくなります。この結果は PSNR や SSIM だけでなく、どんな歪みの尺度にも当てはまります。著者は、GAN がその限界に近づくための理にかなった方法であることも示しています。
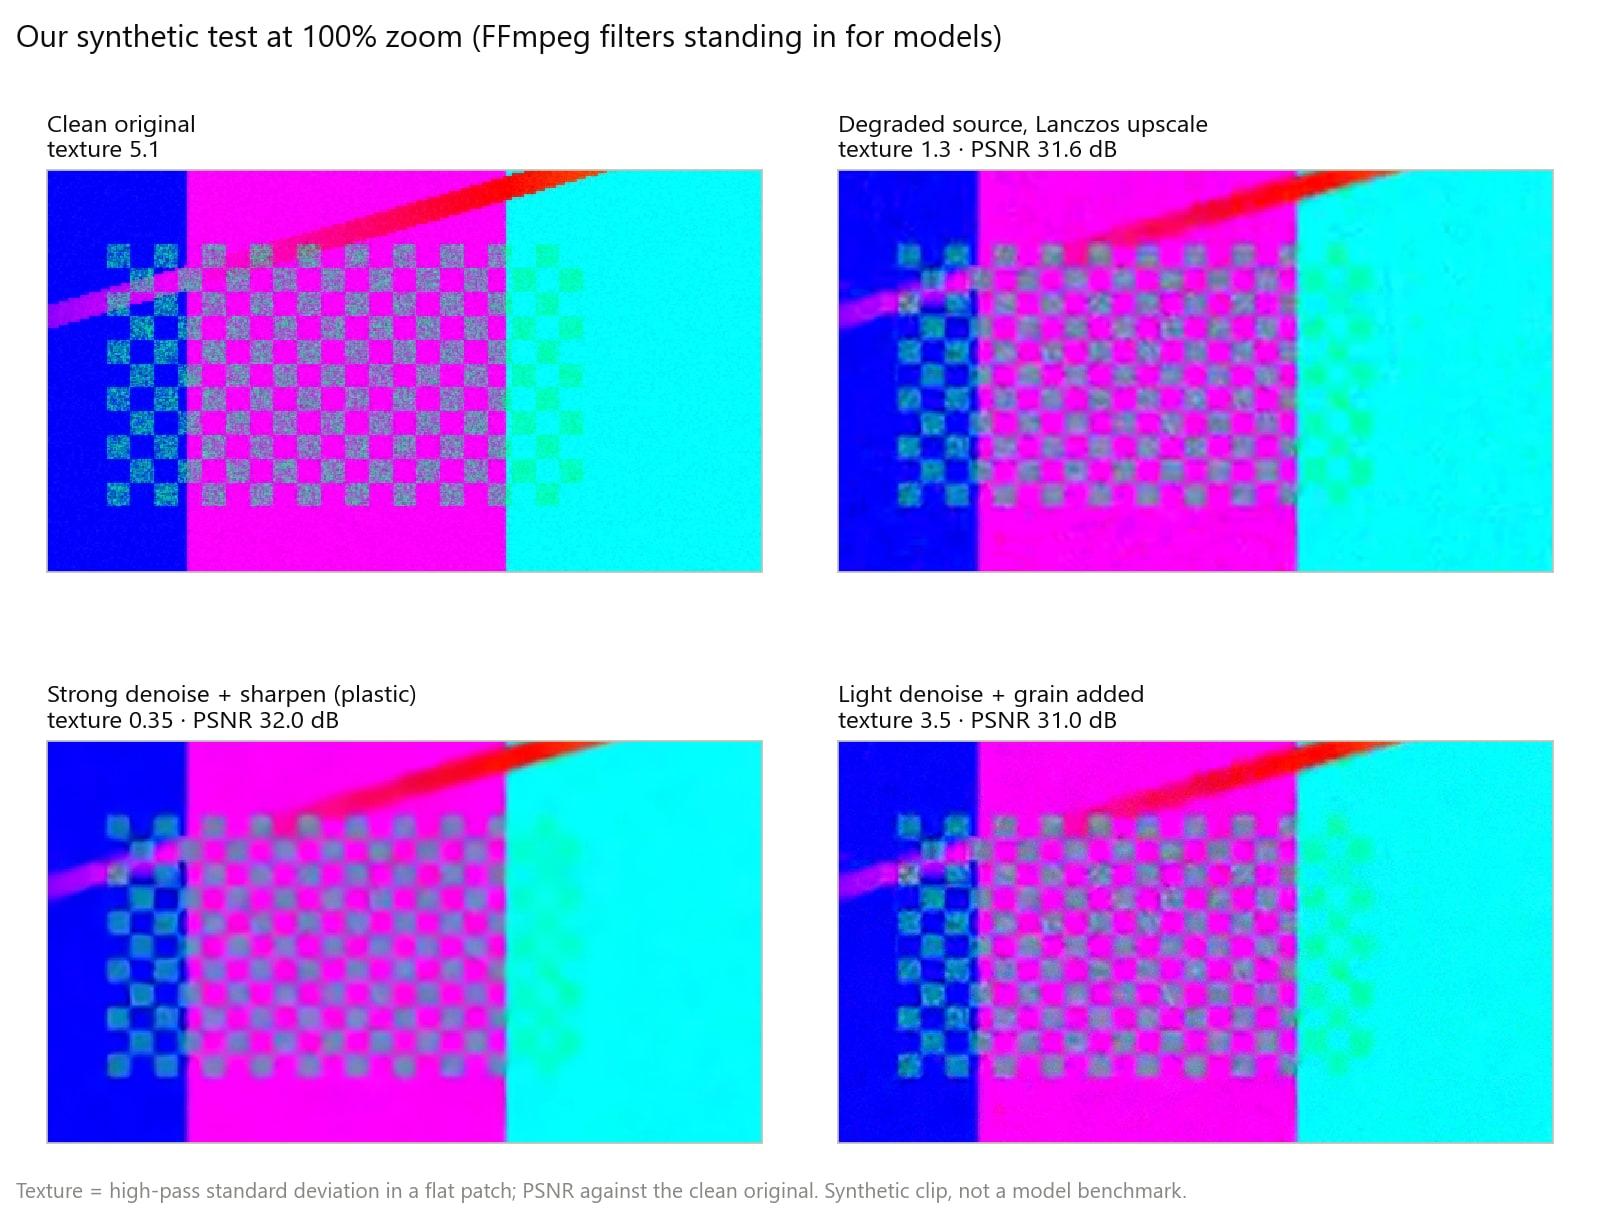
私たちは合成映像でこの効果を再現しました。細かい質感のあるテストクリップを、ノイズと強い圧縮をかけて半分の解像度に劣化させ、モデルの代わりに FFmpeg のフィルターで 2 通りに「修復」しました。強いノイズ除去とシャープ化、そして軽いノイズ除去とグレインの足し戻しです。きれいな元映像と比べたスコアは次のとおりです。
| バージョン | 細かい質感(独自のハイパス指標) | きれいな元映像との PSNR | きれいな元映像との SSIM |
|---|---|---|---|
| きれいな元映像 | 5.1 | 基準 | 基準 |
| 劣化させ、Lanczos でアップスケールしただけ | 1.3 | 31.6 dB | 0.700 |
| 強いノイズ除去とシャープ化 | 0.35 | 32.0 dB | 0.721 |
| 軽いノイズ除去、グレイン追加 | 3.5 | 31.0 dB | 0.651 |
滑らかにしすぎたバージョンは、元の質感の約 15 分の 1 しか残していないのに、2 つのピクセル指標の両方で勝ちました。グレイン版は質感のエネルギーの大半を残したのにスコアは最低でした。ランダムなグレインは、元の模様とピクセル単位では一致しないからです。テストのためにわざとクリップを劣化させた場合のように、きれいな基準映像があれば、測定はコマンド 1 つで済みます。
ffmpeg -i restored.mp4 -i reference.mp4 -lavfi "[0:v][1:v]psnr" -f null -指標は大きな書き換えを見つけるために使い、見た目の順位付けには使わないでください。類似度スコアが測るのは改善ではなく変化の量である理由は、動画品質のスコアの付け方 で説明しています。
劣化の不一致と顔の別人化
劣化の不一致。 モデルが元に戻せるのは、学習した種類の損傷だけです。Real-ESRGAN は、実際の損傷は単純な縮小よりも複雑だという理由で、ぼかし、リサイズ、ノイズ、圧縮を何度も連ねる高次の劣化モデルで対応しました。インターレースの名残、強い色ノイズ、珍しい圧縮、フィルムグレインのように、学習の範囲外の損傷を含む映像では、モデルがそれを細部とみなしてシャープにしたり、すべてをノイズとみなして質感ごと消したりすることがあります。
顔の別人化。 顔の修復モデルは強い事前知識を持ち込みます。GFPGAN は事前学習済みの顔 GAN を利用し、CodeFormer は学習済みの顔パーツのコードブックから要素を予測します。どちらの論文も結果を品質と忠実度のバランスとして位置づけ、CodeFormer はそのトレードオフを調整項目として用意しています。事前知識が強いほど、小さい顔やぼやけた顔は、滑らかな肌、整った歯、ありがちな目を持つ「もっともらしい平均顔」に引き寄せられます。確認すべき点は 動画の顔を修復する方法 をご覧ください。
2026 年に変わりつつあること
- 1 ステップの拡散。 蒸留と敵対的な事後学習で、拡散による修復を 1 ステップにまで減らせるようになりました。SeedVR2 は、複数ステップの手法と同等かそれ以上の結果を報告しています。推論が安くなれば長いクリップでも拡散型の細部が実用的になりますが、忠実度の問題は残ります。
- 時間方向の事前知識。 画像モデルを 1 フレームずつ回す代わりに、新しい動画超解像は動画の事前知識を使います。Upscale-A-Video の時間方向のレイヤーと再帰的な潜在表現の伝播や、STAR のテキストから動画を生成するバックボーンなどです。
- デバイス上の NPU。 Microsoft の Copilot+ PC 開発者ガイドは、毎秒 40 兆回を超える演算を行う NPU について説明し、その多くが INT8 のような整数演算で動くため、モデルを低精度の形式に変換して実行すると述べています。
のっぺりした結果の見分け方
| 100% 表示で見る場所 | のっぺりのサイン | 自然なサイン |
|---|---|---|
| 肌 | 均一で毛穴がなく、ろうのようなハイライト | 頬や鼻に毛穴や細かなばらつきがある |
| 髪 | 束に固まった毛や描いたような質感 | 1 本ずつ分かれ、毛先に向かって細くなる |
| 文字やロゴ | 文字が違う形に描き直されている | ぼやけていてもソースと同じ形 |
| 木の葉や砂利 | にじんだかたまりや繰り返し模様 | 画面の場所ごとに違う不規則な細部 |
| 空や壁などの平らな部分 | 滑らかな帯状の段差、またはもともとなかった質感 | ソースと似たグレインやノイズ |
| 動き | 質感が泳ぐ、またはきらきらと揺らぐ | 細部が物体と一緒に動く |
ソースと結果の同じ部分を切り出して比べます。ソース本来のピクセルが見えるよう、ソースはニアレストネイバーで拡大します。
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor,crop=480:270:760:400[a];[1:v]crop=480:270:760:400[b];[a][b]hstack" -frames:v 1 compare.png差分マップを作ると、修復で何が消え、何が加わったかがわかります。中間のグレーは変化なし、平らな部分に模様が見えればノイズや質感が消されたこと、新しい模様があれば作り物の細部です。
ffmpeg -ss 2 -i source.mp4 -ss 2 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=bicubic,format=gray[a];[1:v]format=gray[b];[b][a]blend=all_mode=grainextract,eq=contrast=4" -frames:v 1 diff.png私たちのテストでは、滑らかにしすぎたバージョンのマップに、平らな部分にあったソースのノイズとブロック、そして市松模様の部分の質感が、すべて消された跡として現れました。
防ぎ方
方法 1:強度を下げるか、ソースと混ぜる。 修復ツールの多くは、CodeFormer の忠実度のトレードオフや Upscale-A-Video のノイズレベルのように、強度や忠実度の調整項目を備えています。問題が直る範囲でいちばん低い設定を使ってください。調整項目がないツールなら、出力をソースと混ぜます。
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=lanczos,format=yuv420p[a];[1:v]format=yuv420p[b];[b][a]blend=all_expr='A*0.7+B*0.3'" -c:v libx264 -crf 16 -c:a copy blended.mp4これで修復結果が 70%、アップスケールしたソースが 30% になります。私たちのテストでは、混ぜることで質感が少し戻りました(独自指標で 0.35 に対して 0.63)が、ソースのノイズも一緒に戻ったので、軽いケースに向いています。
方法 2:グレインを残すか、最後に足し戻す。 グレインはろうのような見た目を隠し、エンコーダーに残すべき質感を与えます。細かい時間変化するグレインを輝度だけに加え、x264 をグレイン向けにチューニングします。
ffmpeg -i restored.mp4 -vf "noise=c0s=6:c0f=t" -c:v libx264 -crf 16 -tune grain -c:a copy regrained.mp4c0s=6 は輝度ノイズの強さ、c0f=t はフレームごとにノイズを変える設定です。x264 の grain チューニングはデブロッキングと量子化のデッドゾーンを弱め、細かなグレインがエンコード後も残るようにします。私たちのテストでは、質感の指標が 0.35 から 3.5 に上がりました(きれいな元映像は 5.1)。これは新しく加えたグレインで、取り戻した細部ではありません。先にグレインとノイズを見分けるには、グレイン・ノイズ・圧縮アーティファクトの違い をご覧ください。
方法 3:アップスケールの前に修復する。 圧縮ブロックとノイズをソースの解像度で取り除いてから、アップスケールします。ブロックやノイズを細部とみなすアップスケーラーは、それらを拡大してシャープにしてしまいます。
方法 4:動きの中で判断する。 質感のちらつきは静止画では見えません。ソースと結果をソースのフレームレートで横に並べ、100% 表示で見てください。
ffmpeg -i source.mp4 -i restored.mp4 -filter_complex "[0:v]scale=1280:720:flags=neighbor[a];[a][1:v]hstack" -c:v libx264 -crf 16 side_by_side.mp4ヒント: まず顔、文字、木の葉を確認してください。作り物の細部がもっとも見つけやすく、もっとも見過ごせない場所です。
KwaFlux での扱い
- スマート修復は隣接フレームを使います。 画質修復の スマート修復 は、クリップを解析し、ノイズ除去、シャープ化、色と明るさの調整、アップスケール、顔と細部の修復を組み合わせます。隣接フレームを使うので、上で説明した複数フレーム型の修復にあたります。
- シーン修復の各タイプは 1 フレームずつ処理します。 アニメ、夜景、かすみ除去、雨除去、カラー化、フィルムグレイン除去 は、それぞれ 1 種類の損傷を対象にしています。想定外の映像にシーンタイプを使うと、顔がろうのようになる原因になりがちです。選び方は どの修復タイプを選ぶか で説明しています。
- 書き出す前にプレビューします。 1・3・5 秒のプレビューを出してください。AI のプレビューは既定で 15 fps に制限されているので、動きやちらつきを判断する前に 元のフレームレート を選びます。
- 類似度スコアは目印として扱います。 プレビュー後に画質を自動比較 をオンにすると、プレビューごとに ソースとの近似度 (VMAF) などのスコアが表示されます。アプリはこれを「高いほど変化が少なく、画質が良いという意味ではありません」と説明しています。急に下がったら大きく書き換えられた印なので、100% 表示で確認する価値があります。
- 残したいグレインは残します。 フィルムグレイン除去 は、その名のとおりグレインを取り除きます。グレインが映像の味の一部なら使わずにおき、結果がきれいすぎるときは書き出し後に上の FFmpeg コマンドでグレインを足し戻してください。
よくあるトラブルと対処
| 問題 | 考えられる原因 | 対処 |
|---|---|---|
| 毛穴のないろうのような肌 | ノイズ除去が強すぎる、または回帰型の結果 | 強度を下げ、ソースと混ぜ、細かいグレインを加える |
| 髪が描いたような束になる | 生成型の事前知識が作った質感 | 強度を下げ、ソースの切り出しと比べる |
| 文字の形が変わる | 読めない文字をモデルが描き直した | その部分はソースを残す。読めない文字は取り戻せない |
| 質感が泳ぐ、ちらつく | 時間的一貫性のないフレームごとの生成 | 複数フレーム型の修復を使い、ソースのフレームレートで判断する |
| ノイズがザラついた細部としてシャープになる | モデルが学習していない損傷 | 先にノイズ除去やブロック除去をしてからアップスケールする |
| 顔が別人に見える | 小さい顔やぼやけた顔に強い顔の事前知識が働いた | 顔の修復の強度を下げ、100% 表示で本人らしさを確認する |
できないこと
- カメラが捉えなかった細部を取り戻せる修復ツールはありません。 予測するのは、もっともらしい細部です。
- どのショットにも合う設定はありません。 質感の多い映像と平らなグラフィックでは、失敗の方向が逆になります。
- 自然に見える結果を指標で選ぶことはできません。 ピクセルのスコアは滑らかさを評価するので、最後はご自身の目で判断する必要があります。
- グレインを加えても質感は戻りません。 ろうのような見た目を隠すだけです。
まとめ
AI 修復がのっぺり見えるのは、平均化が質感に勝ったとき、またはシーンに合わない質感が作り出されたときです。忠実度を保つ設定を選び、100% 表示と動きの中で比べ、きれいでも質感のないフレームは成功ではなく警告として受け止めてください。
KwaFlux はご自身の GPU で画質修復を実行します。AI 処理はご自身の GPU 上で実行され、メディアファイルが処理のためにアップロードされることはありません。Windows 10(64 ビット、バージョン 1809 以降)、Windows 11、Apple Silicon 搭載の macOS 12 以降で動きます。プレビューにアカウントは不要です。どのクリップでも 1・3・5 秒のプレビューを出せます。ログインと有料プランが必要なのは、書き出し、変換、ファイル修復、リンクからのファイルダウンロードだけです。
ご自身の素材で効果をテスト
KwaFlux を入手し、支払う前に自分の素材で効果を無料プレビュー。アカウント不要、処理はご自身の GPU で行い、メディアはアップロードしません。 動画のプレビューは 1、3、または5 秒、手ぶれ補正のプレビューは 5、15、または30 秒から選べます。
よくある質問
PSNR や SSIM が高ければ修復の質も高い?
そうとは限りません。ピクセル指標は平均して基準に近い出力を評価し、平均は滑らかです。私たちの合成テストでも、滑らかにしすぎた結果が、グレインのあるより自然な結果に PSNR と SSIM の両方で勝ちました。スコアは大きな変化のチェックとして扱ってください。理由は 動画品質のスコアの付け方 で説明しています。
動画修復には GAN と拡散モデルのどちらがいい?
場合によります。拡散モデルはたいていより説得力のある細部を生成しますが、実行コストが高く、ソースから離れたり、フレーム間でちらついたりすることがあります。GAN は速いものの、無理をさせると質感を作り出します。動画では、細部と同じくらい時間的一貫性が重要です。
フィルムグレインを足せばのっぺり感は直る?
一部は直ります。細かいグレインはろうのような表面を隠し、エンコーダーに残すべき質感を与えますが、新しいランダムな質感であって取り戻した細部ではないので、形の誤りや変わってしまった顔は直せません。拡大縮小をすべて終えてから、最後に加えてください。
修復した細部が再生中にちらつくのはなぜ?
フレームを 1 枚ずつ単独で作り直すモデルは、毎回わずかに違う質感を作り出し、目はその変化をちらつきや泳ぎとして感じるからです。位置合わせした隣接フレームから細部を借りる複数フレーム型のモデルなら抑えられるので、ソースのフレームレートで判断してください。
ノイズの多い動画をアップスケールすると悪化するのはなぜ?
ノイズや圧縮ブロックを細部と取り違えたアップスケーラーが、映像と一緒にそれらを拡大してシャープにするからです。先に元の解像度で映像をきれいにしてからアップスケールし、グレインが欲しければ最後に加えてください。
参考資料
- Blau and Michaeli, "The Perception-Distortion Tradeoff," CVPR 2018 (distortion and perceptual quality are at odds for any distortion measure) (2026-10-21 閲覧)
- Ledig et al., "Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (MSE results lack high-frequency detail; adversarial and content losses) (2026-10-21 閲覧)
- Wang et al., "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data" (high-order degradation model, ringing and overshoot) (2026-10-21 閲覧)
- Liang et al., "SwinIR: Image Restoration Using Swin Transformer" (2026-10-21 閲覧)
- Zamir et al., "Restormer: Efficient Transformer for High-Resolution Image Restoration" (long-range interactions, quadratic cost) (2026-10-21 閲覧)
- Chan et al., "BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment" (2026-10-21 閲覧)
- Wang et al., "Towards Real-World Blind Face Restoration with Generative Facial Prior" (GFP-GAN; realness and fidelity) (2026-10-21 閲覧)
- Zhou et al., "Towards Robust Blind Face Restoration with Codebook Lookup Transformer" (CodeFormer; controllable fidelity and quality) (2026-10-21 閲覧)
- Zhou et al., "Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution" (temporal consistency, noise levels) (2026-10-21 閲覧)
- Xie et al., "STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution" (image diffusion and temporal consistency) (2026-10-21 閲覧)
- Wang et al., "SeedVR2: One-Step Video Restoration via Diffusion Adversarial Post-Training" (one-step restoration, inference cost) (2026-10-21 閲覧)
- Microsoft Learn, "Copilot+ PCs developer guide" (NPUs above 40 TOPS, INT8 models) (2026-10-21 閲覧)
- FFmpeg Filters Documentation (`psnr`, `blend`, `noise`, `nlmeans`, `unsharp`) (2026-10-21 閲覧)
- x264 source, x264.c help text (`--tune grain` settings) (2026-10-21 閲覧)
Up「画質と高解像度化」のほかの記事
続けて読む
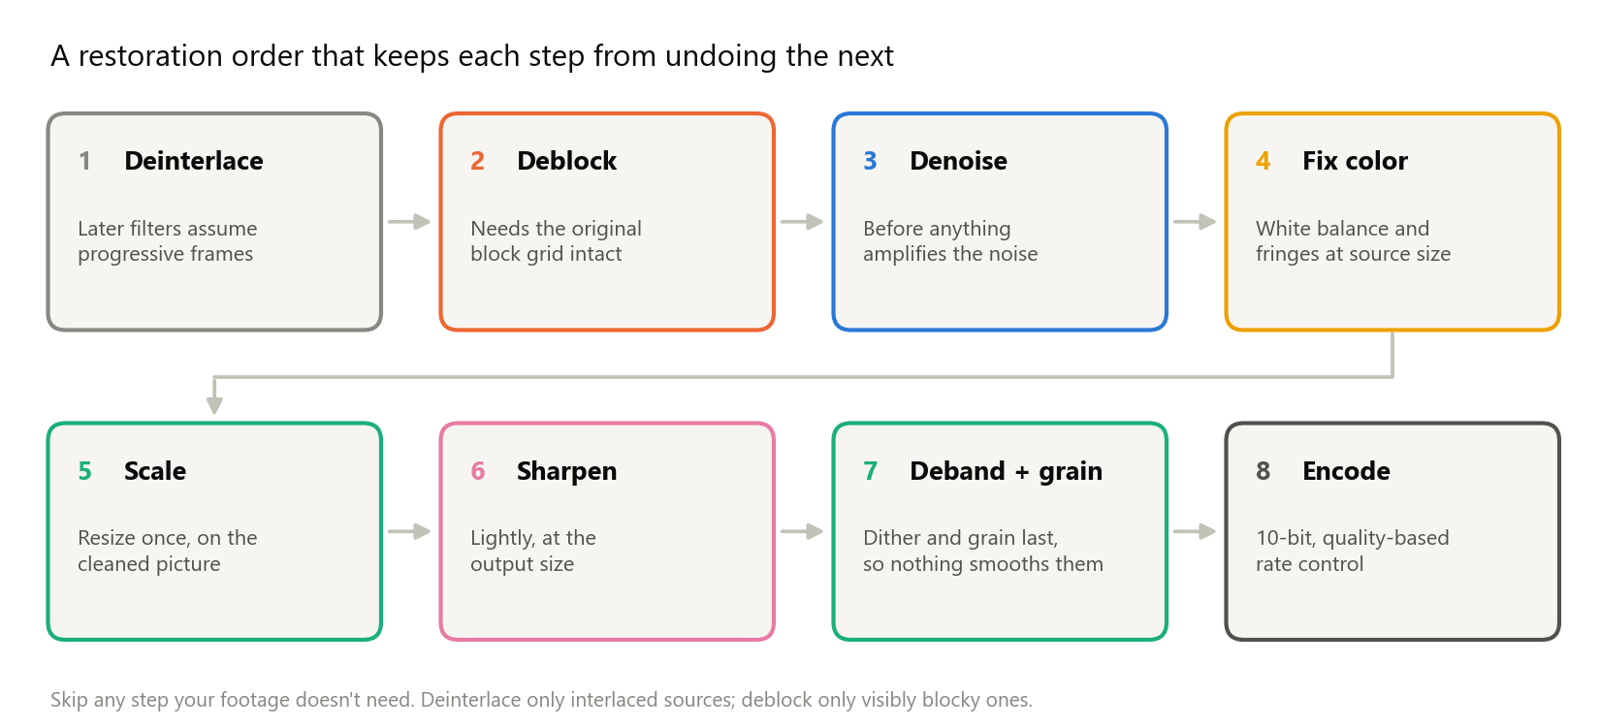
ノイズ除去、ブロック除去、シャープ化、色補正:動画修復フィルターを深掘り
ノイズ除去、ブロック除去、バンディング除去、シャープ化、ホワイトバランス、色収差の修正のしくみと、かける順番を FFmpeg のテスト結果とともに解説します。
4K と 8K の違い:画面で実際に変わること、8K アップスケールに意味があるのはいつか
4K と 8K の違いを画素数、ビットレート、ファイルサイズで解説。8K を選ぶ価値がある場面、4K で十分な場面、8K アップスケールの書き出し方を紹介します。
720p の動画を 1080p にアップスケールする方法(と、そこで止めるべきとき)
KwaFlux、HandBrake、FFmpeg で 720p の動画を 1080p にアップスケールする方法。具体的な設定、書き出すビットレート、4K まで上げる価値がないときを解説します。