Ein Frame muss nicht nach Hause: Wie KwaFlux Video vom Dekodieren bis zum Kodieren auf der GPU hält
Ein 4K-Frame mit 10 Bit hat rund 24,9 MB, und jeder Weg zwischen RAM und GPU kostet Zeit. So hält KwaFlux die Pixel auf der GPU.
Das Wichtigste in Kürze
Eine durchgehende GPU-Videopipeline hält die Pixel vom Dekodieren über Bildbearbeitung und KI-Inferenz bis zum Kodieren im GPU-Speicher, statt sie zwischen Arbeitsspeicher und Grafikkarte hin und her zu kopieren. Weniger Kopien bedeuten schnellere Exporte, flüssigere Vorschauen und eine entlastete CPU.
In diesem Leitfaden erfahren Sie, wie die Medien-Engine von KwaFlux das umsetzt: ein Frame-Adapter, mit dem neun Frame-Typen dieselbe Sprache sprechen, wie Hardware-Dekoder und -Encoder dreier GPU-Hersteller bewertet und ausgewählt werden, die fünfstufige Interop-Leiter zwischen D3D11 und OpenGL, VideoToolbox und Metal auf dem Mac und wie der Player HDR auf den Bildschirm bringt. Am Ende stehen der vollständige Weg eines Pixels durch einen Export und die Einstellungen, die Sie in KwaFlux ändern können.
- Ein 4K-Frame mit 10 Bit und 4:2:0 hat rund 24,9 MB. Bei 60 fps bewegt jeder Weg zwischen Arbeitsspeicher und GPU-Speicher etwa 1,5 GB pro Sekunde. Je mehr Wege, desto langsamer der Export und desto ruckeliger die Vorschau.
- Die Medien-Engine von KwaFlux gibt jedem Frame einen Ausweis: CUDA-Zeiger, D3D11-Textur, Metal-Textur oder Arbeitsspeicher. Die oberen Schichten sehen nur „einen Frame“, und braucht eine andere API ihn, wählt die Engine die Brücke mit dem geringsten Aufwand.
- Unter Windows werden Hardware-Dekodierung und -Kodierung für NVIDIA, Intel, AMD sowie die System-APIs D3D11 und D3D12 als Plug-ins mitgeliefert. Sie werden nach GPU, Speicher und Auflösung bewertet; scheitert eines, kommt das nächste, und am Ende fängt die Software-Dekodierung den Rest auf.
- Eine D3D11-Textur gelangt über eine fünfstufige Leiter nach OpenGL: NVIDIA-Zero-Copy, Beinahe-Zero-Copy für AMD und Intel, ein Umweg über CUDA, asynchrone Übertragung und ein CPU-Fallback. Schnelle Rechner nehmen die oberen Stufen, ältere die unteren, und das Bild läuft in beiden Fällen weiter.
- Zero-Copy gilt nicht für jeden Pfad: Die beiden unteren Stufen gehen über den Arbeitsspeicher. Eine durchgehende GPU-Pipeline heißt, so weit wie möglich auf der GPU zu bleiben und sonst Stufe für Stufe auszuweichen, statt abzubrechen.
Warum es teuer ist, einen Pixel nach Hause zu schicken
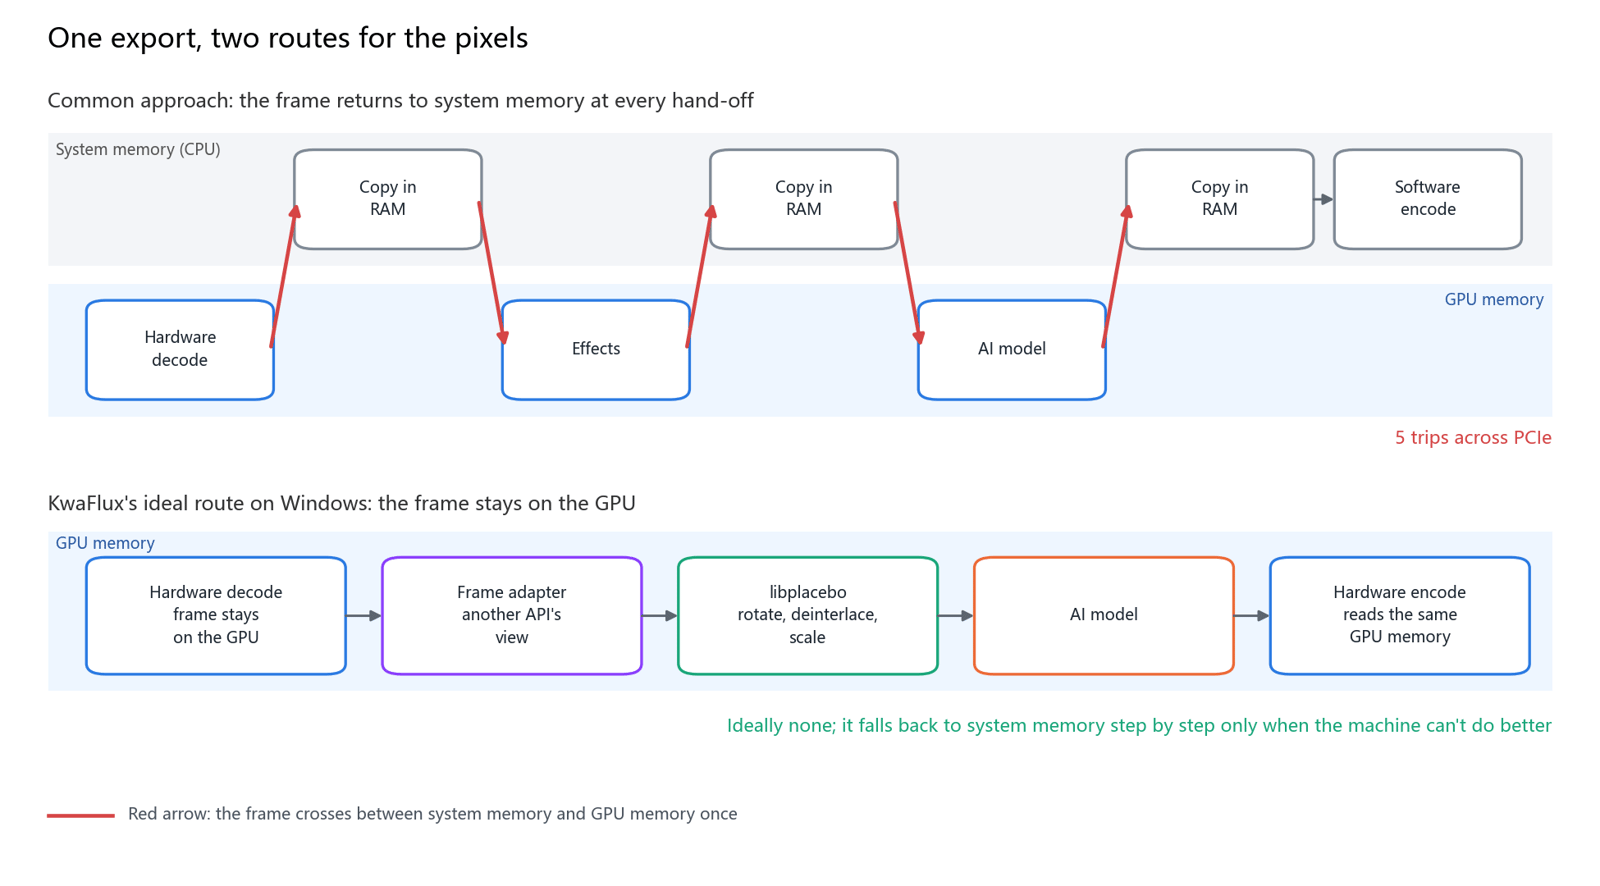
Ein Pixel geht nach Hause, wenn ein Frame aus dem GPU-Speicher in den Arbeitsspeicher kopiert, dort bearbeitet und wieder hochgeladen wird. Hardware-Dekoder schreiben das Bild in den GPU-Speicher, KI-Modelle und Bildfilter laufen auf der GPU, und Hardware-Encoder lesen ebenfalls aus dem GPU-Speicher. Akzeptiert auch nur ein Schritt dazwischen nur Pixel im Arbeitsspeicher, muss der Frame einmal über PCIe hin und zurück.
So groß ist ein Frame (bei 4:2:0 kommt für die Farbdifferenz die halbe Luma-Größe dazu):
| Format | Ein Frame | Pro Weg bei 30 fps | Pro Weg bei 60 fps |
|---|---|---|---|
| 1080p, 8 Bit NV12 | 3,1 MB | 93 MB/s | 187 MB/s |
| 4K, 8 Bit NV12 | 12,4 MB | 373 MB/s | 746 MB/s |
| 4K, 10 Bit P010 | 24,9 MB | 746 MB/s | 1,49 GB/s |
| 4K, RGBA mit halber Genauigkeit (üblich bei KI- und HDR-Verarbeitung) | 66,4 MB | 1,99 GB/s | 3,98 GB/s |
PCIe 4.0 x16 bietet theoretisch rund 31,5 GB/s pro Richtung. Das klingt reichlich, ist aber ein Spitzenwert; jede Kopie wartet außerdem darauf, dass die GPU ihre laufende Arbeit beendet und der Treiber synchronisiert, und die CPU muss alles organisieren. Die obere Hälfte der Abbildung zeigt einen üblichen Ansatz: Dekodierung, Effekte, KI und Kodierung wollen jeweils ihren eigenen Speicher, und ein Frame überquert in einem einzigen Export fünfmal PCIe. Bei 4K mit 10 Bit und 60 fps sind das allein fürs Kopieren rund 7,5 GB pro Sekunde.
Der Frame-Adapter: neun Frame-Typen, ein Frame
Der Frame-Adapter ist eine Schicht in der Medien-Engine von KwaFlux, durch die ein Frame für Player, Effekte und Encoder gleich aussieht, egal in welchem Speicher er tatsächlich liegt. Mediensoftware ist voller Dialekte: FFmpeg spricht AVFrame, NVIDIA CUDA-Gerätezeiger, die Hardware-Dekoder von Intel und AMD liefern D3D11-Texturen, Vulkan spricht VkImage und Apple CVPixelBuffer. Jede Variante hat ihre eigene Lebensdauer, Ausrichtung und Farbanordnung.
| Frame-Typ | Wo er liegt | Wer ihn erzeugt |
|---|---|---|
| FFmpeg-Frame | Ein AVFrame im Arbeitsspeicher | Software-Dekodierung und jeder Fallback-Pfad |
| D3D11-Frame | Eine ID3D11Texture2D | Hardware-Dekodierung per D3D11VA, Intel und AMD unter Windows |
| D3D12-Frame | Eine D3D12-Ressource | D3D12-Videodekodierung |
| CUDA-Frame | Ein CUDA-Gerätezeiger | NVDEC-Dekodierung von NVIDIA; native Eingabe für NVENC |
| OpenGL-Frame | Eine Textur oder ein Framebuffer-Objekt | Filter, Vorschauen und plattformübergreifendes Rendering |
| Vulkan-Frame | Ein VkImage | Vulkan-Videodekodierung und -Rendering |
| Metal-Frame | Eine MTLTexture | Anzeige und HDR unter macOS |
| CVPixel-Frame | Ein CVPixelBuffer | VideoToolbox-Dekodierung unter macOS |
| OpenCV-Frame | Eine cv::Mat | Algorithmen, die Pixel direkt lesen |
Die oberen Schichten bekommen eine einzige Frame-Schnittstelle und fragen bei Bedarf nach einer anderen Form; die Brücke mit dem geringsten Aufwand auf dem jeweiligen Rechner wählt die Engine. Ein paar Designentscheidungen sorgen dafür, dass das auch beim dritten GPU-Hersteller nicht zusammenbricht:
- Typen stehen zur Kompilierzeit fest. Eine schnittstellenübergreifende Abfrage ist eine statische Umwandlung statt Laufzeit-Typinformation, deshalb gerät an DLL-Grenzen nichts aneinander.
- Nur Frames, die GPU-Ressourcen besitzen, haben GPU-Operationen. Klonen, Umwandeln und der Export in eine Matrix gehören zu den konkreten Frame-Typen, nicht zur gemeinsamen Schnittstelle.
- Besitzverhältnisse sind eindeutig. Wer reserviert, gibt frei, und gemeinsam genutzte Handles werden nicht doppelt freigegeben. Wird ein GPU-Gerät neu aufgebaut, werden die davon abhängigen Interop-Ressourcen mit ihm ungültig und neu erstellt, sodass keine Textur des alten Geräts am neuen hängen bleibt.
Windows: Hardware-Dekodierung und -Kodierung für drei GPU-Hersteller
Unter Windows installiert KwaFlux acht Videodekoder- und sechs Videoencoder-Plug-ins, jedes eine eigene DLL. Nach dem Demuxen richtet sich die Auswahl nach der Konfiguration; steht sie auf Automatisch, bewertet sie jeden Kandidaten, probiert den mit der höchsten Punktzahl zuerst und wechselt zum nächsten, wenn die Initialisierung scheitert. Was übrig bleibt, fängt die Software-Dekodierung auf.
| Dekoder-Plug-in | Erzeugter Frame | Codecs |
|---|---|---|
| NVIDIA NVDEC | CUDA-Frame, 8 Bit NV12 oder 10 Bit P016 | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D11VA (Hardware-Dekodierung des Systems) | D3D11-NV12-Textur | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D12VA | D3D12-Ressource | H.264, HEVC, VP9, AV1 |
| Intel oneVPL (aktuelle Intel-GPUs) | D3D11-Textur | H.264, HEVC, VP9, AV1, MJPEG |
| Intel Media SDK (integrierte Grafik von Core der 5. bis 10. Generation) | D3D11-Textur | H.264, HEVC, MPEG-2, MJPEG |
| AMD AMF | D3D11-Textur, direkt in eine AMF-Surface gepackt | H.264, HEVC, VP9, AV1, MPEG-2 |
| Vulkan Video | Vulkan-Image | H.264, HEVC |
| FFmpeg-Software-Dekodierung | Frame im Arbeitsspeicher | Alles, was FFmpeg liest, einschließlich VP8 und VP9 mit Alphakanal |
Die Tabelle zeigt, was jedes Plug-in beherrscht; ob Ihre GPU einen Codec in Hardware dekodieren kann, hängt von ihrer Generation ab. Laut der Support-Matrix von NVIDIA dekodieren Consumer-Karten AV1 zum Beispiel erst ab der RTX-30-Serie in Hardware.
Was in die Bewertung eingeht. Der falsche Hersteller scheidet sofort aus: Auf einer GPU, die nicht von NVIDIA stammt, erhält NVDEC null Punkte. Hardware-Dekoder verlieren Punkte, wenn der GPU-Speicher knapp ist, und mit einer starken CPU kann die Software-Dekodierung gewinnen, damit der Rechner nicht nur deshalb ausgebremst wird, weil „Hardware“ draufsteht. 4K bringt der Hardware Punkte, denn genau dann sollen die Festfunktionseinheiten arbeiten. Wird über D3D11 angezeigt, bekommt D3D11VA Punkte dazu, und Dekodieren auf einer anderen GPU als der, die den Bildschirm ansteuert, kostet Punkte, weil Kopien zwischen GPUs ein Nachteil sind.
Kodieren: Der Encoder nimmt, was der Dekoder geliefert hat.
| Encoder-Plug-in | Bevorzugte Eingabe | Ausgabe-Codecs |
|---|---|---|
| NVIDIA NVENC | CUDA-Frames; nimmt auch D3D11-, D3D12-, Vulkan-, OpenGL- und Arbeitsspeicher-Frames | H.264, HEVC, AV1 |
| Intel oneVPL | D3D11-Texturen auf derselben GPU, auf der GPU kopiert | H.264, HEVC, AV1, VP9, MJPEG |
| AMD AMF | D3D11-Texturen direkt in AMF-Surfaces gepackt, Pakete asynchron abgeholt | H.264, HEVC, AV1 |
| Intel Media SDK | D3D11-Texturen oder Arbeitsspeicher-Frames | H.264, HEVC, MPEG-2, MJPEG |
| Vulkan Video | Vulkan-Frames | H.264, HEVC |
| FFmpeg-Software-Kodierung | Frames im Arbeitsspeicher | Was die Software-Encoder unterstützen |
An NVENC sieht man am deutlichsten, warum der Frame-Adapter zählt: Nicht jeder Frame muss zuerst zu CUDA werden. Ein CUDA-Frame wird auf dem Gerät per 2D-Kopie übernommen, ein D3D11-Frame per Interop, D3D12 läuft über D3D11 nach CUDA, Vulkan nutzt externen Speicher, OpenGL eine Pixelpuffer-Brücke. Nur ein Frame, der ohnehin im Arbeitsspeicher liegt, wird einmal hochgeladen. Bei HEVC und AV1 landen HDR-Mastering- und Content-Light-Daten in der Encoder-Konfiguration; H.264 hat dafür kein natives Feld, deshalb schreibt das Plug-in sie selbst in SEI.
Randnotiz: Laut der Support-Matrix von NVIDIA erlauben GeForce-Karten mit Encoder höchstens 12 gleichzeitige Kodiersitzungen. Sind die Sitzungen aufgebraucht, tritt das NVENC-Plug-in von KwaFlux zurück und übergibt die Arbeit an den nächsten Encoder, statt mitten im Export abzubrechen.
Plug-ins tragen eine Versionsprüfung und werden bei Abweichung nicht geladen, und die Fähigkeitsprüfung bewertet ein Plug-in, ohne es zu laden. Eine neue GPU-Generation bedeutet ein zusätzliches Plug-in; Player und Konverter darüber ändern sich nicht.
Die fünfstufige Leiter: eine D3D11-Textur nach OpenGL bringen
Dekoder und Anzeige-API passen oft nicht zusammen: NVIDIA dekodiert in CUDA oder D3D11, das Bild soll aber nach OpenGL; Intel dekodiert in D3D11, während ein Filter auf einer OpenGL-Textur läuft. Der Grafikkern von KwaFlux baut die Brücke, und zwischen D3D11 und OpenGL ist das eine fünfstufige Leiter, die so weit hinaufgeht, wie der Rechner es zulässt:
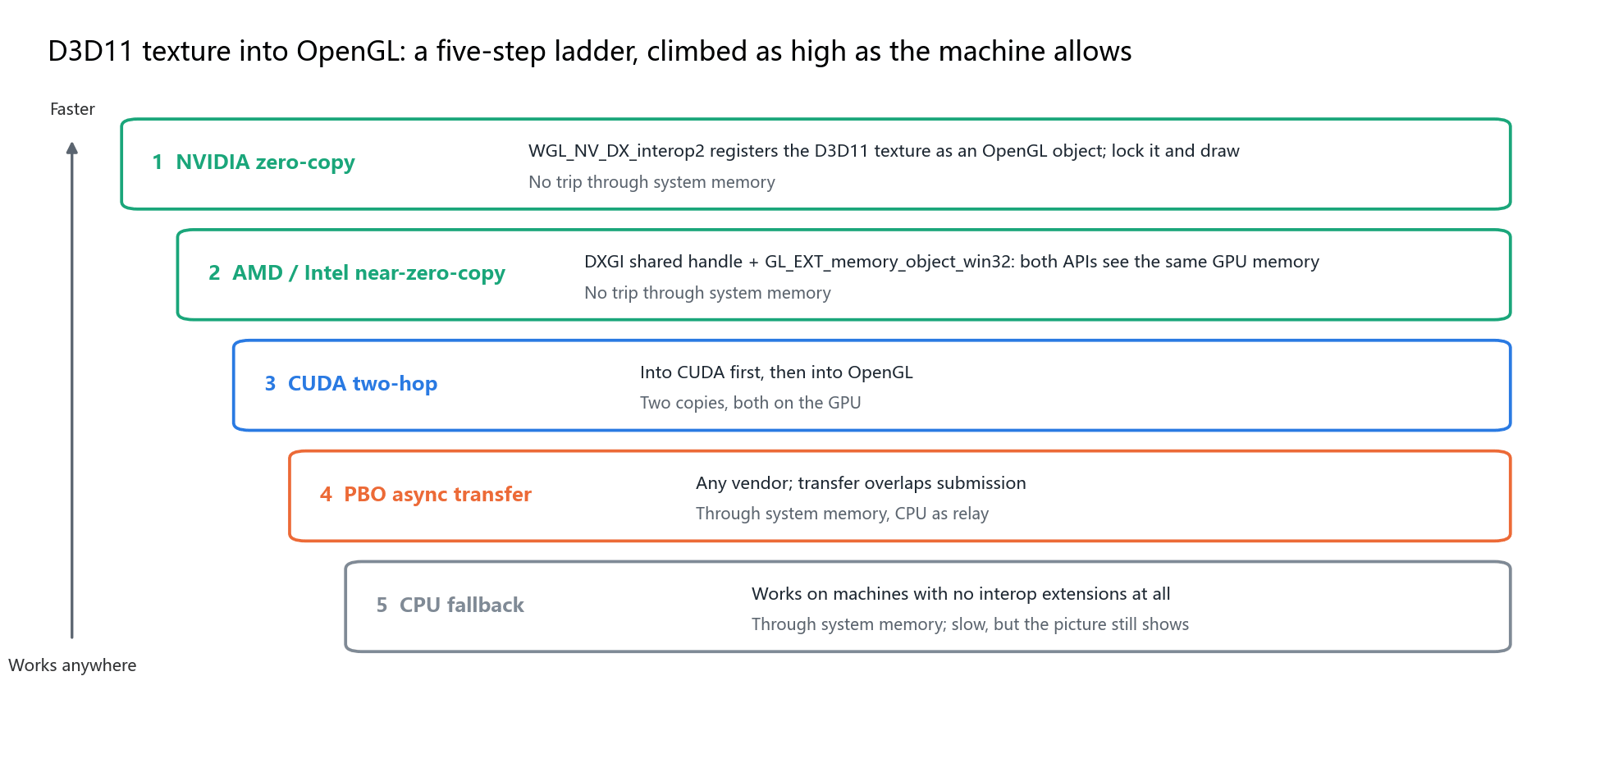
- NVIDIA-Zero-Copy. Die Erweiterung
WGL_NV_DX_interop2registriert eine D3D11-Textur als OpenGL-Objekt; nach dem Sperren liest und schreibt OpenGL sie direkt, ohne Umweg über den Arbeitsspeicher. - Beinahe-Zero-Copy für AMD und Intel. Ein DXGI-Shared-Handle und die Erweiterung
GL_EXT_memory_object_win32lassen beide APIs auf denselben GPU-Speicher blicken. - Umweg über CUDA. Erst nach CUDA, dann nach OpenGL; beide Kopien finden auf der GPU statt.
- Asynchrone Übertragung mit Pixelpuffer-Objekten (PBO). Funktioniert mit jedem Hersteller; Übertragung und Befehlsübergabe überlappen, die CPU leitet nur weiter.
- CPU-Fallback. Auf Rechnern ganz ohne Interop-Erweiterungen kommt das Bild trotzdem an, nur langsam.
Neben der Leiter gibt es eigene Brücken. CUDA und D3D11 registrieren sich gegenseitig. D3D12 und D3D11 teilen Ressourcen über ein DXGI-Shared-Handle mit Fence-Synchronisierung, sodass D3D12 keine direkte Brücke zu jeder anderen API braucht. Vulkan und D3D11 nutzen externen Speicher. Die CUDA-Kernel für die Farbumwandlung sind in die Bibliothek kompiliert, NV12 und P016 werden also auf der GPU zu BGRA, und 10-Bit-Bilder können in 16-Bit-RGBA bleiben, statt am Eingang auf 8 Bit gekürzt zu werden.
Mac: VideoToolbox dekodiert, Metal zeigt an
Unter macOS geht es nicht um die Länge der Plug-in-Liste. Apple hat Kodierung und Dekodierung in die Media Engine seiner Chips eingebaut, und KwaFlux bindet diese Engine an dieselbe Frame-Sprache an:
- Dekodierung läuft über VideoToolbox, das einen
CVPixelBufferliefert, der als CVPixel-Frame verpackt wird. Unterstützt werden H.264, HEVC, VP9 und ProRes. - Kodierung nutzt
h264_videotoolbox,hevc_videotoolboxundprores_videotoolbox, ProRes-Exporte laufen also ebenfalls über VideoToolbox. - Anzeige läuft über Metal.
CAMetalLayerprüft, ob das Display erweiterten Dynamikumfang (EDR) unterstützt: Wenn ja, wird HDR per EDR gezeigt; wenn nein, bildet dieselbe Tone-Mapping-Mathematik wie unter Windows PQ oder HLG auf SDR ab.
Für Player, Effekte und Konvertierung sind eine D3D11-Textur unter Windows und ein CVPixelBuffer auf dem Mac beide einfach „ein Frame“, die Funktionen zerfallen also nicht nach Betriebssystem in zwei Codebasen.
Der Player: Der Ton gibt den Takt vor, HDR wechselt pro Frame
Der Ton ist die Hauptuhr. Ohren reagieren viel empfindlicher auf Jitter als Augen, deshalb folgt das Bild dem Ton und nicht umgekehrt. Zwischen den Audio-Callbacks wird die Uhr linear an der Systemzeit interpoliert und mit einem exponentiellen gleitenden Durchschnitt geglättet, und die Schwellen richten sich nach dem Frame-Abstand statt nach einer festen Zahl von Millisekunden. Jeder Frame bekommt eine von drei Entscheidungen: warten, zeichnen oder verwerfen. Verworfen wird ein Frame, der zu spät kommt, nicht Ihre Position im Video.
Ein Sprung ist eine Transaktion. Die Dekodierung wird unterbrochen, veraltete Frames werden verworfen, eine Generationsnummer hält alte Frames fern, und die Uhr wird zurückgesetzt; die Audio-Uhr läuft erst wieder an, wenn das Bild an der neuen Position tatsächlich gezeichnet ist. Sie sehen die Stelle, an die Sie gesprungen sind, nicht die letzte Sekunde, die noch in der Warteschlange lag.
HDR wird nicht für eine ganze Datei auf einmal eingeschaltet. Jeder Frame wird nach seiner eigenen Übertragungscharakteristik beurteilt: Nur PQ und HLG fordern eine HDR-Swapchain an, und folgt ein SDR-Abschnitt, schaltet die Swapchain zurück, sodass normales Material nicht als PQ-Signal gezeigt wird und dadurch nicht grau wirkt. HLG wird in einem Shader nach PQ umgerechnet, bevor es ans Display geht.
| Anzeige-Backend | Einsatz | Umgang mit HDR |
|---|---|---|
| D3D11 | Hauptweg unter Windows | 10-Bit-Swapchain mit PQ- und BT.2020-Durchleitung; auf Displays ohne HDR im Shader auf SDR abgebildet |
| Vulkan | Moderner Grafikweg | HDR10-Surface, 10 Bit oder halbe Genauigkeit |
| Metal | macOS | Erweiterter Dynamikumfang über CAMetalLayer, gleiches Tone Mapping |
| OpenGL | Gemeinsamer Weg auf allen Plattformen | Keine HDR-Durchleitung; bildet HDR auf SDR ab |
HDR auf einem normalen Display. Alle vier Backends teilen sich einen Tone Mapper: PQ oder HLG wird in reale Leuchtdichte in Nits umgerechnet, in IPT überführt, durch Ton- und Farbumfangstabellen geschickt und als BT.709 und sRGB ausgegeben. Die Tontabelle folgt der Bildspitze, gemessen an einem winzigen Offscreen-Ziel und zurückgelesen, ohne die GPU anzuhalten, mit Glättung bei Szenenwechseln. Fehlt einer Datei die Mastering-Leuchtdichte, startet der Mapper bei 1.000 Nits statt bei einem schmeichelnden Fixwert. Untertitel, die aus sRGB in eine HDR-Swapchain gehen, werden auf PQ-Referenzweiß angehoben, damit weißer Text vor hellen Szenen nicht grau wirkt.
Die Vergleichswiedergabe teilt Original und bearbeitetes Bild in zwei Pipelines, und jede Seite der Trennlinie führt ihren eigenen Helligkeitsverlauf, sodass eine Nachtszene links das Tageslicht rechts nicht abdunkelt. Während der Wiedergabe treten Hintergrundaufgaben ihren GPU-Anteil ab und holen ihn nach dem Stoppen langsam zurück: Echtzeitwiedergabe geht vor, Exporte stellen sich an.
libplacebo: Skalierung, Tone Mapping und Debanding
libplacebo ist die aus dem Player mpv herausgelöste GPU-Bildqualitätsbibliothek. KwaFlux bindet sie als Effektknoten ein und wählt das Backend nach dem eingehenden Frame: OpenGL-, software-dekodierte, CUDA- und CVPixel-Frames laufen über OpenGL; D3D11-NV12 geht direkt ins D3D11-Backend und spart eine Farbkonvertierung hin und zurück; Vulkan-Frames bleiben in Vulkan.
- Hochskaliert wird mit EWA Lanczos, herunterskaliert mit Lanczos, und wenn es schnell gehen soll, bilinear.
- Für HDR zu SDR stehen BT.2390, Reinhard, Spline und Hable zur Wahl, wobei die Spitze am Bild gemessen werden kann.
- Debanding, Dithering und Anti-Ringing verhindern, dass Verläufe am Himmel in Streifen zerfallen.
- Das Deinterlacing nutzt ein Zeitfenster aus vorherigem, aktuellem und nächstem Frame, statt jeden Frame einzeln zu raten.
- Es gibt die Voreinstellungen Schnell und Hohe Qualität: Schnell für Vorschauen und Skalierung vor dem Kodieren, Hohe Qualität für den finalen Export.
Automatische Korrekturen (Drehung, Pixel-Seitenverhältnis, Zeilensprung, Chroma-Position) und die Skalierung vor dem Kodieren gehen zuerst an libplacebo. Ändert ein Upscaling die Auflösung, steht der Skalierungsknoten trotzdem vor dem Encoder, der also die Zielgröße erhält. Startet libplacebo nicht, übernehmen die FFmpeg-Filter scale, zscale und yadif, sodass ein fehlendes Modul den Auftrag nicht stoppt.
Der ideale Weg eines Pixels durch einen Export
Zusammengesetzt läuft ein Export unter Windows so ab:
- Die Datei wird in Pakete demultiplext, und der Selektor wählt den passenden Hardware-Dekoder für diesen Rechner.
- Frames entstehen als CUDA-Zeiger oder D3D11-Texturen, nicht als Block im Arbeitsspeicher.
- Drehung, Korrektur des Seitenverhältnisses, Deinterlacing oder Tone Mapping für eine SDR-Fassung erledigt libplacebo auf der GPU.
- KI-Modelle (Upscaling, Qualitätsreparatur, SDR zu HDR und weitere) bearbeiten jeden Frame auf der GPU; der Frame-Typ darf sich unterwegs ändern, ohne dass der Auftrag wissen muss, welche Brücke er genommen hat.
- Muss die Auflösung einem Ziel entsprechen, folgt noch eine schnelle Skalierung.
- Jeder Encoder nimmt Frames auf seine Art entgegen: NVENC nimmt CUDA, oneVPL und AMF nehmen D3D11.
- Die Pakete gehen in den Muxer, die Zeitstempel werden geordnet, die Datei wird geschrieben.
In einem Satz: Die Hardware-Dekodierung hinterlässt eine Textur, Interop gibt einer anderen API den Blick darauf, die Bildbearbeitung bleibt auf der GPU, und der Hardware-Encoder liest seine Frames aus demselben GPU-Speicher. Arbeitsspeicher kommt nur ins Spiel, wenn der Rechner keine höhere Brücke hat oder ein Schritt die Pixel tatsächlich auf der CPU lesen muss. Das ist ein Ausweichweg, nicht der Kern des Designs.
Auf dem Mac ist es derselbe Satz in einem anderen Dialekt: VideoToolbox dekodiert in der Media Engine, Frames kommen als CVPixelBuffer in die Pipeline, Metal bringt HDR per EDR auf den Bildschirm, und ProRes- und HEVC-Exporte gehen zurück an VideoToolbox.
Segmentparallele Exporte teilen die Zeitleiste in Abschnitte, und jeder Abschnitt läuft durch dieselbe Pipeline, nicht durch eine Abkürzung, die für Tempo die Farbverarbeitung auslässt.
Was Sie in KwaFlux einstellen können
Das meiste läuft automatisch. Diese Einstellungen ändern das Verhalten:
- Hardwaredekodierung (Einstellungen › Leistung): Auto (Standard), Ein oder Aus. Wird eine Datei fehlerhaft oder mit Störungen dekodiert, stellen Sie auf Aus, um mit Software-Dekodierung einzugrenzen. Die Änderung greift nach einem Neustart der App.
- KI-Prozessor (Einstellungen › Leistung): ob die KI-Verarbeitung die GPU nutzt oder die App entscheidet. Die GPU ist meist schneller; die Wahl gilt ab dem nächsten Export, der nächsten Vorschau oder Maskenerzeugung.
- Ressourcennutzung beim KI-Export: Geringe Last (ein Stream, auf Rechnern mit mehreren GPUs nur eine), Ausgewogen (Standard), Volle Leistung oder Benutzerdefiniert (welche GPUs genutzt werden und wie viele Streams jede ausführt). Ein Herabsetzen wirkt sofort auf einen laufenden Export, und fertige Abschnitte gehen nicht verloren.
Typische Probleme
| Problem | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Eine Datei zeigt in der Vorschau Störungen oder ein grünes Bild | Der Hardware-Dekoder dieser GPU unterstützt diese Codec-Variante nicht vollständig | Hardwaredekodierung auf Aus stellen und neu starten, um per Software zu dekodieren |
| SDR-Abschnitte wirken bei der HDR-Wiedergabe grau | Der Player wechselt den Anzeigemodus nicht pro Frame, oder die Tags der Datei sind falsch | Die Übertragungscharakteristik jedes Abschnitts mit ffprobe prüfen |
| Hohe CPU-Last und eine untätige GPU beim Export | Der Weg ist auf eine Stufe über den Arbeitsspeicher gefallen, oder ein Filter läuft nur auf der CPU | GPU-Treiber aktualisieren; nach Einstellungen suchen, die nur auf der CPU verarbeitet werden |
| NVIDIA meldet bei parallelen Exporten zu viele Sitzungen | Mehr Kodiersitzungen, als der Treiber erlaubt | Weniger Aufträge parallel starten oder die Ressourcennutzung auf Geringe Last oder Ausgewogen stellen |
| Langsame Exporte auf einem Laptop mit zwei GPUs | Dekodierung und Anzeige laufen auf verschiedenen GPUs und erzeugen Kopien zwischen ihnen | KwaFlux in den Grafikeinstellungen des Systems der dedizierten GPU zuweisen |
Was diese Architektur nicht kann
- Zero-Copy auf jedem Pfad. Stufe 4 und 5 der Leiter laufen über den Arbeitsspeicher, und ältere GPUs oder Treiber ohne Interop-Erweiterungen landen dort.
- Dolby Vision wiedergeben. Zuverlässig unterstützt werden statisches HDR10 und HLG.
- Auf dem Mac Interop wie unter Windows. Die Stärken des Mac sind VideoToolbox, ProRes, CVPixel-Frames und Metal-EDR, nicht ebenso viele Interop-Brücken wie unter Windows.
- Einen Beschleunigungsfaktor versprechen. Wie viel schneller weniger Kopien Ihren Export machen, hängt von GPU, Treiber, Auflösung und Bearbeitungsschritten ab; prüfen und messen Sie mit eigenem Material.
Fazit
Eine durchgehende GPU-Pipeline ist kein Slogan, sondern eine Routing-Tabelle, die ausweichen kann. Schnelle Rechner halten die Pixel durchgehend auf der GPU, langsamere weichen Stufe für Stufe aus und bringen den Auftrag trotzdem zu Ende. Werfen Sie beim nächsten Export einen Blick auf GPU- und CPU-Last, dann wissen Sie, welchen Weg Ihre Pixel genommen haben.
Auf eigenem Material testen
KwaFlux führt den Formatkonverter und alle KI-Werkzeuge auf Ihrer eigenen GPU aus und hält Dekodierung, Bearbeitung und Kodierung so weit wie möglich auf der Grafikkarte. Die KI-Verarbeitung läuft auf Ihrer eigenen GPU, und Ihre Mediendateien werden für die Verarbeitung nicht hochgeladen. KwaFlux läuft unter Windows 10 (64-Bit, Version 1809 oder neuer), Windows 11 und macOS 12 oder neuer auf Apple Silicon. Vorschauen brauchen kein Konto: Rendern Sie für jeden Clip eine Vorschau von 1, 3 oder 5 Sekunden. Anmeldung und ein bezahlter Plan sind nur für Export, Konvertierung, Dateireparatur und Datei-Download aus einem Link nötig.
Auf eigenem Material testen
KwaFlux laden und Effekte vor dem Kauf kostenlos auf eigenem Material ansehen — ohne Konto, verarbeitet auf Ihrer GPU, ohne Upload Ihrer Medien. Videovorschauen laufen 1, 3 oder 5 Sekunden, Vorschauen der Stabilisierung 5, 15 oder 30 Sekunden.
Häufige Fragen
Was bedeutet Zero-Copy?
Zero-Copy bedeutet, dass zwei Komponenten denselben Speicher nutzen und den Zugriff übergeben, statt die Pixel zu kopieren. Die NVIDIA-Erweiterung WGL_NV_DX_interop2 etwa registriert eine D3D11-Textur als OpenGL-Objekt, und nach dem Sperren liest und schreibt OpenGL sie ohne Umweg über den Arbeitsspeicher.
Macht eine zweite GPU Exporte schneller?
Manchmal. Eine zweite Karte hilft, wenn die Software die Zeitleiste in Abschnitte teilt und sie auf beiden GPUs parallel bearbeitet. Einen einzelnen Stream beschleunigt sie nicht, und Dekodieren auf einer Karte bei Anzeige auf der anderen erzeugt Kopien zwischen den GPUs, die Zeit kosten statt sparen.
Wie viele Hardware-Kodierungen kann eine Consumer-Karte von NVIDIA gleichzeitig ausführen?
Bis zu 12, laut der aktuellen Support-Matrix von NVIDIA für GeForce-Karten mit Encoder; die meisten Profi- und Rechenzentrumskarten sind nicht begrenzt. Eine neue Kodierung über dem Limit schlägt fehl, behalten Sie das beim parallelen Export mehrerer Dateien im Blick.
Ist Hardware-Dekodierung besser als Software-Dekodierung?
Nicht immer. Bei knappem GPU-Speicher, sehr neuen Codecs oder ungewöhnlichen Dateiparametern kann Hardware-Dekodierung scheitern oder das Bild stören, und mit einer starken CPU ist Software-Dekodierung nicht langsam. Sinnvoll ist ein Design, das beides behält, je nach Fall wählt und auf Software zurückfällt, wenn die Hardware nicht dekodieren kann.
Warum ist mein Export trotz Hardwarebeschleunigung langsam?
Meist, weil nicht die Dekodierung der Engpass ist. KI-Inferenz, Filter und Kodierung brauchen ebenfalls Zeit, und jeder Schritt, der in den Arbeitsspeicher zurückfällt, lässt die Pipeline auf Kopien warten. Prüfen Sie, welcher Teil wartet: Geringe GPU-Last bei hoher CPU-Last bedeutet meist, dass etwas auf die CPU ausgewichen ist. Siehe lokale und Cloud-basierte KI-Videoverarbeitung.
Quellen
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (abgerufen am 2026-10-22)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (abgerufen am 2026-10-22)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (abgerufen am 2026-10-22)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (abgerufen am 2026-10-22)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (abgerufen am 2026-10-22)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (abgerufen am 2026-10-22)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (abgerufen am 2026-10-22)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (abgerufen am 2026-10-22)
KwMehr zu Hinter KwaFlux
Weiterlesen

KwaFlux: Alles, was Sie wissen müssen (Funktionen, Plattformen, Preise, Updates)
Was KwaFlux kann, auf welchen Systemen es läuft, was kostenlos ist und was nicht, wie Lizenzen funktionieren und was sich in jeder Version geändert hat.
KwaFlux auf dem Mac: unterstützte Macs, Installation und Tipps für mehr Tempo
Welche Macs KwaFlux unterstützt, wie die Installation klappt, was Beschleunigungskomponente und Standardmodus bedeuten und wie KI-Video flott läuft.
KI-Videoverbesserung beschleunigen: Workflow, Einstellungen und Hardware
Warum KI-Videoverbesserung langsam ist und wie es schneller geht: weniger verarbeiten, Ausgabegröße wählen, Schritte ordnen, GPU und Optionen nutzen.