Une image n’a pas besoin de rentrer à la maison : comment KwaFlux garde la vidéo sur le GPU du décodage à l’encodage
Une image 4K 10 bits pèse environ 24,9 Mo, et chaque trajet entre RAM et GPU coûte du temps. Voici comment KwaFlux garde les pixels sur le GPU.
L’essentiel
Un pipeline vidéo tout-GPU garde les pixels dans la mémoire du GPU du décodage à l’encodage, en passant par le traitement d’image et l’inférence IA, au lieu de les copier entre la mémoire système et la carte graphique. Moins de copies, ce sont des exports plus rapides, des aperçus plus fluides et un CPU au repos.
Dans ce guide, vous verrez comment le moteur multimédia de KwaFlux y parvient : un adaptateur d’images qui fait parler la même langue à neuf types d’image, la façon dont les décodeurs et encodeurs matériels de trois fabricants de GPU sont notés et choisis, l’échelle d’interopérabilité à cinq barreaux entre D3D11 et OpenGL, VideoToolbox et Metal sur Mac, et la manière dont le lecteur affiche le HDR. Nous terminons par le parcours complet d’un pixel au cours d’un export et par les réglages que vous pouvez modifier dans KwaFlux.
- Une image 4K en 10 bits et 4:2:0 pèse environ 24,9 Mo. À 60 i/s, chaque trajet entre la mémoire système et la mémoire du GPU déplace environ 1,5 Go par seconde. Plus il y a de trajets, plus l’export ralentit et plus l’aperçu saccade.
- Le moteur multimédia de KwaFlux donne à chaque image une carte d’identité : pointeur CUDA, texture D3D11, texture Metal ou mémoire système. Les couches supérieures ne voient qu’« une image », et quand une autre API en a besoin, le moteur choisit la passerelle la moins coûteuse.
- Sous Windows, le décodage et l’encodage matériels pour NVIDIA, Intel, AMD ainsi que D3D11 et D3D12 du système sont livrés sous forme de plug-ins. Ils sont notés selon le GPU, la mémoire et la résolution ; si l’un échoue, le suivant prend le relais, et le décodage logiciel récupère le reste.
- Une texture D3D11 rejoint OpenGL par une échelle à cinq barreaux : sans copie chez NVIDIA, presque sans copie chez AMD et Intel, un détour par CUDA, un transfert asynchrone et un repli sur le CPU. Les machines rapides prennent les barreaux du haut, les plus anciennes ceux du bas, et l’image continue de s’afficher dans les deux cas.
- Le sans-copie ne vaut pas pour tous les chemins : les deux barreaux du bas passent par la mémoire système. Un pipeline tout-GPU, c’est rester sur le GPU autant que possible et redescendre d’un cran quand ce n’est pas possible, plutôt qu’échouer.
Pourquoi renvoyer un pixel à la maison coûte cher
Un pixel rentre à la maison quand une image est copiée de la mémoire du GPU vers la mémoire système, traitée, puis renvoyée. Les décodeurs matériels écrivent l’image dans la mémoire du GPU, les modèles d’IA et les filtres d’image tournent sur le GPU, et les encodeurs matériels y lisent aussi. Il suffit qu’une seule étape intermédiaire n’accepte que des pixels en mémoire système pour que l’image fasse l’aller-retour par le PCIe.
Voici la taille d’une image (en 4:2:0, la chrominance ajoute la moitié de la taille de la luma) :
| Format | Une image | Par trajet à 30 i/s | Par trajet à 60 i/s |
|---|---|---|---|
| 1080p, NV12 8 bits | 3,1 Mo | 93 Mo/s | 187 Mo/s |
| 4K, NV12 8 bits | 12,4 Mo | 373 Mo/s | 746 Mo/s |
| 4K, P010 10 bits | 24,9 Mo | 746 Mo/s | 1,49 Go/s |
| 4K, RGBA en demi-précision (courant pour l’IA et le HDR) | 66,4 Mo | 1,99 Go/s | 3,98 Go/s |
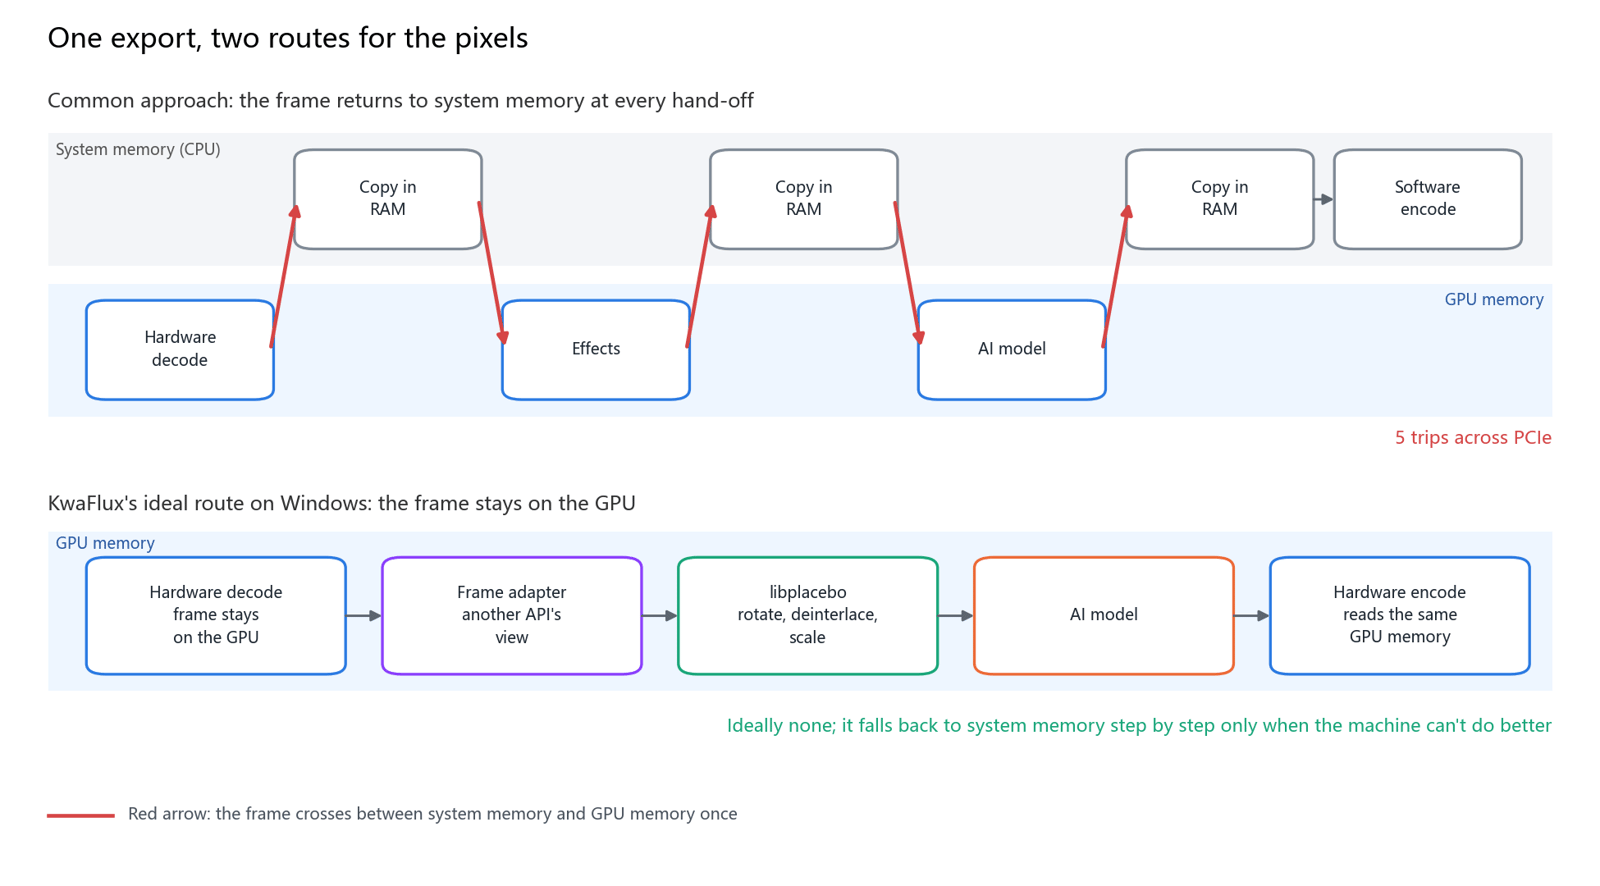
Le PCIe 4.0 x16 offre en théorie environ 31,5 Go/s dans chaque sens. Cela semble large, mais c’est un pic ; chaque copie attend aussi que le GPU termine son travail en cours et que le pilote se synchronise, et le CPU doit tout orchestrer. La moitié supérieure de la figure montre une approche courante : décodage, effets, IA et encodage veulent chacun leur mémoire, et une même image traverse cinq fois le PCIe pendant un seul export. En 4K 10 bits à 60 i/s, cela représente environ 7,5 Go par seconde rien qu’en copies.
L’adaptateur d’images : neuf types d’image, une seule interface
L’adaptateur d’images est une couche du moteur multimédia de KwaFlux qui fait qu’une image se présente de la même façon au lecteur, aux effets et aux encodeurs, quelle que soit la mémoire où elle se trouve réellement. Le logiciel multimédia est plein de dialectes : FFmpeg parle AVFrame, NVIDIA parle pointeurs de périphérique CUDA, les décodeurs matériels d’Intel et d’AMD livrent des textures D3D11, Vulkan parle VkImage et Apple CVPixelBuffer. Chacun a sa propre durée de vie, son alignement et sa disposition des couleurs.
| Type d’image | Où elle se trouve | Qui la produit |
|---|---|---|
| Image FFmpeg | Un AVFrame en mémoire système | Le décodage logiciel et tous les chemins de repli |
| Image D3D11 | Une ID3D11Texture2D | Le décodage matériel D3D11VA, Intel et AMD sous Windows |
| Image D3D12 | Une ressource D3D12 | Le décodage vidéo D3D12 |
| Image CUDA | Un pointeur de périphérique CUDA | Le décodage NVDEC de NVIDIA ; entrée native de NVENC |
| Image OpenGL | Une texture ou un framebuffer object | Filtres, aperçus et rendu multiplateforme |
| Image Vulkan | Une VkImage | Décodage et rendu vidéo Vulkan |
| Image Metal | Une MTLTexture | Affichage et HDR sous macOS |
| Image CVPixel | Un CVPixelBuffer | Décodage VideoToolbox sous macOS |
| Image OpenCV | Une cv::Mat | Algorithmes qui lisent directement les pixels |
Les couches supérieures reçoivent une seule interface d’image et, quand elles ont besoin d’une autre forme, la demandent ; c’est le moteur qui choisit la passerelle la moins coûteuse sur la machine. Quelques choix de conception évitent que l’ensemble se disloque au troisième fabricant de GPU :
- Les types sont fixés à la compilation. Une requête entre interfaces est une conversion statique, pas de l’information de type à l’exécution, donc rien ne se heurte aux frontières des DLL.
- Seules les images qui possèdent des ressources GPU portent des opérations GPU. Cloner, convertir et exporter vers une matrice appartiennent aux types d’image concrets, pas à l’interface commune.
- La propriété est explicite. Qui alloue libère, et les handles partagés ne sont pas libérés deux fois. Quand un périphérique GPU est reconstruit, les ressources d’interopérabilité qui en dépendent sont invalidées et reconstruites avec lui, si bien qu’aucune texture de l’ancien périphérique ne reste accrochée au nouveau.
Windows : décodage et encodage matériels chez trois fabricants de GPU
Sous Windows, KwaFlux installe huit plug-ins de décodage vidéo et six plug-ins d’encodage vidéo, chacun dans sa propre DLL. Après le démultiplexage, le sélecteur suit la configuration ; en mode automatique, il note chaque candidat, essaie d’abord celui qui a la note la plus haute, puis passe au suivant si l’initialisation échoue. Le décodage logiciel récupère tout ce qui reste.
| Plug-in de décodage | Image produite | Codecs |
|---|---|---|
| NVDEC de NVIDIA | Image CUDA, NV12 8 bits ou P016 10 bits | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D11VA (décodage matériel du système) | Texture NV12 D3D11 | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D12VA | Ressource D3D12 | H.264, HEVC, VP9, AV1 |
| Intel oneVPL (GPU Intel actuels) | Texture D3D11 | H.264, HEVC, VP9, AV1, MJPEG |
| Intel Media SDK (puces graphiques intégrées des Core de 5e à 10e génération) | Texture D3D11 | H.264, HEVC, MPEG-2, MJPEG |
| AMF d’AMD | Texture D3D11, encapsulée directement dans une surface AMF | H.264, HEVC, VP9, AV1, MPEG-2 |
| Vulkan Video | Image Vulkan | H.264, HEVC |
| Décodage logiciel FFmpeg | Image en mémoire système | Tout ce que lit FFmpeg, y compris VP8 et VP9 avec alpha |
Le tableau indique ce que gère chaque plug-in ; la capacité de votre GPU à décoder un codec en matériel dépend de sa génération. Selon la matrice de prise en charge de NVIDIA, par exemple, les cartes grand public ne décodent l’AV1 en matériel qu’à partir de la série RTX 30.
Ce que prend en compte la note. Un mauvais fabricant est éliminé d’emblée : sur un GPU qui n’est pas de NVIDIA, NVDEC n’obtient aucun point. Les décodeurs matériels perdent des points quand la mémoire du GPU est limitée, et avec un CPU puissant le décodage logiciel peut l’emporter, pour ne pas alourdir la machine juste pour pouvoir dire « matériel ». La 4K donne des points au matériel, car c’est précisément là que les unités à fonction fixe doivent travailler. Si l’affichage passe par D3D11, D3D11VA gagne des points, et décoder sur un autre GPU que celui qui pilote l’écran en fait perdre, car les copies entre GPU sont pénalisées.
L’encodage : l’encodeur prend ce que le décodeur a produit.
| Plug-in d’encodage | Entrée privilégiée | Codecs de sortie |
|---|---|---|
| NVENC de NVIDIA | Images CUDA ; accepte aussi les images D3D11, D3D12, Vulkan, OpenGL et en mémoire système | H.264, HEVC, AV1 |
| Intel oneVPL | Textures D3D11 sur le même GPU, copiées sur le GPU | H.264, HEVC, AV1, VP9, MJPEG |
| AMF d’AMD | Textures D3D11 encapsulées directement dans des surfaces AMF, paquets récupérés en asynchrone | H.264, HEVC, AV1 |
| Intel Media SDK | Textures D3D11 ou images en mémoire système | H.264, HEVC, MPEG-2, MJPEG |
| Vulkan Video | Images Vulkan | H.264, HEVC |
| Encodage logiciel FFmpeg | Images en mémoire système | Ce que prennent en charge les encodeurs logiciels |
NVENC montre le plus clairement l’intérêt de l’adaptateur d’images : il n’exige pas que chaque image devienne d’abord CUDA. Une image CUDA fait une copie 2D sur le périphérique, une image D3D11 passe par l’interopérabilité, D3D12 passe par D3D11 pour atteindre CUDA, Vulkan utilise la mémoire externe et OpenGL une passerelle par tampon de pixels. Seule une image qui se trouvait déjà en mémoire système est transférée une fois vers le GPU. En HEVC et en AV1, les données de mastering HDR et de luminosité du contenu vont dans la configuration de l’encodeur ; H.264 n’a pas de champ natif pour cela, le plug-in les écrit donc lui-même dans les SEI.
À noter : selon la matrice de prise en charge de NVIDIA, les cartes GeForce dotées d’un encodeur acceptent au plus 12 sessions d’encodage simultanées. Quand elles sont épuisées, le plug-in NVENC de KwaFlux se retire et confie le travail à l’encodeur suivant, au lieu d’échouer en plein export.
Les plug-ins portent un contrôle de version et ne sont pas chargés en cas de différence, et la détection des capacités peut noter un plug-in sans le charger. Une nouvelle génération de GPU, c’est un plug-in de plus ; le lecteur et le convertisseur au-dessus ne changent pas.
L’échelle à cinq barreaux : faire passer une texture D3D11 dans OpenGL
Le décodeur et l’API d’affichage souvent, ne correspondent pas : NVIDIA décode en CUDA ou en D3D11 alors que l’image doit aller dans OpenGL, Intel décode en D3D11 alors qu’un filtre travaille sur une texture OpenGL. Le cœur graphique de KwaFlux construit la passerelle, et entre D3D11 et OpenGL c’est une échelle à cinq barreaux, gravie aussi haut que la machine le permet :
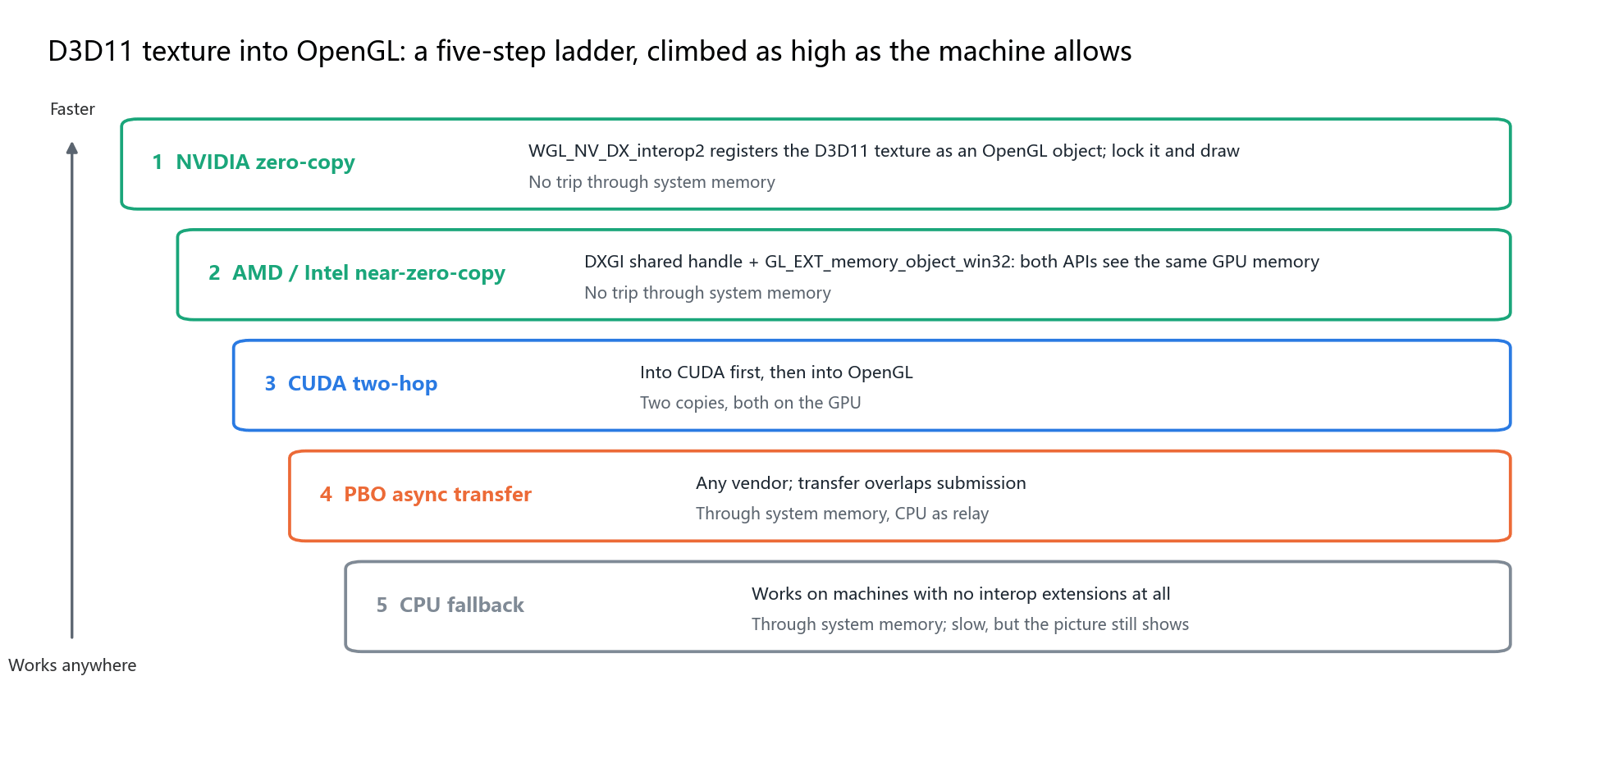
- Sans copie chez NVIDIA. L’extension
WGL_NV_DX_interop2enregistre une texture D3D11 comme objet OpenGL ; une fois verrouillée, OpenGL la lit et l’écrit directement, sans passer par la mémoire système. - Presque sans copie chez AMD et Intel. Un handle partagé DXGI et l’extension
GL_EXT_memory_object_win32permettent aux deux API de voir la même mémoire GPU. - Détour par CUDA. D’abord vers CUDA, puis vers OpenGL ; les deux copies ont lieu sur le GPU.
- Transfert asynchrone par pixel buffer objects (PBO). Fonctionne avec tous les fabricants ; le transfert chevauche la soumission des commandes, et le CPU ne fait que relayer.
- Repli sur le CPU. Sur une machine sans aucune extension d’interopérabilité, l’image arrive malgré tout, simplement plus lentement.
À côté de l’échelle, il existe des passerelles dédiées. CUDA et D3D11 s’enregistrent mutuellement. D3D12 et D3D11 partagent leurs ressources par un handle partagé DXGI avec synchronisation par fence, si bien que D3D12 n’a pas besoin d’une passerelle directe vers chaque autre API. Vulkan et D3D11 utilisent la mémoire externe. Les noyaux CUDA de conversion des couleurs sont compilés dans la bibliothèque : NV12 et P016 deviennent du BGRA sur le GPU, et les images 10 bits peuvent rester en RGBA 16 bits au lieu d’être réduites à 8 bits dès l’entrée.
Mac : VideoToolbox décode, Metal affiche
Sous macOS, on ne se mesure pas à la longueur de la liste de plug-ins. Apple a intégré l’encodage et le décodage au moteur multimédia de ses puces, et KwaFlux branche ce moteur sur le même langage d’images :
- Le décodage passe par VideoToolbox, qui livre un
CVPixelBufferencapsulé en image CVPixel. Il couvre H.264, HEVC, VP9 et ProRes. - L’encodage utilise
h264_videotoolbox,hevc_videotoolboxetprores_videotoolbox; les exports ProRes passent donc eux aussi par VideoToolbox. - L’affichage passe par Metal.
CAMetalLayervérifie si l’écran prend en charge la plage dynamique étendue (EDR) : si oui, le HDR s’affiche via l’EDR ; sinon, les mêmes calculs de tone mapping que sous Windows ramènent le PQ ou le HLG en SDR.
Pour le lecteur, les effets et la conversion, une texture D3D11 sous Windows et un CVPixelBuffer sur Mac sont tous deux simplement « une image » : les fonctions ne se dédoublent pas en deux bases de code selon le système.
Le lecteur : l’audio donne l’heure, le HDR change à chaque image
L’audio sert d’horloge maîtresse. L’oreille tolère bien moins les à-coups que l’œil, donc l’image suit le son et non l’inverse. Entre deux rappels audio, l’horloge est interpolée linéairement sur le temps système et lissée par une moyenne mobile exponentielle, et les seuils sont proportionnels à l’intervalle entre images plutôt qu’à un nombre fixe de millisecondes. Chaque image reçoit l’une de trois décisions : attendre, dessiner ou abandonner. Ce qui est abandonné, c’est une image arrivée trop tard, pas votre position dans la vidéo.
Un déplacement dans la vidéo est une transaction. Le décodage est interrompu, les images périmées sont vidées, un numéro de génération tient les anciennes images à l’écart et l’horloge est réinitialisée ; l’horloge audio ne repart qu’une fois l’image à la nouvelle position réellement dessinée. Vous voyez l’endroit où vous êtes allé, pas la dernière seconde restée dans la file d’attente.
Le HDR ne s’active pas pour tout un fichier d’un coup. Chaque image est jugée selon sa propre caractéristique de transfert : seuls le PQ et le HLG demandent une swap chain HDR, et si la section suivante est en SDR, la swap chain repasse en SDR, pour qu’une image ordinaire ne soit pas traitée comme un signal PQ et ne devienne pas grise. Le HLG est converti en PQ dans un shader avant d’être envoyé à l’écran.
| Backend d’affichage | Usage | Traitement du HDR |
|---|---|---|
| D3D11 | Chemin principal sous Windows | Swap chain 10 bits avec PQ et BT.2020 transmis tels quels ; ramené en SDR dans un shader sur les écrans sans HDR |
| Vulkan | Chemin graphique moderne | Surface HDR10, 10 bits ou demi-précision |
| Metal | macOS | Plage dynamique étendue via CAMetalLayer, même tone mapping |
| OpenGL | Chemin commun à toutes les plateformes | Pas de transmission HDR ; ramène le HDR en SDR |
Le HDR sur un écran ordinaire. Les quatre backends partagent un seul tone mapper : le PQ ou le HLG est converti en luminance réelle en nits, passé en IPT, traité par des tables de tons et de gamut, puis restitué en BT.709 et sRGB. La table de tons suit le pic de l’image, mesuré sur une minuscule cible hors écran et relu sans bloquer le GPU, avec un lissage aux changements de scène. Quand un fichier n’indique pas de luminance de mastering, le mapper part de 1 000 nits plutôt que d’une constante flatteuse. Les sous-titres qui passent du sRGB à une swap chain HDR sont remontés au blanc de référence PQ, pour que le texte blanc ne paraisse pas gris sur les scènes lumineuses.
La lecture comparative sépare l’original et l’image traitée en deux pipelines, et chaque côté du séparateur garde son propre historique de luminosité : une scène de nuit à gauche n’assombrit donc pas la lumière du jour à droite. Pendant la lecture, les tâches de fond cèdent leur part du GPU et la reprennent progressivement à l’arrêt : la lecture en temps réel passe d’abord, les exports attendent leur tour.
libplacebo : mise à l’échelle, tone mapping et débanding
libplacebo est la bibliothèque de qualité d’image GPU issue du lecteur mpv. KwaFlux l’intègre comme nœud d’effet et choisit son backend selon l’image qui arrive : les images OpenGL, décodées par logiciel, CUDA et CVPixel passent par OpenGL ; le NV12 D3D11 va directement au backend D3D11, ce qui épargne une conversion de couleur aller-retour ; les images Vulkan restent dans Vulkan.
- L’agrandissement utilise EWA Lanczos et la réduction Lanczos, avec le bilinéaire quand la vitesse compte.
- Pour passer du HDR au SDR, on peut choisir les courbes BT.2390, Reinhard, Spline ou Hable, avec un pic mesuré sur l’image.
- Le débanding, le tramage et l’anti-ringing évitent que les dégradés du ciel ne se transforment en bandes.
- Le désentrelacement utilise une fenêtre temporelle composée de l’image précédente, de l’image courante et de la suivante, au lieu de deviner chaque image isolément.
- Les préréglages sont Rapide et Haute qualité : Rapide pour les aperçus et la mise à l’échelle avant encodage, Haute qualité pour le rendu final.
Les corrections automatiques (rotation, rapport d’aspect des pixels, entrelacement, position de la chrominance) et la mise à l’échelle avant encodage sont confiées d’abord à libplacebo. Quand un upscaling change la résolution, le nœud de mise à l’échelle reste placé avant l’encodeur, qui reçoit donc la taille cible. Si libplacebo ne démarre pas, les filtres FFmpeg scale, zscale et yadif prennent le relais, et un module manquant n’arrête pas le travail.
Le parcours idéal d’un pixel au cours d’un export
Mis bout à bout, un export sous Windows se déroule ainsi :
- Le fichier est démultiplexé en paquets, et le sélecteur choisit le décodeur matériel adapté à la machine.
- Les images naissent sous forme de pointeurs CUDA ou de textures D3D11, pas de blocs alloués en mémoire système.
- La rotation, la correction du rapport d’aspect, le désentrelacement ou le tone mapping pour une version SDR sont faits par libplacebo sur le GPU.
- Les modèles d’IA (upscaling, Réparation de qualité, SDR vers HDR et d’autres) traitent chaque image sur le GPU ; le type de l’image peut changer en route sans que le travail ait à savoir quelle passerelle elle a empruntée.
- Si la résolution doit correspondre à une cible, une mise à l’échelle rapide supplémentaire a lieu.
- Chaque encodeur reçoit les images à sa manière : NVENC prend du CUDA, oneVPL et AMF prennent du D3D11.
- Les paquets entrent dans le multiplexeur, les horodatages sont ordonnés et le fichier est écrit.
En une phrase : le décodage matériel laisse une texture, l’interopérabilité en donne une vue à une autre API, le traitement d’image reste sur le GPU, et l’encodeur matériel lit ses images dans la même mémoire GPU. La mémoire système n’entre en jeu que si la machine n’a pas de passerelle plus haute, ou si une étape a réellement besoin de lire les pixels sur le CPU. C’est un repli, pas le centre de la conception.
Sur Mac, c’est la même phrase dans un autre dialecte : VideoToolbox décode dans le moteur multimédia, les images entrent dans le pipeline sous forme de CVPixelBuffer, Metal affiche le HDR via l’EDR, et les exports ProRes et HEVC repassent par VideoToolbox.
Les exports parallèles par segments découpent la timeline en morceaux, et chaque morceau suit ce même pipeline, pas un raccourci qui sauterait le traitement des couleurs pour aller plus vite.
Ce que vous pouvez régler dans KwaFlux
L’essentiel est automatique. Ces réglages modifient le fonctionnement :
- Décodage matériel (Paramètres › Performances) : Auto (par défaut), Activé ou Désactivé. Si un fichier se décode avec des défauts ou des erreurs, passez sur Désactivé pour diagnostiquer avec le décodage logiciel. Le changement s’applique après le redémarrage de l’app.
- Processeur d’IA (Paramètres › Performances) : utiliser le GPU pour le traitement IA ou laisser l’app décider. Le GPU est généralement plus rapide ; le choix s’applique au prochain export, au prochain aperçu ou à la prochaine génération de masque.
- Ressources utilisées par l’export IA : Charge légère (un seul flux, et un seul GPU sur les machines qui en ont plusieurs), Équilibré (par défaut), Pleine vitesse, ou un mode personnalisé (choix des GPU et du nombre de flux par GPU). Baisser le niveau s’applique tout de suite à un export en cours, sans perdre les segments déjà terminés.
Problèmes courants
| Problème | Cause probable | Solution |
|---|---|---|
| Un fichier s’affiche en aperçu avec des défauts ou une image verte | Le décodeur matériel de ce GPU ne gère pas entièrement cette variante de codec | Passer Décodage matériel sur Désactivé et redémarrer pour décoder par logiciel |
| Les sections SDR paraissent grises pendant la lecture HDR | Le lecteur ne change pas de mode d’affichage à chaque image, ou les balises du fichier sont erronées | Vérifier avec ffprobe la caractéristique de transfert de chaque section |
| CPU très chargé et GPU inactif pendant l’export | Le chemin est redescendu à un barreau qui passe par la mémoire système, ou un filtre ne tourne que sur le CPU | Mettre à jour le pilote du GPU ; vérifier si un réglage n’est traité que par le CPU |
| NVIDIA signale trop de sessions pendant des exports parallèles | Plus de sessions d’encodage que le pilote n’en autorise | Lancer moins de travaux en parallèle, ou régler les ressources sur Charge légère ou Équilibré |
| Exports lents sur un portable à deux GPU | Le décodage et l’affichage sont sur des GPU différents, d’où des copies entre GPU | Attribuer le GPU dédié à KwaFlux dans les réglages graphiques du système |
Ce que cette architecture ne peut pas faire
- Le sans-copie sur tous les chemins. Les barreaux 4 et 5 de l’échelle passent par la mémoire système, et les GPU anciens ou les pilotes sans extensions d’interopérabilité y aboutissent.
- Reproduire le Dolby Vision. Côté HDR, ce qui tient la route, ce sont le HDR10 statique et le HLG.
- Une interopérabilité aussi complète que sous Windows sur Mac. Les points forts du Mac sont VideoToolbox, ProRes, les images CVPixel et l’EDR de Metal, pas autant de passerelles que sous Windows.
- Promettre un facteur d’accélération. Le gain apporté par moins de copies dépend du GPU, du pilote, de la résolution et des étapes de traitement ; prévisualisez et mesurez avec vos propres images.
Conclusion
Un pipeline tout-GPU n’est pas un slogan, c’est une table de routage capable de redescendre. Les machines rapides gardent les pixels sur le GPU de bout en bout, les plus lentes redescendent d’un cran à la fois et terminent quand même le travail. Au prochain export, jetez un œil à la charge du GPU et du CPU : vous saurez quel chemin vos pixels ont pris.
Testez sur vos propres images
KwaFlux exécute la Conversion de format et tous les outils d’IA sur votre propre GPU, en gardant le décodage, le traitement et l’encodage sur la carte graphique autant que possible. Le traitement IA tourne sur votre propre GPU et vos fichiers média ne sont pas envoyés pour être traités. KwaFlux fonctionne sous Windows 10 (64 bits, version 1809 ou plus récente), Windows 11 et macOS 12 ou plus récent sur Apple Silicon. Les aperçus ne demandent pas de compte : rendez un aperçu de 1, 3 ou 5 secondes sur n’importe quel clip. Une connexion avec un forfait payant n’est requise que pour exporter, convertir, réparer un fichier ou télécharger un fichier depuis un lien.
Testez sur vos propres images
Téléchargez KwaFlux et prévisualisez gratuitement les effets sur vos propres images avant de payer — sans compte, traitement sur votre GPU, sans envoi de vos médias. Les aperçus vidéo durent 1, 3 ou 5 secondes, ceux de la stabilisation 5, 15 ou 30 secondes.
Questions fréquentes
Que veut dire « sans copie » (zero-copy) ?
Cela veut dire que deux composants partagent la même mémoire et se passent l’accès au lieu de copier les pixels. L’extension WGL_NV_DX_interop2 de NVIDIA, par exemple, enregistre une texture D3D11 comme objet OpenGL ; une fois verrouillée, OpenGL la lit et l’écrit sans passer par la mémoire système.
Un deuxième GPU accélère-t-il les exports ?
Parfois. Une deuxième carte aide quand le logiciel découpe la timeline en segments et les traite en parallèle sur les deux GPU. Elle n’accélère pas un flux unique, et décoder sur une carte tout en affichant sur l’autre ajoute des copies entre GPU, qui coûtent du temps au lieu d’en faire gagner.
Combien d’encodages matériels une carte NVIDIA grand public peut-elle mener en même temps ?
Jusqu’à 12, d’après la matrice actuelle de NVIDIA pour les cartes GeForce dotées d’un encodeur ; la plupart des cartes professionnelles et pour centres de données n’ont pas de limite. Un nouvel encodage au-delà du plafond échoue : gardez-le en tête quand vous exportez plusieurs fichiers en parallèle.
Le décodage matériel est-il meilleur que le décodage logiciel ?
Pas forcément. Avec une mémoire GPU limitée, un codec très récent ou des paramètres de fichier inhabituels, le décodage matériel peut échouer ou abîmer l’image, et avec un CPU puissant le décodage logiciel n’est pas lent. Une bonne conception garde les deux, choisit selon le cas et revient au logiciel quand le matériel ne peut pas décoder.
Pourquoi mon export reste-t-il lent avec l’accélération matérielle ?
Le plus souvent parce que le goulot d’étranglement n’est pas le décodage. L’inférence IA, les filtres et l’encodage prennent aussi du temps, et toute étape qui retombe en mémoire système fait attendre le pipeline. Regardez quelle partie attend : un GPU peu chargé avec un CPU très chargé signifie le plus souvent que quelque chose est retombé sur le CPU. Voyez traitement vidéo IA local ou dans le cloud.
Sources
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (consulté le 2026-10-22)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (consulté le 2026-10-22)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (consulté le 2026-10-22)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (consulté le 2026-10-22)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (consulté le 2026-10-22)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (consulté le 2026-10-22)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (consulté le 2026-10-22)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (consulté le 2026-10-22)
KwPlus dans Coulisses de KwaFlux
À lire ensuite

KwaFlux : tout ce qu’il faut savoir (fonctions, plateformes, prix, mises à jour)
Ce qu’est KwaFlux, ce qu’il contient, sur quels systèmes il tourne, ce qui est gratuit ou payant, les licences et les nouveautés de chaque version.
KwaFlux sur Mac : modèles compatibles, installation et conseils de performance
Quels Mac font tourner KwaFlux, l’installation, le composant d’accélération GPU et le mode standard, et comment accélérer l’IA sur Apple Silicon.
Comment accélérer l’amélioration vidéo par IA : méthode, réglages et matériel
Pourquoi l’amélioration vidéo par IA est lente et comment l’accélérer : traiter moins, bien choisir la taille de sortie, l’ordre des étapes, les réglages.