Un fotograma que no tiene que volver a casa: cómo mantiene KwaFlux el vídeo en la GPU de la decodificación a la codificación
Un fotograma 4K de 10 bits ocupa unos 24,9 MB y cada viaje entre la RAM y la GPU cuesta tiempo. Así mantiene KwaFlux los píxeles en la GPU.
Lo esencial
Un flujo de vídeo íntegramente en GPU mantiene los píxeles en la memoria de la GPU desde la decodificación hasta la codificación, pasando por el procesamiento de imagen y la inferencia de IA, en lugar de copiarlos de un lado a otro entre la memoria del sistema y la tarjeta gráfica. Menos copias significan exportaciones más rápidas, vistas previas más fluidas y una CPU desahogada.
En esta guía verá cómo lo consigue el motor multimedia de KwaFlux: un adaptador de fotogramas que hace que nueve tipos de fotograma hablen el mismo idioma, cómo se puntúan y eligen los decodificadores y codificadores por hardware de tres fabricantes de GPU, la escalera de interoperabilidad de cinco peldaños entre D3D11 y OpenGL, VideoToolbox y Metal en Mac, y cómo el reproductor lleva el HDR a la pantalla. Termina con el recorrido completo de un píxel durante una exportación y con los ajustes que puede cambiar en KwaFlux.
- Un fotograma 4K de 10 bits y 4:2:0 ocupa unos 24,9 MB. A 60 fps, cada viaje entre la memoria del sistema y la de la GPU mueve alrededor de 1,5 GB por segundo. Cuantos más viajes, más lenta la exportación y más entrecortada la vista previa.
- El motor multimedia de KwaFlux da a cada fotograma un documento de identidad: puntero CUDA, textura D3D11, textura Metal o memoria del sistema. Las capas superiores solo ven «un fotograma» y, cuando otra API lo necesita, el motor elige el puente que menos cuesta.
- En Windows, la decodificación y la codificación por hardware de NVIDIA, Intel, AMD y las de D3D11 y D3D12 del sistema se instalan como complementos. Se puntúan según la GPU, la memoria y la resolución; si uno falla entra el siguiente, y la decodificación por software recoge lo que quede.
- Una textura D3D11 llega a OpenGL por una escalera de cinco peldaños: sin copias en NVIDIA, casi sin copias en AMD e Intel, un rodeo por CUDA, una transferencia asíncrona y una alternativa por CPU. Los equipos rápidos usan los peldaños de arriba y los antiguos los de abajo, y en ambos casos la imagen sigue llegando.
- No todos los caminos van sin copias: los dos peldaños de abajo pasan por la memoria del sistema. Un flujo íntegramente en GPU significa quedarse en la GPU todo lo posible y bajar un peldaño cuando no, en lugar de fallar.
Por qué sale caro mandar un píxel a casa
Un píxel vuelve a casa cuando un fotograma se copia de la memoria de la GPU a la del sistema, se procesa y se vuelve a subir. Los decodificadores por hardware escriben la imagen en la memoria de la GPU, los modelos de IA y los filtros de imagen se ejecutan en la GPU y los codificadores por hardware también leen de ella. Basta con que un paso intermedio solo acepte píxeles en la memoria del sistema para que el fotograma tenga que ir y volver por el bus PCIe.
Este es el tamaño de un fotograma (en 4:2:0, la crominancia añade la mitad del tamaño de la luma):
| Formato | Un fotograma | Por viaje a 30 fps | Por viaje a 60 fps |
|---|---|---|---|
| 1080p, NV12 de 8 bits | 3,1 MB | 93 MB/s | 187 MB/s |
| 4K, NV12 de 8 bits | 12,4 MB | 373 MB/s | 746 MB/s |
| 4K, P010 de 10 bits | 24,9 MB | 746 MB/s | 1,49 GB/s |
| 4K, RGBA en media precisión (habitual en procesamiento de IA y HDR) | 66,4 MB | 1,99 GB/s | 3,98 GB/s |
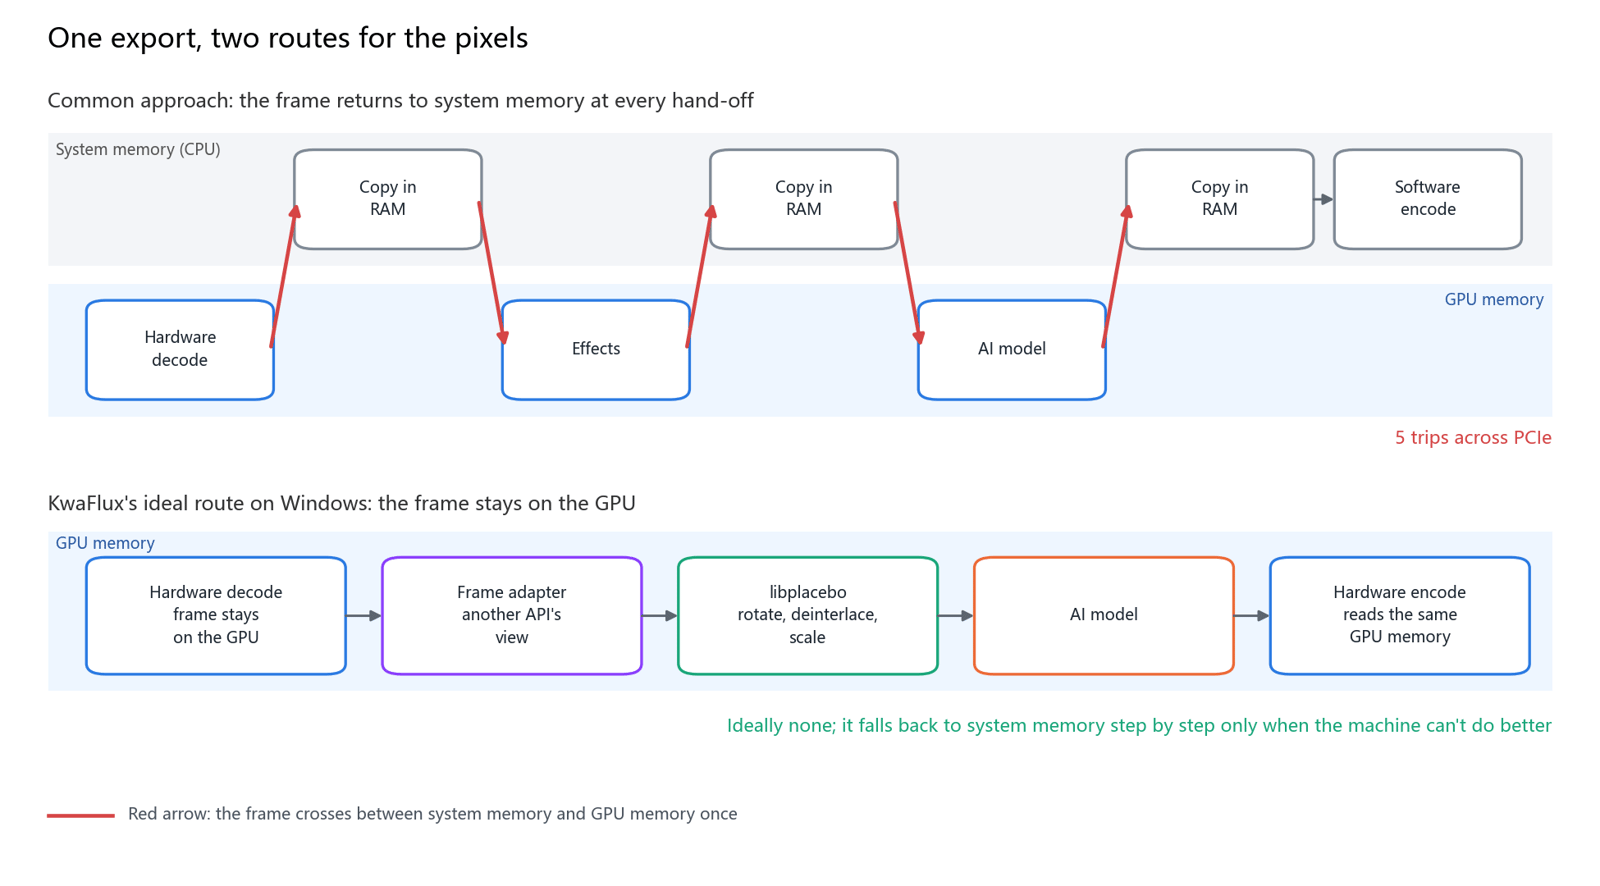
PCIe 4.0 x16 ofrece en teoría unos 31,5 GB/s en cada sentido. Parece de sobra, pero es un pico; cada copia también espera a que la GPU termine lo que está haciendo y a que el controlador sincronice, y la CPU tiene que organizarlo todo. La mitad superior de la figura muestra un enfoque habitual: decodificación, efectos, IA y codificación quieren cada uno su propia memoria, y un mismo fotograma cruza el PCIe cinco veces en una sola exportación. En 4K de 10 bits a 60 fps, eso supone unos 7,5 GB por segundo solo en copias.
El adaptador de fotogramas: nueve tipos de fotograma, una sola interfaz
El adaptador de fotogramas es una capa del motor multimedia de KwaFlux que hace que un fotograma se presente igual ante el reproductor, los efectos y los codificadores, esté en la memoria que esté. El software multimedia está lleno de dialectos: FFmpeg habla AVFrame, NVIDIA habla punteros de dispositivo CUDA, los decodificadores por hardware de Intel y AMD entregan texturas D3D11, Vulkan habla VkImage y Apple CVPixelBuffer. Cada uno tiene su propia vida útil, alineación y disposición del color.
| Tipo de fotograma | Dónde está | Quién lo produce |
|---|---|---|
| Fotograma FFmpeg | Un AVFrame en la memoria del sistema | La decodificación por software y todos los caminos de reserva |
| Fotograma D3D11 | Una ID3D11Texture2D | La decodificación por hardware D3D11VA, Intel y AMD en Windows |
| Fotograma D3D12 | Un recurso D3D12 | La decodificación de vídeo D3D12 |
| Fotograma CUDA | Un puntero de dispositivo CUDA | La decodificación NVDEC de NVIDIA; entrada nativa de NVENC |
| Fotograma OpenGL | Una textura o un framebuffer object | Filtros, vistas previas y renderizado multiplataforma |
| Fotograma Vulkan | Una VkImage | Decodificación y renderizado de vídeo Vulkan |
| Fotograma Metal | Una MTLTexture | Visualización y HDR en macOS |
| Fotograma CVPixel | Un CVPixelBuffer | Decodificación VideoToolbox en macOS |
| Fotograma OpenCV | Una cv::Mat | Algoritmos que leen los píxeles directamente |
Las capas superiores reciben una única interfaz de fotograma y, cuando necesitan otra forma, la piden; el motor elige el puente que menos cuesta en ese equipo. Unas cuantas decisiones de diseño evitan que todo se desmorone con el tercer fabricante de GPU:
- Los tipos se fijan al compilar. Una consulta entre interfaces es una conversión estática, no información de tipos en tiempo de ejecución, así que nada choca en las fronteras entre DLL.
- Solo los fotogramas que poseen recursos de GPU tienen operaciones de GPU. Clonar, convertir y exportar a una matriz pertenecen a los tipos de fotograma concretos, no a la interfaz común.
- La propiedad es explícita. Quien reserva libera, y los handles compartidos no se liberan dos veces. Cuando se reconstruye un dispositivo de GPU, los recursos de interoperabilidad que dependen de él se invalidan y se reconstruyen con él, de modo que ninguna textura del dispositivo anterior queda colgada del nuevo.
Windows: decodificación y codificación por hardware en tres fabricantes de GPU
En Windows, KwaFlux instala ocho complementos de decodificación de vídeo y seis de codificación, cada uno en su propia DLL. Tras el demultiplexado, el selector sigue la configuración; en automático, puntúa a cada candidato, prueba primero el de mayor puntuación y pasa al siguiente si la inicialización falla. La decodificación por software recoge todo lo demás.
| Complemento de decodificación | Fotograma que produce | Códecs |
|---|---|---|
| NVDEC de NVIDIA | Fotograma CUDA, NV12 de 8 bits o P016 de 10 bits | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D11VA (decodificación por hardware del sistema) | Textura NV12 de D3D11 | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D12VA | Recurso D3D12 | H.264, HEVC, VP9, AV1 |
| Intel oneVPL (GPU Intel actuales) | Textura D3D11 | H.264, HEVC, VP9, AV1, MJPEG |
| Intel Media SDK (gráficos integrados de Core de 5.ª a 10.ª generación) | Textura D3D11 | H.264, HEVC, MPEG-2, MJPEG |
| AMF de AMD | Textura D3D11, envuelta directamente en una superficie AMF | H.264, HEVC, VP9, AV1, MPEG-2 |
| Vulkan Video | Imagen Vulkan | H.264, HEVC |
| Decodificación por software de FFmpeg | Fotograma en la memoria del sistema | Todo lo que lee FFmpeg, incluidos VP8 y VP9 con canal alfa |
La tabla muestra lo que gestiona cada complemento; que su GPU pueda decodificar un códec por hardware depende de su generación. Según la matriz de compatibilidad de NVIDIA, por ejemplo, las tarjetas de consumo decodifican AV1 por hardware a partir de la serie RTX 30.
Qué tiene en cuenta la puntuación. El fabricante equivocado queda fuera de inmediato: en una GPU que no es de NVIDIA, NVDEC no suma ningún punto. Los decodificadores por hardware pierden puntos cuando falta memoria de GPU y, con una CPU potente, la decodificación por software puede ganar, para no lastrar el equipo solo por decir que se usa hardware. El 4K da puntos al hardware, porque es justo cuando deben trabajar las unidades de función fija. Si se muestra a través de D3D11, D3D11VA gana puntos, y decodificar en una GPU distinta de la que controla la pantalla resta, porque las copias entre GPU penalizan.
Codificación: el codificador toma lo que entregó el decodificador.
| Complemento de codificación | Entrada preferida | Códecs de salida |
|---|---|---|
| NVENC de NVIDIA | Fotogramas CUDA; también acepta fotogramas D3D11, D3D12, Vulkan, OpenGL y de la memoria del sistema | H.264, HEVC, AV1 |
| Intel oneVPL | Texturas D3D11 de la misma GPU, copiadas en la GPU | H.264, HEVC, AV1, VP9, MJPEG |
| AMF de AMD | Texturas D3D11 envueltas directamente en superficies AMF, con paquetes recogidos de forma asíncrona | H.264, HEVC, AV1 |
| Intel Media SDK | Texturas D3D11 o fotogramas de la memoria del sistema | H.264, HEVC, MPEG-2, MJPEG |
| Vulkan Video | Fotogramas Vulkan | H.264, HEVC |
| Codificación por software de FFmpeg | Fotogramas de la memoria del sistema | Lo que admitan los codificadores por software |
NVENC es donde más claro se ve por qué importa el adaptador de fotogramas: no exige que cada fotograma pase antes a CUDA. Un fotograma CUDA se copia en 2D dentro del dispositivo; uno D3D11 pasa por interoperabilidad; D3D12 pasa por D3D11 hasta CUDA; Vulkan usa memoria externa, y OpenGL un puente de búfer de píxeles. Solo un fotograma que ya estaba en la memoria del sistema se sube una vez. En HEVC y AV1, los datos de masterización HDR y de luz del contenido van en la configuración del codificador; H.264 no tiene un campo nativo para ellos, así que el complemento los escribe por su cuenta en SEI.
Nota: según la matriz de compatibilidad de NVIDIA, las tarjetas GeForce con codificador admiten como máximo 12 sesiones de codificación simultáneas. Cuando se agotan, el complemento NVENC de KwaFlux se retira y pasa el trabajo al siguiente codificador, en lugar de fallar a mitad de la exportación.
Los complementos llevan una comprobación de versión y no se cargan si no coincide, y la detección de capacidades puede puntuar un complemento sin cargarlo. Una nueva generación de GPU supone añadir un complemento; el reproductor y el conversor que hay encima no cambian.
La escalera de cinco peldaños: llevar una textura D3D11 a OpenGL
El decodificador y la API de visualización a menudo no coinciden: NVIDIA decodifica en CUDA o D3D11 mientras la imagen tiene que llegar a OpenGL, e Intel decodifica en D3D11 mientras un filtro trabaja sobre una textura OpenGL. El núcleo gráfico de KwaFlux construye el puente, y entre D3D11 y OpenGL se trata de una escalera de cinco peldaños por la que se sube tanto como el equipo permita:
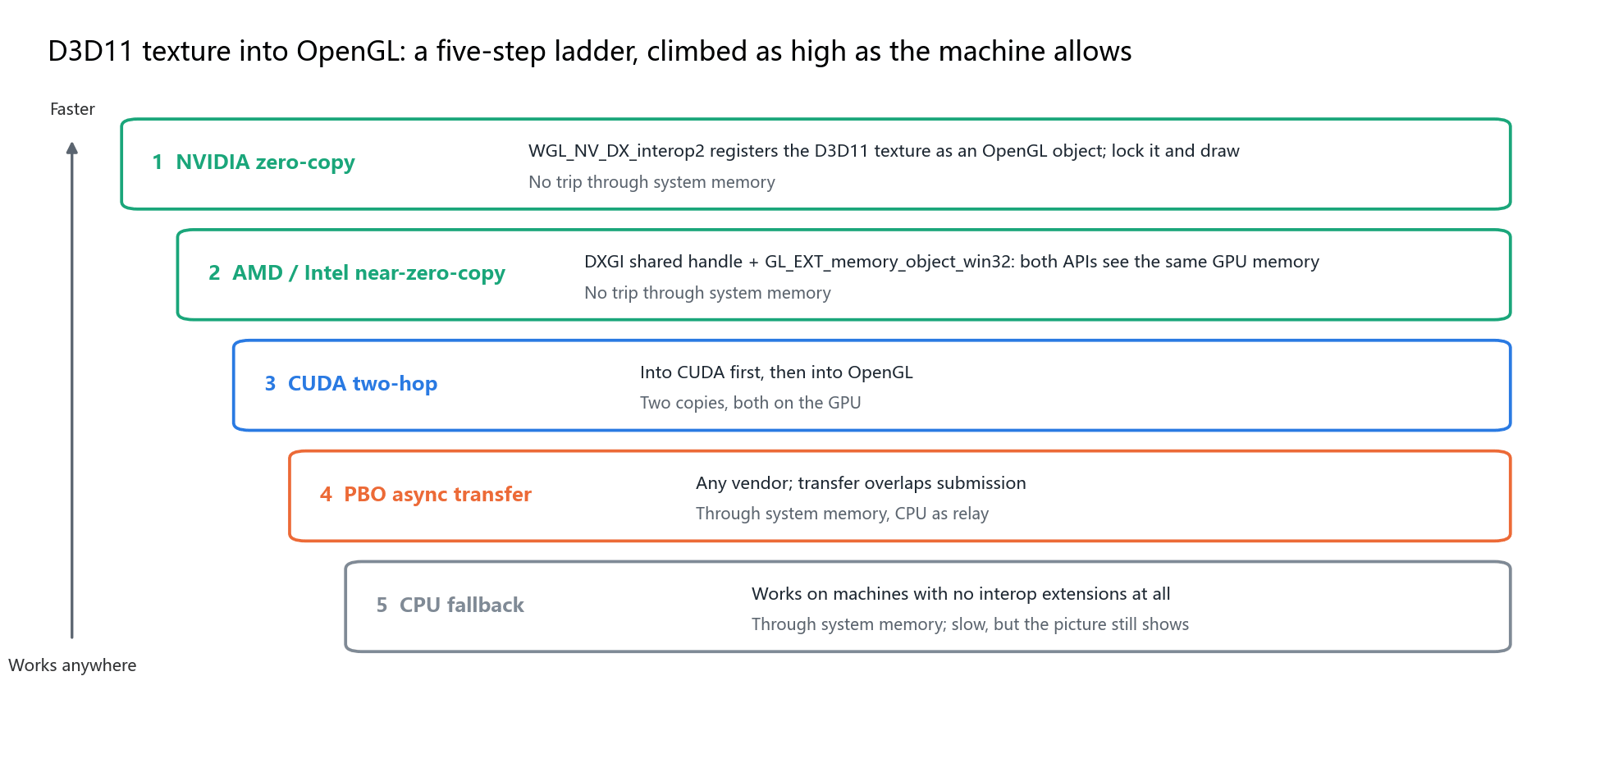
- Sin copias en NVIDIA. La extensión
WGL_NV_DX_interop2registra una textura D3D11 como objeto OpenGL; una vez bloqueada, OpenGL la lee y la escribe directamente, sin pasar por la memoria del sistema. - Casi sin copias en AMD e Intel. Un handle compartido DXGI y la extensión
GL_EXT_memory_object_win32permiten que ambas API vean la misma memoria de GPU. - Rodeo por CUDA. Primero a CUDA y luego a OpenGL; las dos copias se hacen en la GPU.
- Transferencia asíncrona con pixel buffer objects (PBO). Funciona con cualquier fabricante; la transferencia se solapa con el envío de comandos y la CPU solo hace de intermediaria.
- Alternativa por CPU. En un equipo sin ninguna extensión de interoperabilidad, la imagen llega igualmente, solo que más despacio.
Junto a la escalera hay puentes específicos. CUDA y D3D11 se registran entre sí. D3D12 y D3D11 comparten recursos mediante un handle compartido DXGI con sincronización por fence, de modo que D3D12 no necesita un puente directo con cada una de las demás API. Vulkan y D3D11 usan memoria externa. Los kernels CUDA de conversión de color están compilados en la biblioteca, así que NV12 y P016 pasan a BGRA en la GPU, y las imágenes de 10 bits pueden quedarse en RGBA de 16 bits en lugar de recortarse a 8 bits nada más entrar.
Mac: VideoToolbox decodifica, Metal muestra
En macOS no se compite por la longitud de la lista de complementos. Apple integró la codificación y la decodificación en el motor multimedia de sus chips, y KwaFlux conecta ese motor al mismo lenguaje de fotogramas:
- La decodificación pasa por VideoToolbox, que entrega un
CVPixelBufferenvuelto como fotograma CVPixel. Abarca H.264, HEVC, VP9 y ProRes. - La codificación usa
h264_videotoolbox,hevc_videotoolboxyprores_videotoolbox, así que las exportaciones ProRes también pasan por VideoToolbox. - La visualización pasa por Metal.
CAMetalLayercomprueba si la pantalla admite rango dinámico extendido (EDR): si lo admite, el HDR se muestra a través de EDR; si no, las mismas matemáticas de mapeo de tonos que en Windows llevan el PQ o el HLG a SDR.
Para el reproductor, los efectos y la conversión, una textura D3D11 en Windows y un CVPixelBuffer en Mac son simplemente «un fotograma», así que las funciones no se dividen en dos bases de código según el sistema.
El reproductor: el audio marca el tiempo y el HDR cambia por fotograma
El audio es el reloj maestro. El oído tolera mucho peor los tirones que la vista, así que la imagen sigue al sonido y no al revés. Entre llamadas de audio, el reloj se interpola linealmente con la hora del sistema y se suaviza con una media móvil exponencial, y los umbrales son proporcionales al intervalo entre fotogramas en lugar de un número fijo de milisegundos. Cada fotograma recibe una de tres decisiones: esperar, dibujar o descartar. Lo que se descarta es un fotograma que llega tarde, no su posición en el vídeo.
Saltar a otro punto es una transacción. Se interrumpe la decodificación, se vacían los fotogramas caducados, un número de generación deja fuera los fotogramas antiguos y el reloj se reinicia; el reloj de audio solo vuelve a correr cuando la imagen de la nueva posición se ha dibujado de verdad. Lo que ve es el punto al que ha saltado, no el último segundo que quedaba en la cola.
El HDR no se activa para todo un archivo de golpe. Cada fotograma se juzga por su propia característica de transferencia: solo PQ y HLG piden una swap chain HDR, y si la sección siguiente es SDR, la swap chain vuelve atrás, para que una imagen normal no se trate como señal PQ y se vea gris. El HLG se convierte a PQ en un shader antes de enviarlo a la pantalla.
| Backend de visualización | Uso | Tratamiento del HDR |
|---|---|---|
| D3D11 | Camino principal en Windows | Swap chain de 10 bits con PQ y BT.2020 sin modificar; se lleva a SDR en un shader en pantallas sin HDR |
| Vulkan | Camino gráfico moderno | Superficie HDR10, de 10 bits o media precisión |
| Metal | macOS | Rango dinámico extendido con CAMetalLayer, mismo mapeo de tonos |
| OpenGL | Camino común a todas las plataformas | Sin paso directo de HDR; lleva el HDR a SDR |
HDR en una pantalla normal. Los cuatro backends comparten un mismo mapeador de tonos: el PQ o el HLG se convierte en luminancia real en nits, se pasa a IPT, se procesa con tablas de tonos y de gama y se entrega como BT.709 y sRGB. La tabla de tonos sigue el pico de la imagen, medido en un objetivo diminuto fuera de pantalla y leído sin detener la GPU, con suavizado en los cambios de escena. Si un archivo no indica la luminancia de masterización, el mapeador parte de 1.000 nits en lugar de una constante favorecedora. Los subtítulos que pasan de sRGB a una swap chain HDR se suben al blanco de referencia PQ, para que el texto blanco no se vea gris en escenas luminosas.
La reproducción comparativa separa el original y la imagen procesada en dos flujos, y cada lado del divisor guarda su propio historial de brillo, así que una escena nocturna a la izquierda no oscurece la luz de día de la derecha. Durante la reproducción, las tareas en segundo plano ceden su parte de GPU y la recuperan poco a poco al parar: primero la reproducción en tiempo real, las exportaciones esperan su turno.
libplacebo: escalado, mapeo de tonos y eliminación de bandas
libplacebo es la biblioteca de calidad de imagen en GPU que salió del reproductor mpv. KwaFlux la integra como nodo de efecto y elige su backend según el fotograma que llega: los fotogramas OpenGL, los decodificados por software, los CUDA y los CVPixel pasan por OpenGL; el NV12 de D3D11 va directo al backend D3D11, lo que ahorra una conversión de color de ida y vuelta; los fotogramas Vulkan se quedan en Vulkan.
- Para ampliar se usa EWA Lanczos y para reducir Lanczos, con bilineal cuando importa la velocidad.
- Para pasar de HDR a SDR se puede elegir entre las curvas BT.2390, Reinhard, Spline y Hable, con el pico medido en la imagen.
- La eliminación de bandas, el tramado y el antirringing evitan que los degradados del cielo se conviertan en franjas.
- El desentrelazado usa una ventana temporal con el fotograma anterior, el actual y el siguiente, en lugar de adivinar cada fotograma por separado.
- Hay dos preajustes, Rápido y Alta calidad: Rápido para las vistas previas y el escalado previo a la codificación, Alta calidad para el renderizado final.
Las correcciones automáticas (rotación, relación de aspecto del píxel, entrelazado, posición de la crominancia) y el escalado previo a la codificación se confían primero a libplacebo. Cuando un reescalado cambia la resolución, el nodo de escalado sigue antes del codificador, que recibe así el tamaño de destino. Si libplacebo no arranca, los filtros scale, zscale y yadif de FFmpeg toman el relevo, y la falta de un módulo no detiene el trabajo.
El recorrido ideal de un píxel en una exportación
Si se unen las piezas, una exportación en Windows funciona así:
- El archivo se demultiplexa en paquetes y el selector elige el decodificador por hardware adecuado para ese equipo.
- Los fotogramas nacen como punteros CUDA o texturas D3D11, no como un bloque reservado en la memoria del sistema.
- La rotación, la corrección de la relación de aspecto, el desentrelazado o el mapeo de tonos para una versión SDR los hace libplacebo en la GPU.
- Los modelos de IA (reescalado, Reparación de calidad, SDR a HDR y otros) procesan cada fotograma en la GPU; el tipo de fotograma puede cambiar por el camino sin que el trabajo tenga que saber qué puente ha cruzado.
- Si la resolución debe ajustarse a un destino, se hace otro escalado rápido.
- Cada codificador recibe los fotogramas a su manera: NVENC toma CUDA, y oneVPL y AMF toman D3D11.
- Los paquetes entran en el multiplexor, se ordenan las marcas de tiempo y se escribe el archivo.
En una frase: la decodificación por hardware deja una textura, la interoperabilidad se la muestra a otra API, el procesamiento de imagen se queda en la GPU y el codificador por hardware lee sus fotogramas de la misma memoria de GPU. La memoria del sistema solo aparece cuando el equipo no tiene un puente más alto o cuando un paso necesita de verdad leer los píxeles en la CPU. Es un alternativa de reserva, no el centro del diseño.
En Mac es la misma frase en otro dialecto: VideoToolbox decodifica en el motor multimedia, los fotogramas entran en el flujo como CVPixelBuffer, Metal muestra el HDR mediante EDR y las exportaciones ProRes y HEVC vuelven a VideoToolbox.
Las exportaciones en paralelo por segmentos dividen la línea de tiempo en tramos, y cada tramo recorre este mismo flujo, no un atajo que se salte el procesamiento del color para ir más rápido.
Qué puede ajustar en KwaFlux
Casi todo es automático. Estos ajustes cambian cómo funciona:
- Decodificación por hardware (Ajustes › Rendimiento): Automático (por defecto), Activado o Desactivado. Si un archivo se decodifica con fallos o errores, póngalo en Desactivado para diagnosticar con decodificación por software. El cambio se aplica al reiniciar la app.
- Procesador de IA (Ajustes › Rendimiento): si el procesamiento de IA usa la GPU o lo decide la app. La GPU suele ser más rápida; la elección se aplica a la siguiente exportación, vista previa o generación de máscara.
- Uso de recursos en la exportación con IA: Carga baja (un solo flujo y, en equipos con varias GPU, solo una), Equilibrado (por defecto), Máxima velocidad o Personalizado (qué GPU usar y cuántos flujos ejecuta cada una). Bajar el nivel se aplica en el acto a una exportación en curso, sin perder los segmentos ya terminados.
Problemas habituales
| Problema | Causa probable | Solución |
|---|---|---|
| Un archivo se ve en la vista previa con fallos o en verde | El decodificador por hardware de esa GPU no admite del todo esa variante del códec | Poner Decodificación por hardware en Desactivado y reiniciar para decodificar por software |
| Las secciones SDR se ven grises al reproducir HDR | El reproductor no cambia de modo de visualización por fotograma, o las etiquetas del archivo son incorrectas | Revisar con ffprobe la característica de transferencia de cada sección |
| CPU muy cargada y GPU ociosa durante la exportación | El camino ha bajado a un peldaño que pasa por la memoria del sistema, o un filtro solo funciona en la CPU | Actualizar el controlador de la GPU; comprobar si algún ajuste solo se procesa en la CPU |
| NVIDIA avisa de demasiadas sesiones en exportaciones en paralelo | Más sesiones de codificación de las que permite el controlador | Lanzar menos trabajos en paralelo o poner el uso de recursos en Carga baja o Equilibrado |
| Exportaciones lentas en un portátil con dos GPU | La decodificación y la visualización van en GPU distintas y generan copias entre ellas | Asignar la GPU dedicada a KwaFlux en los ajustes gráficos del sistema |
Lo que esta arquitectura no puede hacer
- Ir sin copias por todos los caminos. Los peldaños 4 y 5 de la escalera pasan por la memoria del sistema, y ahí acaban las GPU antiguas o los controladores sin extensiones de interoperabilidad.
- Reproducir Dolby Vision. En HDR, lo que se sostiene es el HDR10 estático y el HLG.
- Ofrecer en Mac una interoperabilidad tan amplia como en Windows. Los puntos fuertes del Mac son VideoToolbox, ProRes, los fotogramas CVPixel y el EDR de Metal, no tantos puentes como en Windows.
- Prometer un factor de aceleración. Cuánto más rápida es una exportación con menos copias depende de la GPU, el controlador, la resolución y los pasos de procesamiento; haga vistas previas y mida con su propio material.
Conclusión
Un flujo íntegramente en GPU no es un eslogan, sino una tabla de rutas que sabe bajar peldaños. Los equipos rápidos mantienen los píxeles en la GPU de principio a fin, y los más lentos bajan de uno en uno y terminan el trabajo igualmente. En la próxima exportación, eche un vistazo a la carga de la GPU y de la CPU: sabrá qué camino han seguido sus píxeles.
Pruebe con su propio metraje
KwaFlux ejecuta la Conversión de formato y todas las herramientas de IA en su propia GPU, y mantiene la decodificación, el procesamiento y la codificación en la tarjeta gráfica en la medida de lo posible. El procesamiento de IA corre en su propia GPU y sus archivos multimedia no se suben para procesarlos. Funciona en Windows 10 (64 bits, versión 1809 o posterior), Windows 11 y macOS 12 o posterior en Apple Silicon. Las vistas previas no requieren cuenta: renderice una vista previa de 1, 3 o 5 segundos de cualquier clip. Iniciar sesión con un plan de pago solo hace falta para exportar, convertir, reparar un archivo o descargar un archivo desde un enlace.
Pruebe con su propio metraje
Descargue KwaFlux y previsualice gratis los efectos en su propio material antes de pagar: sin cuenta, procesado en su GPU y sin subir sus archivos. Las vistas previas de vídeo duran 1, 3 o 5 segundos; las de estabilización, 5, 15 o 30 segundos.
Preguntas frecuentes
¿Qué significa «sin copias» (zero-copy)?
Significa que dos componentes comparten la misma memoria y se pasan el acceso en lugar de copiar los píxeles. La extensión WGL_NV_DX_interop2 de NVIDIA, por ejemplo, registra una textura D3D11 como objeto OpenGL y, una vez bloqueada, OpenGL la lee y la escribe sin pasar por la memoria del sistema.
¿Una segunda GPU acelera las exportaciones?
A veces. Una segunda tarjeta ayuda cuando el software divide la línea de tiempo en segmentos y los procesa en paralelo en las dos GPU. No acelera un único flujo, y decodificar en una tarjeta mientras se muestra en la otra añade copias entre GPU que cuestan tiempo en vez de ahorrarlo.
¿Cuántas codificaciones por hardware puede hacer a la vez una tarjeta NVIDIA de consumo?
Hasta 12, según la matriz actual de NVIDIA para tarjetas GeForce con codificador; la mayoría de las tarjetas profesionales y de centro de datos no tienen límite. Una codificación nueva por encima del límite falla, así que téngalo en cuenta al exportar varios archivos en paralelo.
¿La decodificación por hardware es mejor que la decodificación por software?
No siempre. Con poca memoria de GPU, un códec muy reciente o parámetros de archivo poco habituales, la decodificación por hardware puede fallar o estropear la imagen, y con una CPU potente la decodificación por software no es lenta. Lo sensato es un diseño que conserve ambas, elija según el caso y vuelva al software cuando el hardware no pueda decodificar.
¿Por qué mi exportación sigue siendo lenta con la aceleración por hardware activada?
Normalmente porque el cuello de botella no es la decodificación. La inferencia de IA, los filtros y la codificación también llevan tiempo, y cualquier paso que vuelva a la memoria del sistema hace que el flujo espere a las copias. Mire qué parte está esperando: una GPU poco cargada con una CPU muy cargada suele significar que algo ha vuelto a la CPU. Consulte procesamiento de vídeo con IA en local o en la nube.
Fuentes
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (consultado el 2026-10-22)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (consultado el 2026-10-22)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (consultado el 2026-10-22)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (consultado el 2026-10-22)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (consultado el 2026-10-22)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (consultado el 2026-10-22)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (consultado el 2026-10-22)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (consultado el 2026-10-22)
KwMás en KwaFlux por dentro
Siga leyendo

KwaFlux: todo lo que necesita saber (funciones, plataformas, precios y actualizaciones)
Qué es KwaFlux, qué incluye, en qué sistemas funciona, qué es gratis y qué es de pago, cómo funcionan las licencias y qué ha cambiado en cada versión.
KwaFlux en Mac: modelos compatibles, instalación y consejos de rendimiento
Qué Mac pueden usar KwaFlux, cómo instalarlo, qué son el componente de aceleración por GPU y el modo estándar, y cómo agilizar la IA en Apple Silicon.
Cómo acelerar la mejora de vídeo con IA: flujo de trabajo, ajustes y hardware
Por qué la mejora de vídeo con IA es lenta y cómo acelerarla: procese menos, elija el tamaño de salida, ordene los pasos y aproveche la GPU y los ajustes.