Um quadro não precisa voltar para casa: como o KwaFlux mantém o vídeo na GPU da decodificação à codificação
Um quadro 4K de 10 bits tem cerca de 24,9 MB, e cada viagem entre a RAM e a GPU custa tempo. Veja como o KwaFlux mantém os pixels na GPU.
O essencial
Um pipeline de vídeo todo na GPU mantém os pixels na memória da GPU da decodificação à codificação, passando pelo processamento de imagem e pela inferência de IA, em vez de copiá-los de um lado para o outro entre a memória do sistema e a placa de vídeo. Menos cópias significam exportações mais rápidas, prévias mais fluidas e uma CPU folgada.
Neste guia, você vai ver como o motor de mídia do KwaFlux faz isso: um adaptador de quadros que faz nove tipos de quadro falarem a mesma língua, como os decodificadores e codificadores por hardware de três fabricantes de GPU recebem nota e são escolhidos, a escada de interoperabilidade de cinco degraus entre D3D11 e OpenGL, VideoToolbox e Metal no Mac e como o player leva o HDR até a tela. No fim, mostramos o caminho completo de um pixel durante uma exportação e os ajustes que você pode mudar no KwaFlux.
- Um quadro 4K de 10 bits em 4:2:0 tem cerca de 24,9 MB. A 60 fps, cada viagem entre a memória do sistema e a memória da GPU movimenta cerca de 1,5 GB por segundo. Quanto mais viagens, mais lenta a exportação e mais travada a prévia.
- O motor de mídia do KwaFlux dá a cada quadro uma carteira de identidade: ponteiro CUDA, textura D3D11, textura Metal ou memória do sistema. As camadas de cima só enxergam "um quadro" e, quando outra API precisa dele, o motor escolhe a ponte de menor custo.
- No Windows, a decodificação e a codificação por hardware de NVIDIA, Intel, AMD e as de D3D11 e D3D12 do sistema vêm como plug-ins. Elas recebem uma nota conforme a GPU, a memória e a resolução; se uma falha, a próxima assume, e a decodificação por software segura o resto.
- Uma textura D3D11 chega ao OpenGL por uma escada de cinco degraus: sem cópia na NVIDIA, quase sem cópia na AMD e na Intel, um desvio pelo CUDA, transferência assíncrona e um plano B na CPU. Máquinas rápidas usam os degraus de cima, as mais antigas os de baixo, e a imagem continua chegando nos dois casos.
- Nem todo caminho é sem cópia: os dois degraus de baixo passam pela memória do sistema. Um pipeline todo na GPU quer dizer ficar na GPU o máximo possível e descer um degrau quando não der, em vez de falhar.
Por que mandar um pixel para casa sai caro
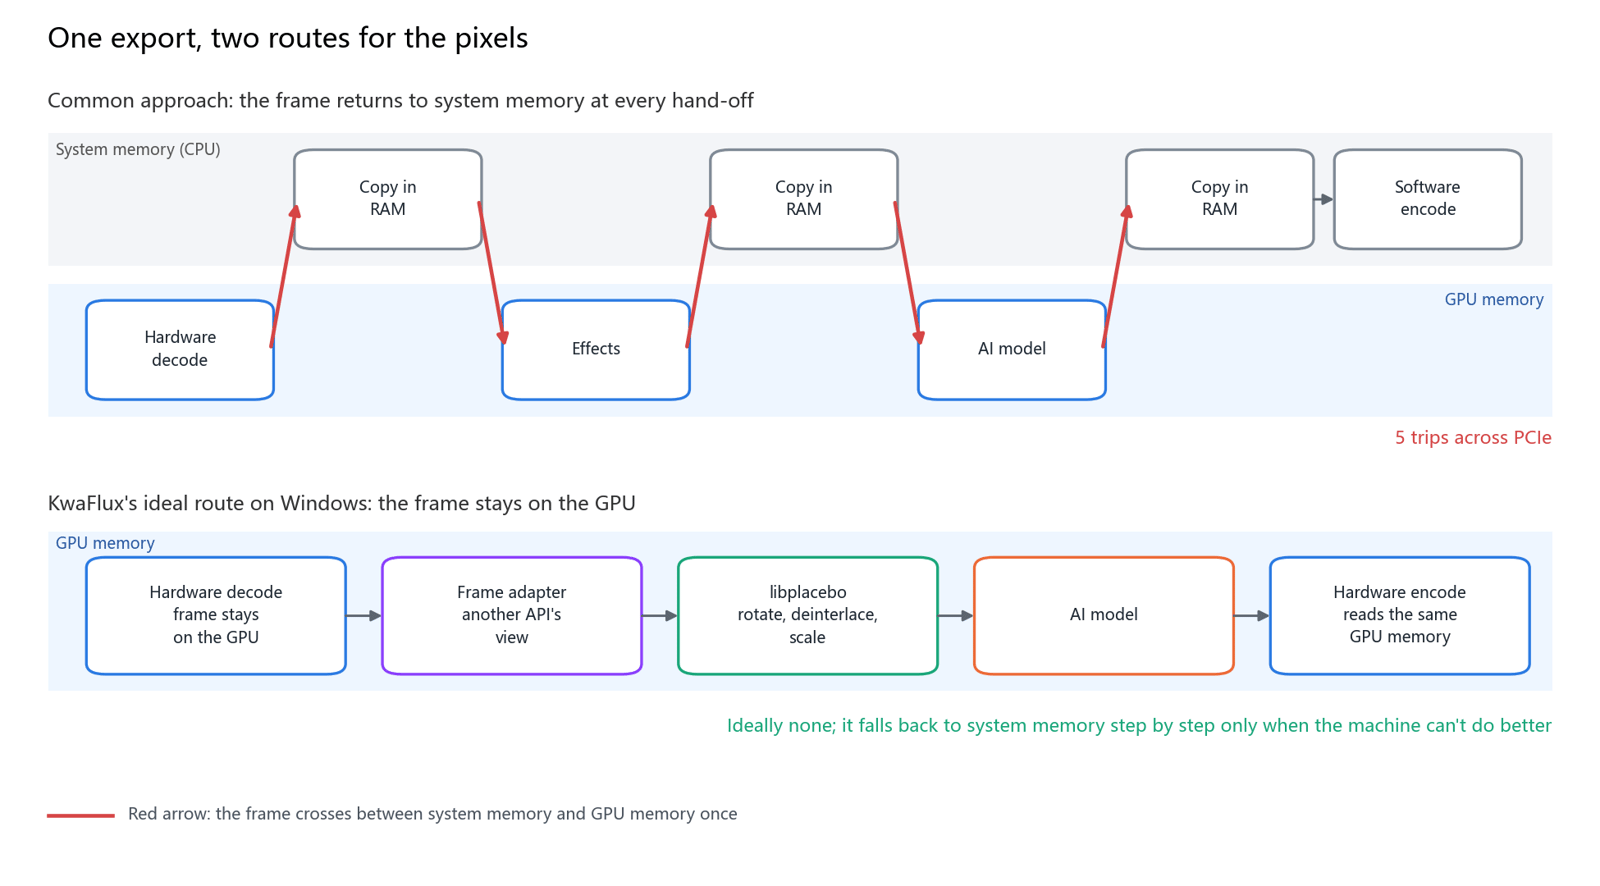
Um pixel volta para casa quando um quadro é copiado da memória da GPU para a memória do sistema, processado e enviado de volta. Os decodificadores por hardware gravam a imagem na memória da GPU, os modelos de IA e os filtros de imagem rodam na GPU, e os codificadores por hardware também leem dela. Basta uma etapa no meio aceitar só pixels na memória do sistema para o quadro precisar ir e voltar pelo PCIe.
Este é o tamanho de um quadro (em 4:2:0, a crominância soma metade do tamanho da luma):
| Formato | Um quadro | Por viagem a 30 fps | Por viagem a 60 fps |
|---|---|---|---|
| 1080p, NV12 de 8 bits | 3,1 MB | 93 MB/s | 187 MB/s |
| 4K, NV12 de 8 bits | 12,4 MB | 373 MB/s | 746 MB/s |
| 4K, P010 de 10 bits | 24,9 MB | 746 MB/s | 1,49 GB/s |
| 4K, RGBA em meia precisão (comum no processamento de IA e HDR) | 66,4 MB | 1,99 GB/s | 3,98 GB/s |
O PCIe 4.0 x16 oferece, em teoria, cerca de 31,5 GB/s em cada sentido. Parece sobrar, mas é um pico; cada cópia ainda espera a GPU terminar o que está fazendo e o driver sincronizar, e a CPU precisa organizar tudo. A metade de cima da figura mostra uma abordagem comum: decodificação, efeitos, IA e codificação querem cada uma a sua memória, e o mesmo quadro atravessa o PCIe cinco vezes em uma única exportação. Em 4K de 10 bits a 60 fps, isso dá cerca de 7,5 GB por segundo só em cópias.
O adaptador de quadros: nove tipos de quadro, uma só interface
O adaptador de quadros é uma camada do motor de mídia do KwaFlux que faz um quadro aparecer igual para o player, os efeitos e os codificadores, não importa em que memória ele esteja de fato. Software de mídia é cheio de dialetos: o FFmpeg fala AVFrame, a NVIDIA fala ponteiros de dispositivo CUDA, os decodificadores por hardware da Intel e da AMD entregam texturas D3D11, o Vulkan fala VkImage e a Apple CVPixelBuffer. Cada um tem o seu próprio tempo de vida, alinhamento e disposição das cores.
| Tipo de quadro | Onde ele fica | Quem o produz |
|---|---|---|
| Quadro FFmpeg | Um AVFrame na memória do sistema | A decodificação por software e todos os caminhos de reserva |
| Quadro D3D11 | Uma ID3D11Texture2D | A decodificação por hardware D3D11VA, Intel e AMD no Windows |
| Quadro D3D12 | Um recurso D3D12 | A decodificação de vídeo D3D12 |
| Quadro CUDA | Um ponteiro de dispositivo CUDA | A decodificação NVDEC da NVIDIA; entrada nativa do NVENC |
| Quadro OpenGL | Uma textura ou um framebuffer object | Filtros, prévias e renderização multiplataforma |
| Quadro Vulkan | Uma VkImage | Decodificação e renderização de vídeo Vulkan |
| Quadro Metal | Uma MTLTexture | Exibição e HDR no macOS |
| Quadro CVPixel | Um CVPixelBuffer | Decodificação VideoToolbox no macOS |
| Quadro OpenCV | Uma cv::Mat | Algoritmos que leem os pixels diretamente |
As camadas de cima recebem uma única interface de quadro e, quando precisam de outra forma, simplesmente pedem; quem escolhe a ponte de menor custo naquela máquina é o motor. Algumas decisões de projeto evitam que tudo desmorone no terceiro fabricante de GPU:
- Os tipos são definidos na compilação. Uma consulta entre interfaces é uma conversão estática, não informação de tipo em tempo de execução, então nada se choca nas fronteiras entre DLLs.
- Só quadros que possuem recursos de GPU têm operações de GPU. Clonar, converter e exportar para uma matriz pertencem aos tipos de quadro concretos, não à interface comum.
- A posse é explícita. Quem aloca libera, e handles compartilhados não são liberados duas vezes. Quando um dispositivo de GPU é recriado, os recursos de interoperabilidade que dependem dele são invalidados e recriados junto, para que nenhuma textura do dispositivo anterior fique presa ao novo.
Windows: decodificação e codificação por hardware em três fabricantes de GPU
No Windows, o KwaFlux instala oito plug-ins de decodificação de vídeo e seis de codificação, cada um em sua própria DLL. Depois do demux, o seletor segue a configuração; no automático, ele dá nota a cada candidato, tenta primeiro o de nota mais alta e passa ao próximo se a inicialização falhar. A decodificação por software segura tudo o que sobrar.
| Plug-in de decodificação | Quadro que produz | Codecs |
|---|---|---|
| NVDEC da NVIDIA | Quadro CUDA, NV12 de 8 bits ou P016 de 10 bits | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D11VA (decodificação por hardware do sistema) | Textura NV12 D3D11 | H.264, HEVC, VP9, AV1, MPEG-2 |
| D3D12VA | Recurso D3D12 | H.264, HEVC, VP9, AV1 |
| Intel oneVPL (GPUs Intel atuais) | Textura D3D11 | H.264, HEVC, VP9, AV1, MJPEG |
| Intel Media SDK (gráficos integrados do Core da 5.ª à 10.ª geração) | Textura D3D11 | H.264, HEVC, MPEG-2, MJPEG |
| AMF da AMD | Textura D3D11, encapsulada diretamente em uma superfície AMF | H.264, HEVC, VP9, AV1, MPEG-2 |
| Vulkan Video | Imagem Vulkan | H.264, HEVC |
| Decodificação por software do FFmpeg | Quadro na memória do sistema | Tudo o que o FFmpeg lê, inclusive VP8 e VP9 com canal alfa |
A tabela mostra o que cada plug-in suporta; se a sua GPU consegue decodificar um codec por hardware depende da geração dela. Pela matriz de suporte da NVIDIA, por exemplo, as placas de consumo decodificam AV1 por hardware a partir da série RTX 30.
O que a nota leva em conta. O fabricante errado sai na hora: em uma GPU que não é NVIDIA, o NVDEC não ganha ponto nenhum. Os decodificadores por hardware perdem pontos quando a memória da GPU está apertada e, com uma CPU forte, a decodificação por software pode vencer, para não deixar a máquina pesada só para dizer que usou hardware. O 4K dá pontos ao hardware, porque é justamente aí que as unidades de função fixa devem trabalhar. Se a exibição passa pelo D3D11, o D3D11VA ganha pontos, e decodificar em uma GPU diferente da que controla a tela tira pontos, porque cópias entre GPUs são penalizadas.
Codificação: o codificador recebe o que o decodificador entregou.
| Plug-in de codificação | Entrada preferida | Codecs de saída |
|---|---|---|
| NVENC da NVIDIA | Quadros CUDA; também aceita quadros D3D11, D3D12, Vulkan, OpenGL e da memória do sistema | H.264, HEVC, AV1 |
| Intel oneVPL | Texturas D3D11 da mesma GPU, copiadas na GPU | H.264, HEVC, AV1, VP9, MJPEG |
| AMF da AMD | Texturas D3D11 encapsuladas diretamente em superfícies AMF, com pacotes retirados de forma assíncrona | H.264, HEVC, AV1 |
| Intel Media SDK | Texturas D3D11 ou quadros da memória do sistema | H.264, HEVC, MPEG-2, MJPEG |
| Vulkan Video | Quadros Vulkan | H.264, HEVC |
| Codificação por software do FFmpeg | Quadros da memória do sistema | O que os codificadores por software suportarem |
O NVENC é onde fica mais claro por que o adaptador de quadros importa: ele não exige que todo quadro vire CUDA antes. Um quadro CUDA faz uma cópia 2D dentro do dispositivo; um D3D11 passa pela interoperabilidade; o D3D12 passa pelo D3D11 até o CUDA; o Vulkan usa memória externa, e o OpenGL uma ponte por buffer de pixels. Só um quadro que já estava na memória do sistema é enviado uma vez. Em HEVC e AV1, os dados de masterização HDR e de luz do conteúdo vão na configuração do codificador; o H.264 não tem um campo nativo para eles, então o próprio plug-in os grava em SEI.
Observação: pela matriz de suporte da NVIDIA, as placas GeForce com codificador aceitam no máximo 12 sessões de codificação simultâneas. Quando elas acabam, o plug-in NVENC do KwaFlux sai de cena e passa o trabalho ao próximo codificador, em vez de falhar no meio da exportação.
Os plug-ins têm verificação de versão e não são carregados se ela não bater, e a detecção de capacidades consegue dar nota a um plug-in sem carregá-lo. Uma nova geração de GPU significa adicionar um plug-in; o player e o conversor acima dele não mudam.
A escada de cinco degraus: levar uma textura D3D11 ao OpenGL
O decodificador e a API de exibição muitas vezes não batem: a NVIDIA decodifica em CUDA ou D3D11 enquanto a imagem precisa chegar ao OpenGL, e a Intel decodifica em D3D11 enquanto um filtro roda sobre uma textura OpenGL. O núcleo gráfico do KwaFlux constrói a ponte, e entre D3D11 e OpenGL é uma escada de cinco degraus, subida até onde a máquina deixar:
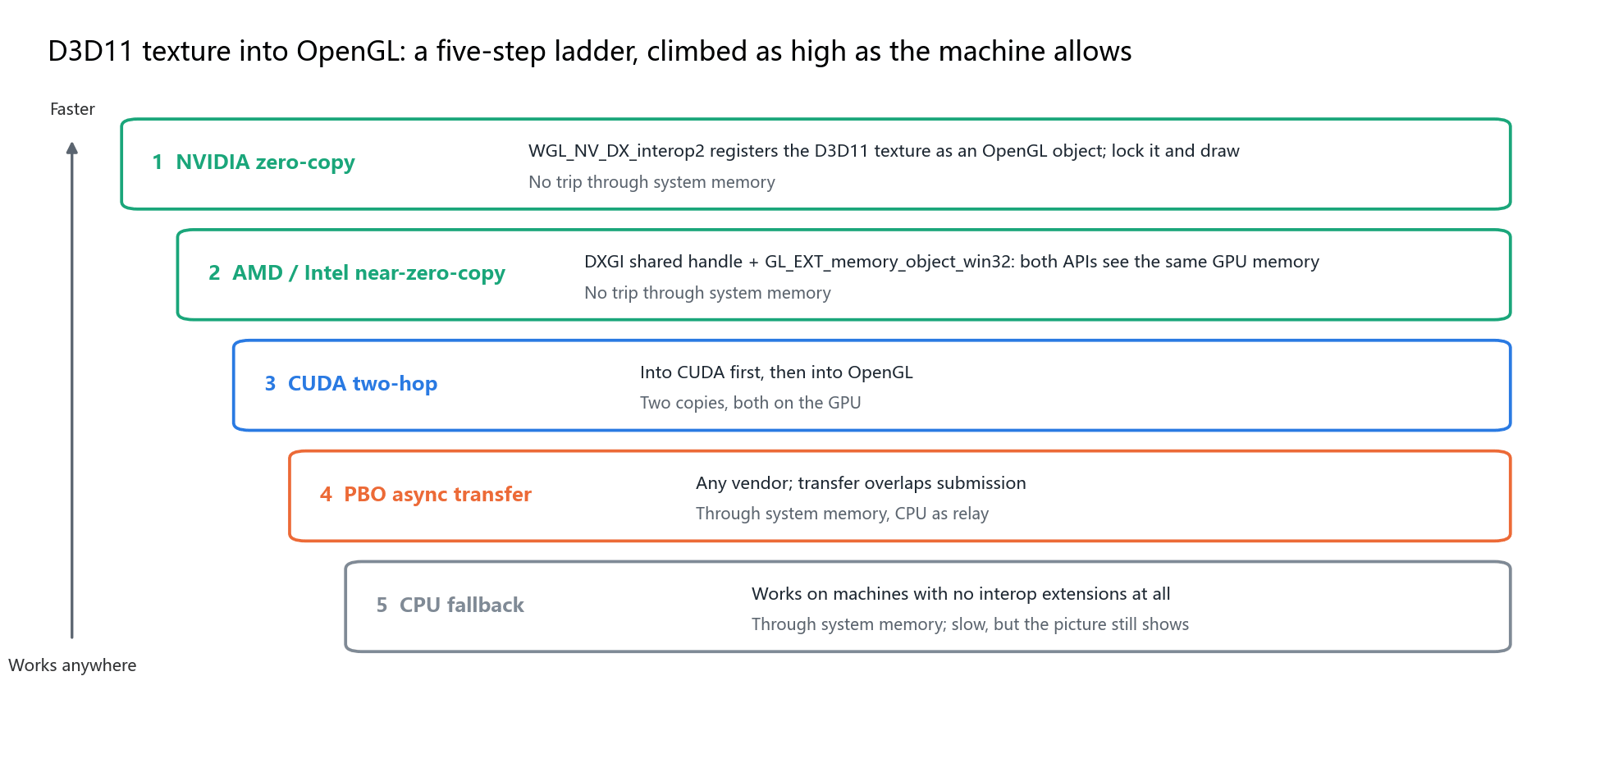
- Sem cópia na NVIDIA. A extensão
WGL_NV_DX_interop2registra uma textura D3D11 como objeto OpenGL; depois de bloqueada, o OpenGL lê e grava nela diretamente, sem passar pela memória do sistema. - Quase sem cópia na AMD e na Intel. Um handle compartilhado DXGI e a extensão
GL_EXT_memory_object_win32fazem as duas APIs enxergarem a mesma memória de GPU. - Desvio pelo CUDA. Primeiro para o CUDA, depois para o OpenGL; as duas cópias acontecem na GPU.
- Transferência assíncrona com pixel buffer objects (PBO). Funciona com qualquer fabricante; a transferência se sobrepõe ao envio de comandos, e a CPU só faz a intermediação.
- Plano B na CPU. Em uma máquina sem nenhuma extensão de interoperabilidade, a imagem chega mesmo assim, só que mais devagar.
Ao lado da escada há pontes dedicadas. CUDA e D3D11 se registram mutuamente. D3D12 e D3D11 compartilham recursos por um handle compartilhado DXGI com sincronização por fence, então o D3D12 não precisa de uma ponte direta com cada uma das outras APIs. Vulkan e D3D11 usam memória externa. Os kernels CUDA de conversão de cor são compilados na biblioteca, de modo que NV12 e P016 viram BGRA na GPU, e imagens de 10 bits podem continuar em RGBA de 16 bits em vez de serem cortadas para 8 bits logo na entrada.
Mac: VideoToolbox decodifica, Metal exibe
No macOS, a disputa não é pelo tamanho da lista de plug-ins. A Apple colocou a codificação e a decodificação no motor de mídia dos seus chips, e o KwaFlux liga esse motor à mesma linguagem de quadros:
- A decodificação passa pelo VideoToolbox, que entrega um
CVPixelBufferencapsulado como quadro CVPixel. Ela cobre H.264, HEVC, VP9 e ProRes. - A codificação usa
h264_videotoolbox,hevc_videotoolboxeprores_videotoolbox, então as exportações ProRes também passam pelo VideoToolbox. - A exibição passa pelo Metal. O
CAMetalLayerverifica se a tela suporta faixa dinâmica estendida (EDR): se suportar, o HDR é exibido via EDR; se não, a mesma matemática de tone mapping do Windows leva o PQ ou o HLG para SDR.
Para o player, os efeitos e a conversão, uma textura D3D11 no Windows e um CVPixelBuffer no Mac são simplesmente "um quadro", então os recursos não se dividem em duas bases de código conforme o sistema.
O player: o áudio marca o tempo e o HDR muda a cada quadro
O áudio é o relógio mestre. O ouvido tolera oscilações muito menos que o olho, então a imagem segue o som, e não o contrário. Entre as chamadas de áudio, o relógio é interpolado linearmente pelo horário do sistema e suavizado por uma média móvel exponencial, e os limites são proporcionais ao intervalo entre quadros, não a um número fixo de milissegundos. Cada quadro recebe uma de três decisões: esperar, desenhar ou descartar. O que vai fora é um quadro atrasado, não a sua posição no vídeo.
Pular para outro ponto é uma transação. A decodificação é interrompida, os quadros vencidos são descartados, um número de geração barra os quadros antigos e o relógio é zerado; o relógio de áudio só volta a andar quando a imagem da nova posição é de fato desenhada. O que você vê é o ponto para onde pulou, não o último segundo que ainda estava na fila.
O HDR não é ligado para o arquivo inteiro de uma vez. Cada quadro é avaliado pela sua própria característica de transferência: só PQ e HLG pedem uma swap chain HDR, e, se o trecho seguinte for SDR, a swap chain volta atrás, para que uma imagem comum não seja tratada como sinal PQ e fique acinzentada. O HLG é convertido para PQ em um shader antes de ir para a tela.
| Backend de exibição | Uso | Tratamento do HDR |
|---|---|---|
| D3D11 | Caminho principal no Windows | Swap chain de 10 bits com PQ e BT.2020 repassados direto; levado a SDR em um shader em telas sem HDR |
| Vulkan | Caminho gráfico moderno | Superfície HDR10, de 10 bits ou meia precisão |
| Metal | macOS | Faixa dinâmica estendida com CAMetalLayer, mesmo tone mapping |
| OpenGL | Caminho comum a todas as plataformas | Sem repasse direto de HDR; leva o HDR a SDR |
HDR em uma tela comum. Os quatro backends compartilham um único tone mapper: o PQ ou o HLG é convertido em luminância real em nits, passado para IPT, processado por tabelas de tons e de gamut e entregue como BT.709 e sRGB. A tabela de tons acompanha o pico da imagem, medido em um alvo minúsculo fora da tela e lido de volta sem travar a GPU, com suavização nas trocas de cena. Quando um arquivo não informa a luminância de masterização, o mapper parte de 1.000 nits em vez de uma constante que deixe tudo bonito. Legendas que vão do sRGB para uma swap chain HDR sobem até o branco de referência PQ, para que o texto branco não fique cinza em cenas claras.
A reprodução comparativa separa o original e a imagem processada em dois pipelines, e cada lado do divisor guarda o próprio histórico de brilho, então uma cena noturna à esquerda não escurece a luz do dia à direita. Durante a reprodução, as tarefas em segundo plano cedem sua parte da GPU e a retomam aos poucos quando você para: a reprodução em tempo real vem primeiro, as exportações entram na fila.
libplacebo: escala, tone mapping e remoção de banding
O libplacebo é a biblioteca de qualidade de imagem em GPU que saiu do player mpv. O KwaFlux a integra como nó de efeito e escolhe o backend de acordo com o quadro que chega: quadros OpenGL, decodificados por software, CUDA e CVPixel passam pelo OpenGL; o NV12 do D3D11 vai direto para o backend D3D11, o que poupa uma ida e volta de cor; quadros Vulkan ficam no Vulkan.
- Para ampliar, usa EWA Lanczos; para reduzir, Lanczos; e bilinear quando a velocidade importa.
- Para passar de HDR para SDR, dá para escolher entre as curvas BT.2390, Reinhard, Spline e Hable, com o pico medido na imagem.
- A remoção de banding, o dithering e o anti-ringing evitam que os degradês do céu virem faixas.
- O desentrelaçamento usa uma janela temporal com o quadro anterior, o atual e o seguinte, em vez de adivinhar cada quadro sozinho.
- Há dois presets, Rápido e Alta qualidade: Rápido para prévias e escala antes da codificação, Alta qualidade para a renderização final.
As correções automáticas (rotação, proporção do pixel, entrelaçamento, posição da crominância) e a escala antes da codificação ficam primeiro com o libplacebo. Quando um upscale muda a resolução, o nó de escala continua antes do codificador, que recebe o tamanho de destino. Se o libplacebo não iniciar, os filtros scale, zscale e yadif do FFmpeg assumem, e a falta de um módulo não interrompe o trabalho.
O caminho ideal de um pixel em uma exportação
Juntando as peças, uma exportação no Windows funciona assim:
- O arquivo é demultiplexado em pacotes, e o seletor escolhe o decodificador por hardware certo para aquela máquina.
- Os quadros nascem como ponteiros CUDA ou texturas D3D11, não como um bloco alocado na memória do sistema.
- Rotação, correção de proporção, desentrelaçamento ou tone mapping para uma versão SDR são feitos pelo libplacebo na GPU.
- Os modelos de IA (upscale, Reparo de qualidade, SDR para HDR e outros) processam cada quadro na GPU; o tipo do quadro pode mudar no caminho sem que o trabalho precise saber por qual ponte passou.
- Se a resolução tiver de bater com um destino, acontece mais uma escala rápida.
- Cada codificador recebe os quadros do seu jeito: o NVENC recebe CUDA, e o oneVPL e o AMF recebem D3D11.
- Os pacotes entram no multiplexador, os timestamps são ordenados e o arquivo é gravado.
Em uma frase: a decodificação por hardware deixa uma textura, a interoperabilidade a mostra para outra API, o processamento de imagem fica na GPU e o codificador por hardware lê seus quadros da mesma memória de GPU. A memória do sistema só aparece quando a máquina não tem uma ponte mais alta ou quando uma etapa realmente precisa ler os pixels na CPU. É um plano B, não o centro do projeto.
No Mac, é a mesma frase em outro dialeto: o VideoToolbox decodifica no motor de mídia, os quadros entram no pipeline como CVPixelBuffer, o Metal leva o HDR à tela via EDR, e as exportações ProRes e HEVC voltam para o VideoToolbox.
As exportações em paralelo por segmentos dividem a timeline em trechos, e cada trecho segue este mesmo pipeline, não um atalho que pula o processamento de cor para ganhar velocidade.
O que você pode ajustar no KwaFlux
Quase tudo é automático. Estes ajustes mudam o funcionamento:
- Decodificação acelerada por hardware (Configurações › Desempenho): Automático (padrão), Ativado ou Desativado. Se um arquivo decodificar com falhas ou erros, mude para Desativado para investigar com decodificação por software. A mudança vale depois de reiniciar o app.
- Processador de IA (Configurações › Desempenho): se o processamento de IA usa a GPU ou se o app decide. A GPU costuma ser mais rápida; a escolha vale a partir da próxima exportação, prévia ou geração de máscara.
- Uso de recursos na exportação com IA: Carga baixa (um só fluxo e, em máquinas com várias GPUs, só uma), Equilibrado (padrão), Velocidade total ou Personalizado (quais GPUs usar e quantos fluxos cada uma roda). Baixar o nível vale na hora para uma exportação em andamento, sem perder os segmentos já concluídos.
Problemas comuns
| Problema | Causa provável | Solução |
|---|---|---|
| Um arquivo aparece na prévia com falhas ou verde | O decodificador por hardware daquela GPU não suporta direito aquela variante do codec | Mudar Decodificação acelerada por hardware para Desativado e reiniciar para decodificar por software |
| Trechos SDR ficam cinzentos na reprodução HDR | O player não troca o modo de exibição a cada quadro, ou as tags do arquivo estão erradas | Conferir com o ffprobe a característica de transferência de cada trecho |
| CPU muito ocupada e GPU parada durante a exportação | O caminho desceu para um degrau que passa pela memória do sistema, ou um filtro só roda na CPU | Atualizar o driver da GPU; ver se algum ajuste só é processado na CPU |
| A NVIDIA avisa que há sessões demais em exportações paralelas | Mais sessões de codificação do que o driver permite | Rodar menos trabalhos em paralelo ou pôr o uso de recursos em Carga baixa ou Equilibrado |
| Exportações lentas em notebook com duas GPUs | A decodificação e a exibição estão em GPUs diferentes, gerando cópias entre elas | Atribuir a GPU dedicada ao KwaFlux nas configurações gráficas do sistema |
O que esta arquitetura não consegue fazer
- Andar sem cópia em todos os caminhos. Os degraus 4 e 5 da escada passam pela memória do sistema, e GPUs antigas ou drivers sem extensões de interoperabilidade acabam ali.
- Reproduzir Dolby Vision. No HDR, o que se sustenta é o HDR10 estático e o HLG.
- Oferecer no Mac uma interoperabilidade tão ampla quanto no Windows. Os pontos fortes do Mac são VideoToolbox, ProRes, quadros CVPixel e o EDR do Metal, não tantas pontes quanto no Windows.
- Prometer um fator de aceleração. Quanto uma exportação ganha com menos cópias depende da GPU, do driver, da resolução e das etapas de processamento; faça prévias e meça com o seu próprio material.
Conclusão
Um pipeline todo na GPU não é um slogan, e sim uma tabela de rotas que sabe descer degraus. Máquinas rápidas mantêm os pixels na GPU do começo ao fim, e as mais lentas descem um degrau de cada vez e terminam o trabalho mesmo assim. Na próxima exportação, dê uma olhada na carga da GPU e da CPU: você vai saber por qual caminho seus pixels passaram.
Teste no seu próprio material
O KwaFlux executa a Conversão de formato e todas as ferramentas de IA na sua própria GPU, mantendo a decodificação, o processamento e a codificação na placa de vídeo o máximo possível. O processamento de IA roda na sua própria GPU e os seus arquivos de mídia não são enviados para processamento. Roda no Windows 10 (64 bits, versão 1809 ou mais recente), no Windows 11 e no macOS 12 ou mais recente em Apple Silicon. As prévias não exigem conta: renderize uma prévia de 1, 3 ou 5 segundos de qualquer clipe. O login com um plano pago só é necessário para exportar, converter, reparar um arquivo ou baixar um arquivo de um link.
Teste no seu próprio material
Baixe o KwaFlux e veja os efeitos de graça no seu próprio material antes de pagar — sem conta, processado na sua GPU, sem enviar sua mídia. As prévias de vídeo duram 1, 3 ou 5 segundos; as de estabilização, 5, 15 ou 30 segundos.
Perguntas frequentes
O que quer dizer "sem cópia" na GPU?
Quer dizer que dois componentes compartilham a mesma memória e passam o acesso adiante em vez de copiar os pixels. A extensão WGL_NV_DX_interop2 da NVIDIA, por exemplo, registra uma textura D3D11 como objeto OpenGL e, depois de bloqueada, o OpenGL lê e grava nela sem passar pela memória do sistema.
Uma segunda GPU deixa as exportações mais rápidas?
Às vezes. Uma segunda placa ajuda quando o software divide a timeline em segmentos e os processa em paralelo nas duas GPUs. Ela não acelera um fluxo único, e decodificar em uma placa enquanto a outra exibe acrescenta cópias entre GPUs, que custam tempo em vez de economizar.
Quantas codificações por hardware uma placa NVIDIA de consumo roda ao mesmo tempo?
Até 12, segundo a matriz atual da NVIDIA para placas GeForce com codificador; a maioria das placas profissionais e de data center não tem limite. Uma codificação nova acima do limite falha, então leve isso em conta ao exportar vários arquivos em paralelo.
A decodificação por hardware é melhor que a decodificação por software?
Não necessariamente. Com pouca memória de GPU, um codec muito novo ou parâmetros de arquivo incomuns, a decodificação por hardware pode falhar ou estragar a imagem, e com uma CPU forte a decodificação por software não é lenta. O sensato é um projeto que mantenha as duas, escolha conforme o caso e volte para o software quando o hardware não conseguir decodificar.
Por que minha exportação continua lenta com a aceleração por hardware ligada?
Em geral, porque o gargalo não é a decodificação. A inferência de IA, os filtros e a codificação também levam tempo, e qualquer etapa que volte para a memória do sistema faz o pipeline esperar pelas cópias. Veja qual parte está esperando: GPU pouco ocupada com CPU muito ocupada costuma significar que alguma coisa voltou para a CPU. Veja processamento de vídeo com IA local ou na nuvem.
Fontes
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (acessado em 2026-10-22)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (acessado em 2026-10-22)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (acessado em 2026-10-22)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (acessado em 2026-10-22)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (acessado em 2026-10-22)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (acessado em 2026-10-22)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (acessado em 2026-10-22)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (acessado em 2026-10-22)
KwMais em Por dentro do KwaFlux
Continue lendo

KwaFlux: tudo o que você precisa saber (recursos, plataformas, preços e atualizações)
O que é o KwaFlux, o que ele inclui, em quais sistemas roda, o que é grátis e o que é pago, como funcionam as licenças e o que mudou em cada versão.
KwaFlux no Mac: Macs compatíveis, instalação e dicas de desempenho
Quais Macs rodam o KwaFlux, como instalar, o que significam o componente de aceleração por GPU e o modo padrão e como manter a IA rápida no Apple Silicon.
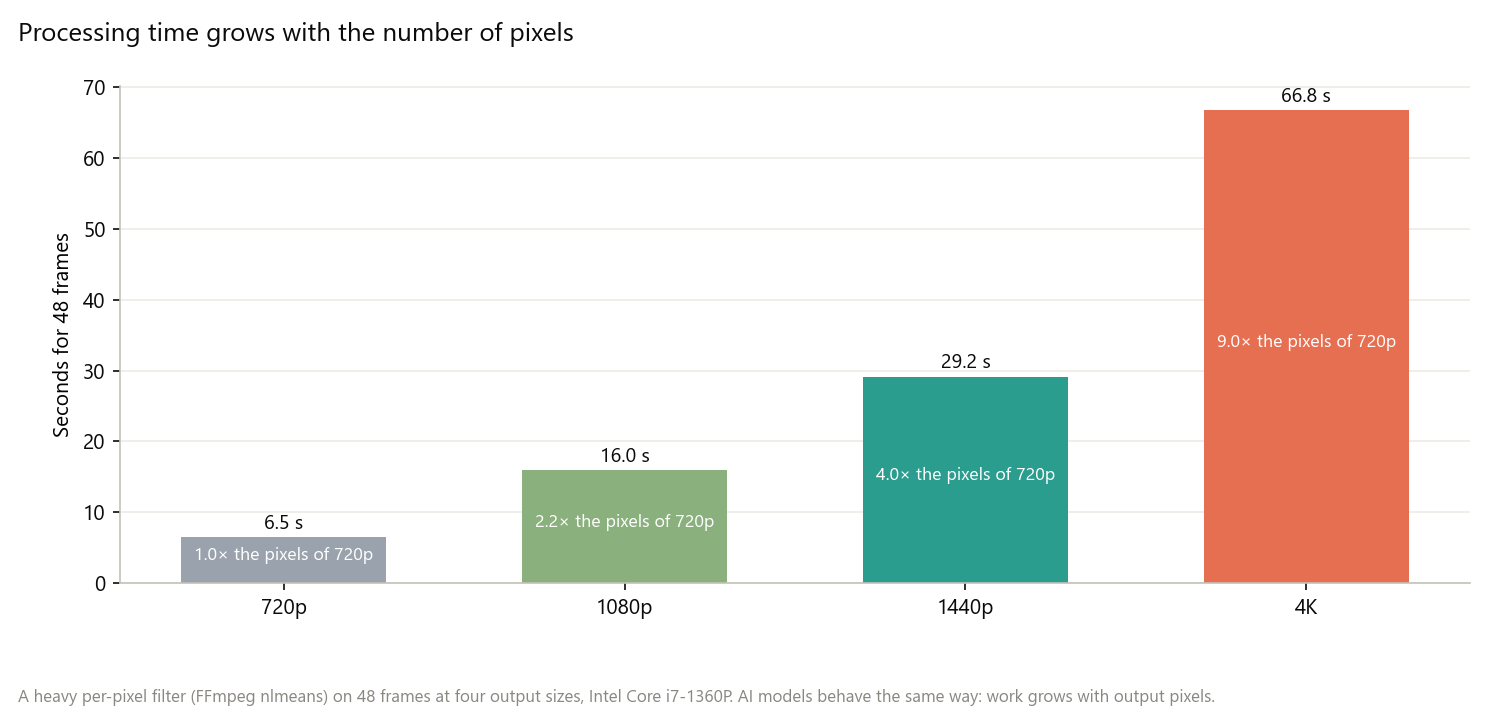
Como deixar a melhoria de vídeo com IA mais rápida: fluxo de trabalho, configurações e hardware
Por que melhorar vídeo com IA é lento e como acelerar: processe menos, escolha o tamanho de saída, ordene as etapas e use bem a GPU e o app.