一帧不必回家:KwaFlux 怎样让视频从解码到编码都留在显卡里
一帧 4K 10 位视频约 24.9 MB,每在内存和显存之间搬一次都要时间。KwaFlux 用帧适配器、三家显卡的硬件编解码和五级互通阶梯,尽量让像素不离开显卡。
要点速览
全流程 GPU 视频处理,是指一段视频从解码、画面处理、AI 推理到编码,像素尽量一直留在显存里,不在系统内存和显卡之间来回搬运。搬得越少,导出越快,预览越流畅,CPU 也越闲。
本文讲 KwaFlux 的媒体引擎是怎样做到这件事的:帧适配器怎样让九种帧类型说同一种语言,Windows 上三家显卡的硬件编解码怎样打分选人,D3D11 和 OpenGL 之间的五级互通阶梯,Mac 上的 VideoToolbox 和 Metal,以及播放器怎样把 HDR 送到屏幕上。最后是一次导出里像素的完整行程,和在 KwaFlux 里能调的几个开关。
- 一帧 4K、10 位、4:2:0 的视频约 24.9 MB,60 帧每秒时,每在系统内存和显存之间搬一趟,就是每秒约 1.5 GB 的数据。搬的次数越多,导出越慢、预览越卡。
- KwaFlux 的媒体引擎给每一帧发一张“身份证”:CUDA 指针、D3D11 纹理、Metal 纹理还是系统内存,上层只认“一帧”,换 API 时由引擎挑开销最小的桥。
- Windows 上,NVIDIA、Intel、AMD 和系统级 D3D11、D3D12 的硬件解码与编码都以插件形式随包安装,按显卡、显存和分辨率打分,选不上就换下一个,软件解码兜底。
- D3D11 纹理进 OpenGL 有五级阶梯:NVIDIA 零拷贝、AMD 与 Intel 近零拷贝、CUDA 两跳、异步传输、CPU 兜底。快的机器走上面,老机器走下面,画面都不断。
- 它不是“每条路径都零拷贝”:阶梯的后两级要经过系统内存。全流程 GPU 的意思是尽量留在显卡,留不住时逐级退回,而不是直接失败。
为什么像素“回家”很贵?
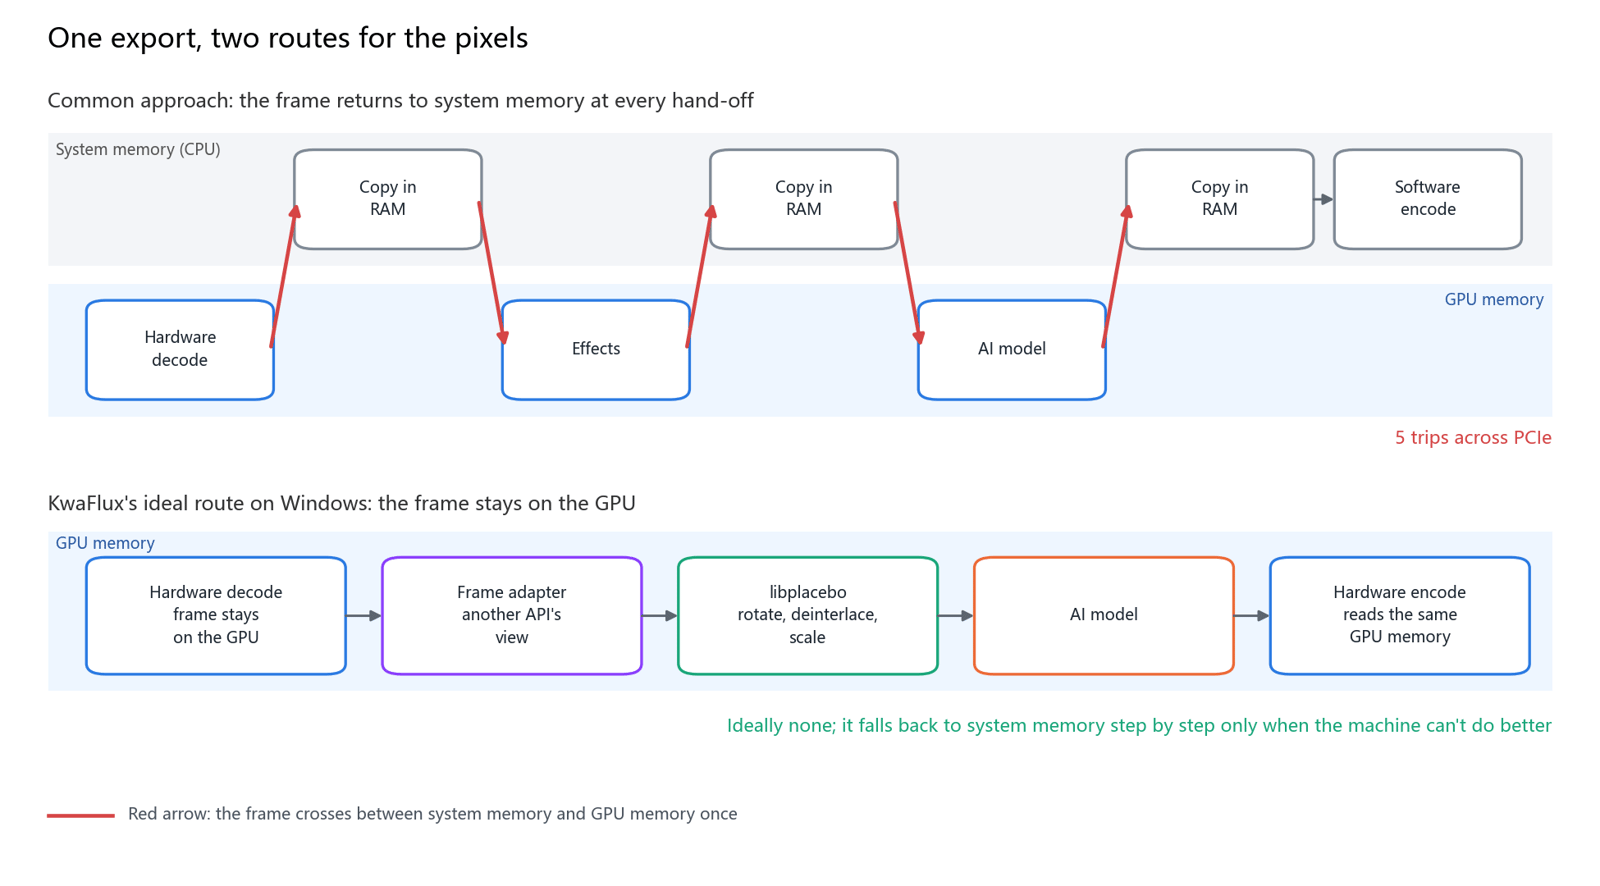
像素“回家”,指的是一帧画面从显存拷回系统内存,处理完再传回显卡。硬件解码器把画面解在显存里,AI 模型和画质滤镜也在显卡上跑,硬件编码器同样从显存取帧;中间只要有一个环节只认系统内存里的像素,这一帧就得跨 PCIe 走一个来回。
先算一下一帧有多大(4:2:0 采样时,色度只占亮度的一半):
| 格式 | 一帧大小 | 30 帧每秒,每搬一趟 | 60 帧每秒,每搬一趟 |
|---|---|---|---|
| 1080p,8 位 NV12 | 每帧 3.1 MB | 每秒 93 MB | 每秒 187 MB |
| 4K,8 位 NV12 | 每帧 12.4 MB | 每秒 373 MB | 每秒 746 MB |
| 4K,10 位 P010 | 每帧 24.9 MB | 每秒 746 MB | 每秒 1.49 GB |
| 4K,RGBA 半精度浮点(AI 和 HDR 处理常用) | 每帧 66.4 MB | 每秒 1.99 GB | 每秒 3.98 GB |
PCIe 4.0 x16 每个方向的理论带宽约 31.5 GB/s。看上去够用,但这只是理论峰值,搬运还要等 GPU 把手上的活做完、等驱动完成同步,CPU 也得参与调度。下图上半部分是常见的做法:解码、特效、AI 处理、编码各认各的内存,一次导出里同一帧要跨 PCIe 五次;4K 10 位、60 帧每秒的素材,光搬运就是每秒约 7.5 GB。
帧适配器:九种帧身份,上层只认一帧
帧适配器是 KwaFlux 媒体引擎里的一层接口,它让同一帧画面无论实际存在哪种显存里,对播放器、特效和编码器来说都只是“一帧”。媒体软件天生是方言区:FFmpeg 说 AVFrame,NVIDIA 说 CUDA 设备指针,Intel 和 AMD 的硬件解码交出 D3D11 纹理,Vulkan 说 VkImage,Apple 说 CVPixelBuffer。每一种的生命周期、内存对齐和颜色布局都不一样。
| 帧的身份 | 实际存放在哪里 | 谁会交出这种帧 |
|---|---|---|
| FFmpeg 帧 | 系统内存里的 AVFrame | 软件解码,以及所有兜底路径 |
| D3D11 帧 | ID3D11Texture2D 纹理 | Windows 上 D3D11VA、Intel、AMD 的硬件解码 |
| D3D12 帧 | D3D12 资源 | D3D12 视频解码 |
| CUDA 帧 | CUDA 设备指针 | NVIDIA 的 NVDEC 解码,NVENC 编码的原生输入 |
| OpenGL 帧 | 纹理或帧缓冲对象 | 滤镜、预览和跨平台渲染 |
| Vulkan 帧 | VkImage 图像 | Vulkan 视频解码和渲染 |
| Metal 帧 | MTLTexture 纹理 | macOS 上屏和 HDR 显示 |
| CVPixel 帧 | CVPixelBuffer 缓冲 | macOS 的 VideoToolbox 解码 |
| OpenCV 帧 | cv::Mat 矩阵 | 需要直接读像素的算法 |
上层业务只拿到一个统一的帧接口,需要另一种身份时说一句“转成我要的那种”,由引擎去挑这台机器上开销最小的桥。几个设计细节决定了它在三家显卡上不散架:
- 类型在编译期就定死。 跨接口查询是一次静态转换,不依赖运行时类型信息,在动态库边界上不会互相打架。
- 只有真正拥有显存资源的帧,才带 GPU 操作。 克隆、转换、导出成矩阵这些动作挂在具体的帧类型上,不堆在公共接口里。
- 所有权写清楚。 谁分配谁释放,共享句柄不会重复释放。显卡设备重建时,依赖它的互通资源一起失效、一起重建,不会出现上一块显卡的纹理还挂在下一块显卡上的情况。
Windows:三家显卡的硬件解码与编码
在 Windows 上,KwaFlux 随包安装了八个视频解码插件和六个视频编码插件,每个都是独立的动态库。解封装之后,选择器按配置走;设成自动时,它给每个候选插件打分,分高的先上,初始化失败就换下一个,软件解码总能接住。
| 解码插件 | 交出的帧 | 支持的编码 |
|---|---|---|
| NVIDIA 的 NVDEC | CUDA 帧,8 位 NV12 或 10 位 P016 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| D3D11VA(系统硬解) | D3D11 NV12 纹理 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| D3D12VA 硬件解码 | D3D12 资源 | H.264、HEVC、VP9 和 AV1 |
| Intel oneVPL(新一代 Intel 显卡) | D3D11 纹理 | H.264、HEVC、VP9、AV1 和 MJPEG |
| Intel Media SDK(5 到 10 代酷睿的核显) | D3D11 纹理 | H.264、HEVC、MPEG-2 和 MJPEG |
| AMD 的 AMF | D3D11 纹理,可直接包成 AMF 表面 | H.264、HEVC、VP9、AV1 和 MPEG-2 |
| Vulkan 视频接口 | Vulkan 图像 | H.264 和 HEVC |
| FFmpeg 软件解码 | 系统内存帧 | FFmpeg 支持的全部格式,包括带透明通道的 VP8、VP9 |
表里是插件本身支持的编码;你的显卡能不能硬解某种编码,还要看显卡的代际。比如 NVIDIA 的支持表显示,消费级显卡从 RTX 30 系列开始才能硬解 AV1。
打分看什么。 厂商不对就直接出局:不是 NVIDIA 的显卡,NVDEC 得 0 分。显存紧张时硬件解码的分数会降,CPU 足够强时软件解码可以反超,不会为了“必须硬解”把机器拖死。4K 给硬件解码加分,那正是固定功能单元该上班的时候。打算用 D3D11 显示画面,D3D11VA 就加分;解码和显示放在同一块显卡上更合适,跨卡拷贝在评分里是扣分项。
编码:解码交什么,编码就吃什么。
| 编码插件 | 最顺手的输入 | 输出编码 |
|---|---|---|
| NVIDIA 的 NVENC | CUDA 帧;D3D11、D3D12、Vulkan、OpenGL、系统内存帧也都能接 | H.264、HEVC 和 AV1 |
| Intel 的 oneVPL | 同一块显卡上的 D3D11 纹理,直接在显卡上拷贝 | H.264、HEVC、AV1、VP9 和 MJPEG |
| AMD 的 AMF | D3D11 纹理直接包成 AMF 表面,异步出包 | H.264、HEVC 和 AV1 |
| Intel 的 Media SDK | D3D11 纹理或系统内存帧 | H.264、HEVC、MPEG-2 和 MJPEG |
| Vulkan 视频接口 | Vulkan 帧 | H.264 和 HEVC |
| FFmpeg 软件编码 | 系统内存帧 | 软件编码器支持的格式 |
NVENC 这一路最能说明帧适配器的价值:它不要求所有帧先变成 CUDA。CUDA 帧在显卡内部做二维拷贝;D3D11 帧走互通;D3D12 先经 D3D11 再进 CUDA;Vulkan 走外部内存;OpenGL 走像素缓冲桥;只有本来就在系统内存里的帧,才上传一次。HEVC 和 AV1 的 HDR 母版信息和内容亮度写进编码器配置,H.264 没有原生字段,就由程序写入 SEI。
补充: NVIDIA 的支持表列出,带编码器的 GeForce 显卡最多同时开 12 路编码会话。KwaFlux 在会话数到顶时让 NVENC 插件主动退出,把活交给下一个编码器,而不是编码到一半才报错。
插件按版本号校验,不匹配就不加载;能力探测不需要把插件真正拉起来就能打分。换一代显卡,加一个插件,上层的播放器和转换器不用改。
五级阶梯:D3D11 纹理怎样进 OpenGL
解码出来的帧和显示用的图形接口经常不是一家:NVIDIA 解在 CUDA 或 D3D11,画面要进 OpenGL;Intel 解在 D3D11,滤镜在 OpenGL 纹理上跑。KwaFlux 的图形核心负责在中间搭桥,D3D11 和 OpenGL 之间是一条五级阶梯,能走多高走多高:
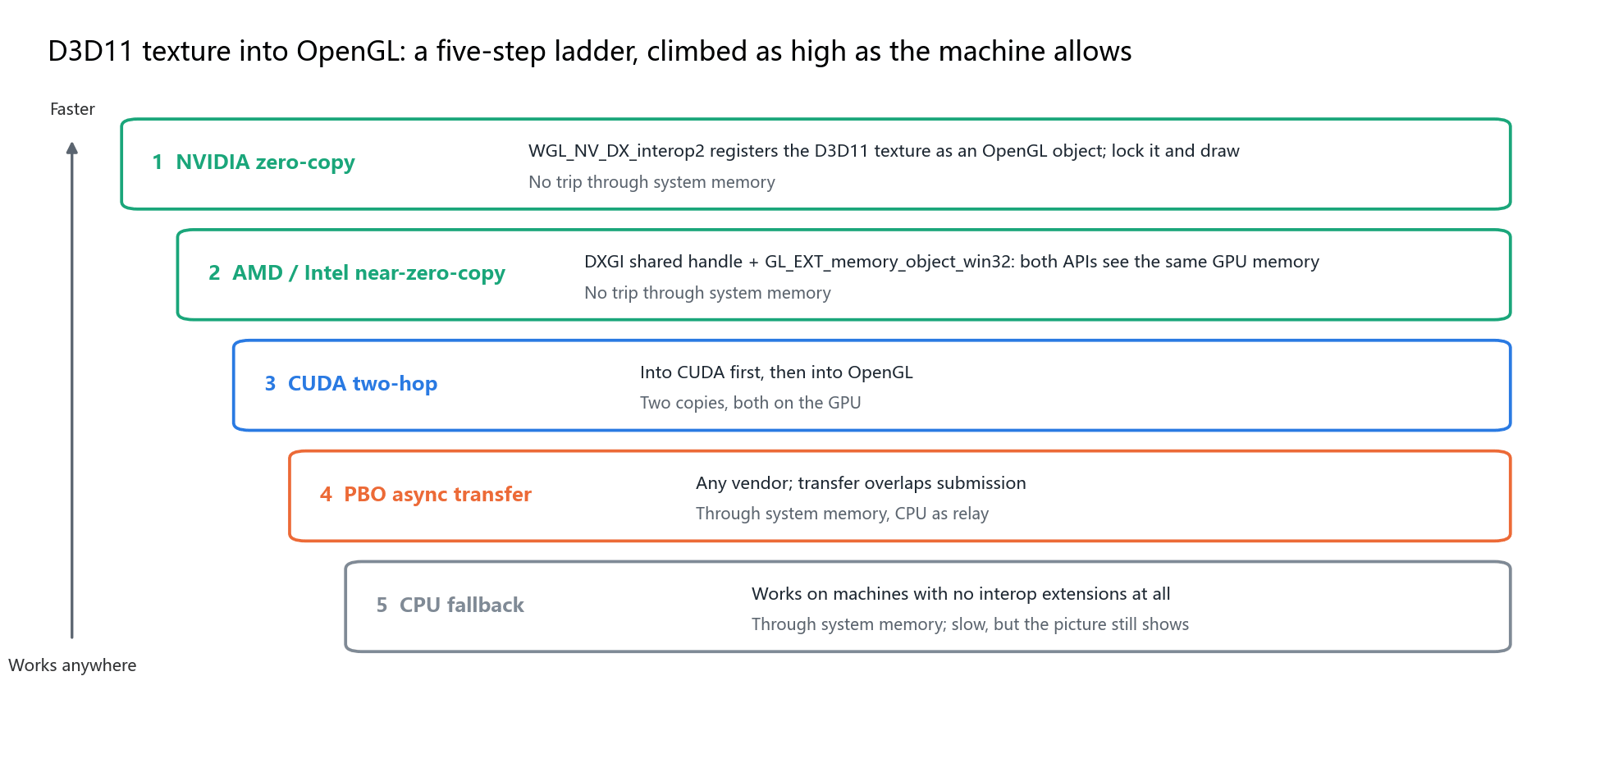
- NVIDIA 零拷贝。
WGL_NV_DX_interop2扩展把 D3D11 纹理登记成 OpenGL 对象,锁定之后 OpenGL 直接读写,像素不经过系统内存。 - AMD 和 Intel 近零拷贝。 DXGI 共享句柄加上
GL_EXT_memory_object_win32扩展,两套接口看的是同一块显存。 - CUDA 两跳。 先进 CUDA,再进 OpenGL,两次拷贝都在显卡上。
- 像素缓冲对象(PBO)异步传输。 不挑厂商,传输和提交重叠进行,CPU 只当中转站。
- CPU 兜底。 什么扩展都没有的机器,画面依然能出来,只是慢。
阶梯之外还有几座专用桥:CUDA 和 D3D11 互相注册;D3D12 和 D3D11 通过 DXGI 共享句柄加围栏同步,D3D12 因此不必给每种接口各写一条直连;Vulkan 和 D3D11 走外部内存。CUDA 侧的颜色转换核函数直接编译进库里,NV12、P016 转 BGRA 在显卡上完成,10 位画面可以保持在 16 位的 RGBA 里,不会在门口被砍成 8 位。
Mac:VideoToolbox 解码,Metal 上屏
macOS 上不比插件表有多长。Apple 把编解码做进了芯片的媒体引擎,KwaFlux 把这台引擎接进同一套帧语言:
- 解码 走 VideoToolbox,交出
CVPixelBuffer,包成 CVPixel 帧。支持 H.264、HEVC、VP9,以及 ProRes。 - 编码 走
h264_videotoolbox、hevc_videotoolbox和prores_videotoolbox,ProRes 导出同样交给 VideoToolbox。 - 上屏 走 Metal。
CAMetalLayer先看显示器支不支持扩展动态范围(EDR):支持,HDR 走 EDR 直接显示;不支持,用和 Windows 同一套数学的色调映射把 PQ 或 HLG 映射成 SDR。
对播放器、特效和转换管线来说,Windows 上的 D3D11 纹理和 Mac 上的 CVPixelBuffer 都只是“一帧”,产品功能不用按操作系统写两套。
播放器:音频当时钟,HDR 按帧切换
同步以音频为主时钟。 人耳对声音抖动的容忍度远低于眼睛对画面的容忍度,所以画面追声音,不让声音追画面。时钟在两次音频回调之间按系统时间线性插值,再用指数滑动平均抹平抖动;判断阈值跟帧间隔成比例,而不是写死一个毫秒数。每一帧只有三种决定:等、画、丢。丢掉的是来不及显示的帧,不是你的播放进度。
拖动进度条是一次完整的事务。 打断解码,清空过期的帧队列,用代数号把旧帧挡在门外,时钟复位,直到新位置的第一帧真正画出来,音频时钟才重新开始计时。你看到的是目标位置,不是队列里还没清掉的上一秒。
HDR 不是检测到就整段打开。 每一帧看自己的传递特性:PQ 和 HLG 才申请 HDR 交换链,接下来一段突然是 SDR,交换链就退回去,SDR 画面不会被误当成 PQ 信号而显示发灰。HLG 在着色器里转成 PQ 再交给显示器。
| 显示后端 | 用在哪里 | HDR 怎么处理 |
|---|---|---|
| D3D11 接口 | Windows 的主路径 | 10 位交换链,PQ 与 BT.2020 直通;显示器不支持 HDR 时在着色器里映射成 SDR |
| Vulkan 接口 | 现代图形路径 | HDR10 表面,10 位或半精度浮点 |
| Metal 接口 | macOS 系统 | CAMetalLayer 扩展动态范围,同一套色调映射 |
| OpenGL 接口 | 全平台通用 | 不做 HDR 直通,负责把 HDR 映射成 SDR |
普通显示器上的 HDR。 四个后端共用同一套色调映射:PQ 或 HLG 先换算成以尼特计的实际亮度,转到 IPT 色彩空间,查色调表和色域表,再落到 BT.709 和 sRGB。色调表跟着画面峰值走,峰值用一张很小的离屏图测量,读回结果不等待显卡,场景切换时平滑过渡。片子没写母版亮度时,按 1,000 尼特起步,而不是拍一个好看的常数。字幕从 sRGB 进 HDR 交换链时会抬到 PQ 的参考白,白字不会在亮画面里发灰。
对比播放把原画和处理后的画面分成两路,分割线两边各自记录亮度历史:左边是夜景,也不会把右边的日景映射得变暗。播放时后台任务会让出 GPU 资源,停下来再慢慢收回,实时画面优先,导出排队。
libplacebo:缩放、色调映射和去色带
libplacebo 是从 mpv 播放器拆出来的 GPU 画质库。KwaFlux 把它接成一个特效节点,输入是什么帧就选哪个后端:OpenGL 帧、软件解码帧、CUDA 帧和 CVPixel 帧走 OpenGL;D3D11 的 NV12 直接走 D3D11 后端,少一次颜色往返;Vulkan 帧留在 Vulkan。
- 放大用 EWA Lanczos,缩小用 Lanczos,要快可以换成双线性;
- HDR 转 SDR 可选 BT.2390、Reinhard、Spline、Hable 曲线,峰值可以跟着画面测;
- 去色带、抖动、抗振铃,渐变的天空不再一条一条;
- 去隔行用前一帧、当前帧和后一帧组成的时间窗口,而不是每帧单独猜;
- 预设分快速和高质量两档:预览和编码前的缩放用快速,成片用高质量。
自动校正(旋转、像素宽高比、隔行、色度位置)和编码前缩放优先交给 libplacebo;超分改变了分辨率时,缩放节点仍然排在编码之前,编码器拿到的是目标尺寸。libplacebo 起不来,就退到 FFmpeg 的 scale、zscale 和 yadif 滤镜,画面不会因为某个模块缺席而拒绝处理。
一次导出里,像素的理想行程
把上面几段接起来,Windows 上的一次导出是这样的:
- 文件解封装成数据包,选择器挑中这台机器上合适的硬件解码器;
- 帧以 CUDA 指针、D3D11 纹理的身份出生,而不是先在系统内存里分配一块;
- 需要旋转、校正宽高比、去隔行,或者交付 SDR 版本要做色调映射时,libplacebo 在显卡上完成;
- AI 模型(超分、画质修复、SDR 转 HDR 等)在显卡上逐帧处理,帧的类型可以变,业务不用知道它中途换过桥;
- 分辨率要对齐目标时,再做一次快速缩放;
- 编码器按自己的习惯接帧:NVENC 接 CUDA,oneVPL 和 AMF 接 D3D11;
- 数据包进入封装器(复用器),时间戳排好,文件落地。
用一句话说:硬解留下纹理,互通让另一套接口直接访问它,画质处理留在显卡,硬编直接从同一块显存读取画面、输出码流。系统内存出现,只是因为这台机器没有更高一级的桥,或者某一步算法确实要读 CPU 上的像素。它是降级,不是设计的中心。
Mac 上是同一句话的另一种说法:VideoToolbox 在媒体引擎里解码,帧以 CVPixelBuffer 进入管线,Metal 用 EDR 把 HDR 送到屏幕上,ProRes 和 HEVC 的导出回到 VideoToolbox。
多段并行导出会把时间轴切成几段,每一段走的还是这条管线,而不是另写一套“为了快所以跳过色彩处理”的捷径。
在 KwaFlux 里能调什么
大多数时候这些都是自动的,下面几个设置会影响它怎么走:
- 硬件加速解码(设置 › 性能):可选自动(默认)、启用和禁用。遇到某个文件解码花屏或报错时,改成禁用,用软件解码排查。改动在重启应用后生效。
- AI 处理器(设置 › 性能):选择 AI 处理用 GPU 还是交给应用自动决定。GPU 通常更快,下次导出、预览或生成蒙版时生效。
- AI 导出资源占用:低占用(只跑一路,多显卡时只用其中一张)、均衡(默认)、全速,以及自定义(指定用哪几张显卡、每张显卡最多跑几路)。调小立刻作用到正在导出的任务,已完成的切片不会丢。
问题排查
| 问题 | 可能原因 | 解决办法 |
|---|---|---|
| 某个文件预览花屏、绿屏 | 这块显卡的硬件解码器对这种编码支持不完整 | 在设置里把硬件加速解码改成禁用,重启后改用软件解码 |
| 播放 HDR 时 SDR 片段发灰 | 播放器没有按帧切换显示模式,或文件标签不对 | 用 ffprobe 检查各段的传递特性标签 |
| 导出时 CPU 占用高、显卡很闲 | 当前路径退到了经过系统内存的那几级,或某个滤镜只能在 CPU 上跑 | 更新显卡驱动;检查是否用了只能在 CPU 上处理的设置 |
| 多路导出时 NVIDIA 编码报会话数不足 | 同时运行的编码会话超过了驱动上限 | 减少并行任务,或把资源占用调到低占用或均衡 |
| 双显卡笔记本导出慢 | 解码和显示不在同一块显卡上,产生跨卡拷贝 | 在系统的图形设置里让 KwaFlux 使用独立显卡 |
这套架构做不到的事
- 不是每条路径都零拷贝。 五级阶梯的第 4、5 级要经过系统内存,老显卡和缺少互通扩展的驱动会走到这里。
- 不还原杜比视界。 HDR 部分站得住的是静态 HDR10 和 HLG。
- Mac 上不是和 Windows 同等的全互通。 Mac 上的优势是 VideoToolbox、ProRes、CVPixel 帧和 Metal EDR,而不是和 Windows 一样多的互通桥。
- 不报没测过的倍数。 搬运次数少了会快多少,取决于你的显卡、驱动、分辨率和处理步骤,请用自己的素材预览和实测。
结语
全流程 GPU 不是一句口号,而是一张能降级的路由表:快的机器让像素一路留在显卡里,慢的机器也能逐级退回去把活干完。下次导出时看一眼显卡和 CPU 的占用,就知道你的像素走的是哪条路。
用你自己的真实素材实测效果
KwaFlux 在你自己的 GPU 上运行视频转换和全部 AI 工具,解码、处理和编码尽量都在显卡上完成。AI 处理在你自己的 GPU 上运行,媒体文件不会为了处理而上传。可在 Windows 10(64 位,1809 或更新版本)、Windows 11,以及搭载 Apple Silicon 的 macOS 12 或更新版本上运行。预览不需要账号:任意片段都能渲染 1、3 或 5 秒的预览。仅在导出、转换、文件修复和从链接下载文件时需要登录并购买付费方案。
用你自己的真实素材实测效果
下载 KwaFlux,付费前先在自己的素材上免费预览效果——无需注册,在你的 GPU 上处理,媒体文件不上传。 视频预览可选 1、3或5 秒;防抖预览可选 5、15或30 秒。
常见问题
零拷贝是什么意思?
零拷贝是指两个模块共享同一块内存,交接数据时只交出访问权限,不复制像素。比如 NVIDIA 的 WGL_NV_DX_interop2 扩展能把 D3D11 纹理直接登记成 OpenGL 对象,OpenGL 锁定后就能读写,画面不经过系统内存。
加一块显卡,导出会更快吗?
可能会。软件把时间轴切成几段、分给两块显卡并行处理时,第二块显卡才派得上用场。单路处理用不上它;如果一块显卡解码、另一块负责显示,还会多出跨卡拷贝,反而更费时间。
消费级 NVIDIA 显卡能同时开几路硬件编码?
按 NVIDIA 当前的支持表,带编码器的 GeForce 显卡最多同时开 12 路编码会话,专业卡和数据中心卡多数不限。会话数到顶后再开新的编码任务会失败,所以多路并行导出要留意这个上限。
硬件解码比软件解码好吗?
未必。显存紧张、编码格式太新或文件参数特殊时,硬件解码可能失败或花屏;CPU 足够强时,软件解码的速度也不差。合理的做法是两者都保留,按情况选择,解不了就退回软件解码。
为什么开了硬件加速,导出还是很慢?
通常是因为瓶颈不在解码。AI 推理、滤镜和编码同样占时间,任何一步回到系统内存都会让流水线停下来等搬运。先看哪一步在等:显卡占用低、CPU 占用高,多半是有环节退回了 CPU。见本地与云端 AI 视频处理。
参考资料
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (2026-10-22 查阅)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (2026-10-22 查阅)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (2026-10-22 查阅)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (2026-10-22 查阅)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (2026-10-22 查阅)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (2026-10-22 查阅)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (2026-10-22 查阅)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (2026-10-22 查阅)
KwKwaFlux 内外 的更多文章