フレームを家に帰さない:KwaFlux がデコードからエンコードまで映像を GPU に留める仕組み
4K 10 ビットのフレームは約 24.9 MB。RAM と GPU を往復するたびに時間がかかります。KwaFlux が画素を GPU に留める仕組みを解説します。
要点
全工程 GPU の動画処理とは、デコード、画像処理、AI 推論、エンコードまで、画素をできるだけ GPU メモリに置いたまま処理し、システムメモリとの間で行き来させないことです。コピーが少ないほど書き出しは速く、プレビューはなめらかになり、CPU にも余裕が生まれます。
この記事では、KwaFlux のメディアエンジンがそれをどう実現しているかを解説します。9 種類のフレーム形式に共通の言葉を話させるフレームアダプター、3 社の GPU のハードウェアデコーダーとエンコーダーを採点して選ぶ仕組み、D3D11 と OpenGL の間の 5 段階の相互運用、Mac の VideoToolbox と Metal、プレーヤーが HDR を画面に届ける方法です。最後に、1 回の書き出しで画素がたどる道のりと、KwaFlux で変更できる設定を紹介します。
- 4K・10 ビット・4:2:0 のフレームは約 24.9 MB です。60 fps では、システムメモリと GPU メモリの間を 1 往復させるごとに毎秒約 1.5 GB が動きます。往復が増えるほど書き出しは遅く、プレビューは重くなります。
- KwaFlux のメディアエンジンは、フレームごとに「身分証」を発行します。CUDA ポインタ、D3D11 テクスチャ、Metal テクスチャ、システムメモリのどれであっても、上位層からは「1 枚のフレーム」にしか見えず、別の API が必要になればエンジンがいちばん負担の少ない橋を選びます。
- Windows では、NVIDIA、Intel、AMD、そして OS 標準の D3D11・D3D12 のハードウェアデコードとエンコードがプラグインとして同梱されています。GPU、メモリ、解像度で採点し、失敗すれば次の候補に移り、最後はソフトウェアデコードが受け止めます。
- D3D11 テクスチャを OpenGL に渡す方法は 5 段階あります。NVIDIA のコピーなしの共有、AMD と Intel のほぼコピーなしの共有、CUDA 経由の 2 段転送、非同期転送、CPU によるフォールバックです。速いマシンは上の段、古いマシンは下の段を使い、どちらでも映像は途切れません。
- すべての経路がコピーなしの共有というわけではありません。下の 2 段はシステムメモリを経由します。全工程 GPU とは、できる限り GPU に留め、無理なら段階的に下りることで、失敗して止まることではありません。
画素を「家に帰す」となぜ高くつくのか
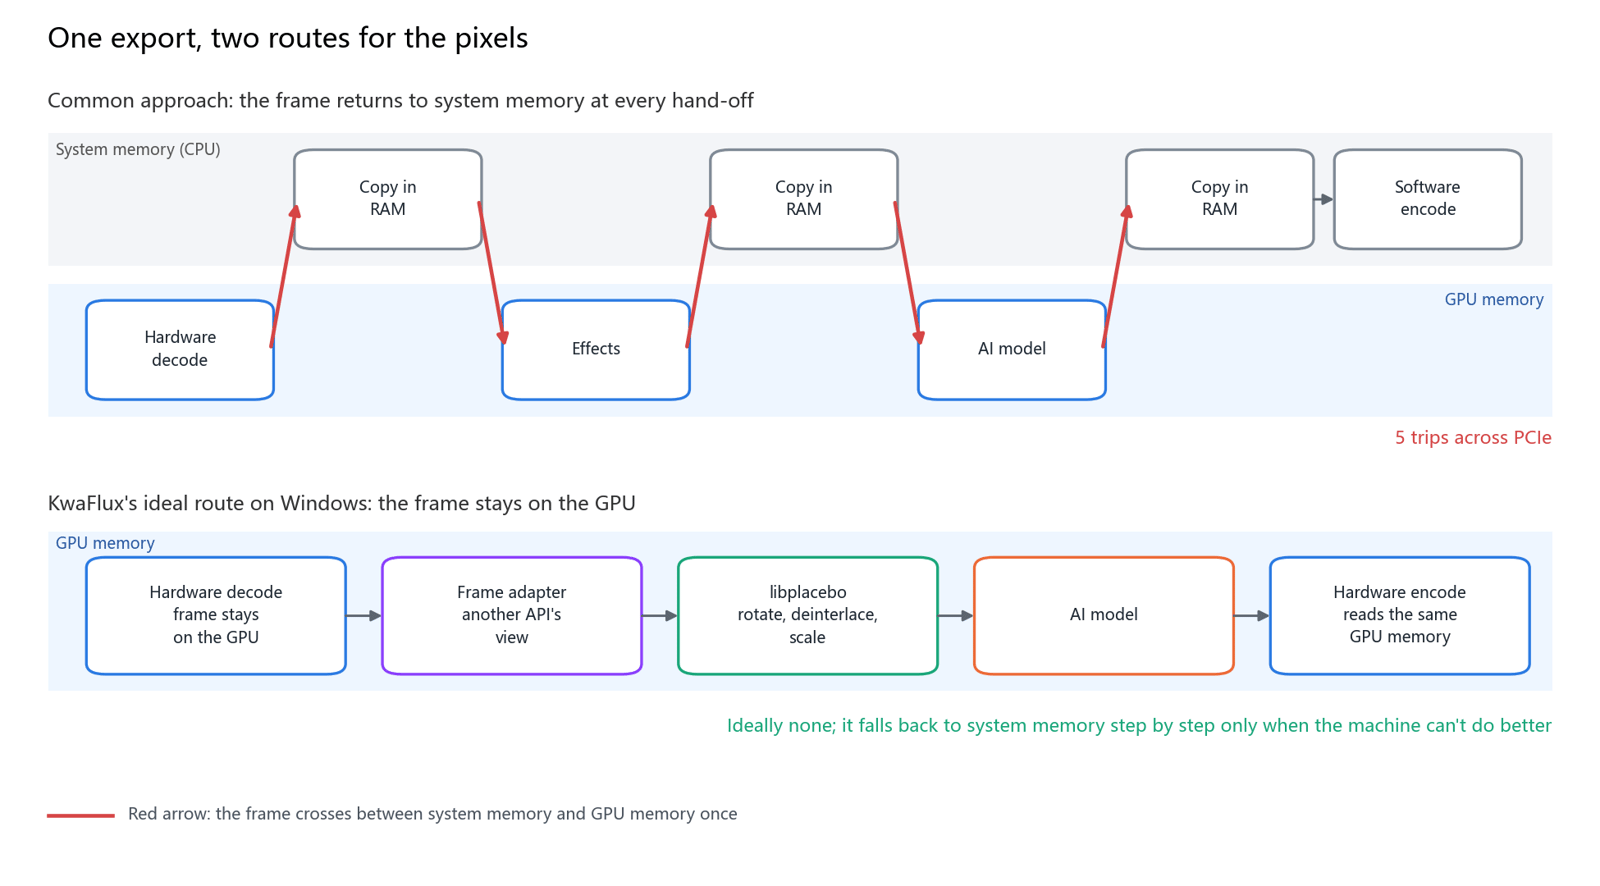
画素が家に帰るとは、フレームを GPU メモリからシステムメモリにコピーし、処理してから GPU に戻すことです。ハードウェアデコーダーは GPU メモリに画を書き出し、AI モデルや画質フィルターも GPU で動き、ハードウェアエンコーダーも GPU メモリから読み込みます。途中に 1 つでもシステムメモリ上の画素しか受け付けない工程があると、そのフレームは PCIe を往復しなければなりません。
まず 1 フレームの大きさを計算します(4:2:0 では、色差として輝度の半分のサイズが加わります)。
| 形式 | 1 フレーム | 30 fps で 1 往路あたり | 60 fps で 1 往路あたり |
|---|---|---|---|
| 1080p、8 ビット NV12 | 1 フレーム 3.1 MB | 毎秒 93 MB | 毎秒 187 MB |
| 4K、8 ビット NV12 | 1 フレーム 12.4 MB | 毎秒 373 MB | 毎秒 746 MB |
| 4K、10 ビット P010 | 1 フレーム 24.9 MB | 毎秒 746 MB | 毎秒 1.49 GB |
| 4K、RGBA 半精度浮動小数点(AI や HDR の処理でよく使う形式) | 1 フレーム 66.4 MB | 毎秒 1.99 GB | 毎秒 3.98 GB |
PCIe 4.0 x16 の理論帯域は片方向で約 31.5 GB/s です。十分に見えますが、これはあくまでピークです。コピーのたびに GPU が手元の作業を終えるのを待ち、ドライバーの同期を待ち、CPU も段取りに関わります。下の図の上半分は一般的なやり方で、デコード、エフェクト、AI、エンコードがそれぞれ自分のメモリを求めるため、1 回の書き出しで同じフレームが PCIe を 5 回渡ります。4K 10 ビット 60 fps なら、コピーだけで毎秒約 7.5 GB になります。
フレームアダプター:9 種類のフレーム形式、1 つの共通フレーム
フレームアダプターは KwaFlux のメディアエンジンの中にある層で、フレームが実際にどのメモリにあっても、プレーヤー、エフェクト、エンコーダーからは同じ「1 枚のフレーム」に見えるようにします。メディアソフトの世界は方言だらけです。FFmpeg は AVFrame、NVIDIA は CUDA のデバイスポインタ、Intel と AMD のハードウェアデコーダーは D3D11 テクスチャ、Vulkan は VkImage、Apple は CVPixelBuffer を話します。どれも寿命、アラインメント、色の並びが違います。
| フレームの種類 | 置かれている場所 | 生み出すもの |
|---|---|---|
| FFmpeg フレーム | システムメモリ上の AVFrame | ソフトウェアデコードと、すべてのフォールバック経路 |
| D3D11 フレーム | ID3D11Texture2D テクスチャ | Windows の D3D11VA、Intel、AMD のハードウェアデコード |
| D3D12 フレーム | D3D12 リソース | D3D12 の動画デコード |
| CUDA フレーム | CUDA デバイスポインタ | NVIDIA の NVDEC デコード。NVENC のネイティブ入力 |
| OpenGL フレーム | テクスチャまたはフレームバッファオブジェクト | フィルター、プレビュー、クロスプラットフォーム描画 |
| Vulkan フレーム | VkImage イメージ | Vulkan の動画デコードと描画 |
| Metal フレーム | MTLTexture テクスチャ | macOS での表示と HDR |
| CVPixel フレーム | CVPixelBuffer バッファ | macOS の VideoToolbox デコード |
| OpenCV フレーム | cv::Mat 行列 | 画素を直接読むアルゴリズム |
上位層は 1 つのフレームインターフェースだけを受け取り、別の種類が必要になれば「この形にして」と頼むだけです。そのマシンでいちばん負担の少ない橋はエンジンが選びます。GPU メーカーが 3 社に増えても破綻しないよう、いくつかの設計上の工夫があります。
- 型はコンパイル時に決まります。 インターフェースをまたぐ問い合わせは静的な変換 1 回で済み、実行時型情報に頼らないため、DLL の境界で衝突しません。
- GPU 操作を持つのは、GPU リソースを実際に持つフレームだけです。 複製、変換、行列への書き出しといった操作は個々のフレーム型に付いていて、共通インターフェースには積み上げていません。
- 所有権がはっきりしています。 確保した側が解放し、共有ハンドルを二重に解放することはありません。GPU デバイスを作り直すときは、それに依存する相互運用リソースも一緒に無効化して作り直すので、前の GPU のテクスチャが次の GPU に残ることはありません。
Windows:3 社の GPU のハードウェアデコードとエンコード
Windows 版の KwaFlux には、動画デコーダーのプラグインが 8 個、動画エンコーダーのプラグインが 6 個同梱されており、それぞれ独立した DLL です。デマックスの後、セレクターは設定に従って選び、自動のときはすべての候補を採点して点数の高いものから試し、初期化に失敗すれば次に移ります。残ったケースはソフトウェアデコードが受け止めます。
| デコーダープラグイン | 出力するフレーム | 対応コーデック |
|---|---|---|
| NVIDIA の NVDEC | CUDA フレーム(8 ビット NV12 または 10 ビット P016) | H.264、HEVC、VP9、AV1、MPEG-2 に対応 |
| D3D11VA(OS 標準のハードウェアデコード) | D3D11 の NV12 テクスチャ | H.264、HEVC、VP9、AV1、MPEG-2 に対応 |
| D3D12VA のハードウェアデコード | D3D12 リソース | H.264、HEVC、VP9、AV1 に対応 |
| Intel oneVPL(現行の Intel GPU) | D3D11 テクスチャ | H.264、HEVC、VP9、AV1、MJPEG に対応 |
| Intel Media SDK(第 5〜第 10 世代 Core の内蔵 GPU) | D3D11 テクスチャ | H.264、HEVC、MPEG-2、MJPEG に対応 |
| AMD の AMF | D3D11 テクスチャ。そのまま AMF サーフェスに包める | H.264、HEVC、VP9、AV1、MPEG-2 に対応 |
| Vulkan の動画 API | Vulkan イメージ | H.264、HEVC に対応 |
| FFmpeg のソフトウェアデコード | システムメモリ上のフレーム | FFmpeg が読める形式すべて(アルファ付きの VP8、VP9 も含む) |
表はプラグインそのものの対応範囲です。お使いの GPU があるコーデックをハードウェアでデコードできるかは、GPU の世代によります。たとえば NVIDIA の対応表では、コンシューマー向けカードの AV1 ハードウェアデコードは RTX 30 シリーズからです。
採点で見るもの。 メーカーが違えばその場で除外され、NVIDIA 以外の GPU では NVDEC は 0 点です。GPU メモリが逼迫するとハードウェアデコードは減点され、CPU が十分に強ければソフトウェアデコードが上回ることもあるので、ハードウェアデコードにこだわってマシンを重くすることはありません。4K ではハードウェアに加点します。固定機能ユニットの出番はまさにそこです。D3D11 で表示するなら D3D11VA に加点し、デコードと表示が別の GPU になると GPU 間コピーが発生するので減点します。
エンコード:デコーダーが出したものをそのまま受け取る。
| エンコーダープラグイン | 得意な入力 | 出力コーデック |
|---|---|---|
| NVIDIA の NVENC | CUDA フレーム。D3D11、D3D12、Vulkan、OpenGL、システムメモリのフレームも受け付ける | H.264、HEVC、AV1 に対応 |
| Intel の oneVPL | 同じ GPU 上の D3D11 テクスチャを GPU 内でコピー | H.264、HEVC、AV1、VP9、MJPEG に対応 |
| AMD の AMF | D3D11 テクスチャをそのまま AMF サーフェスに包み、パケットを非同期で取り出す | H.264、HEVC、AV1 に対応 |
| Intel の Media SDK | D3D11 テクスチャまたはシステムメモリのフレーム | H.264、HEVC、MPEG-2、MJPEG に対応 |
| Vulkan の動画 API | Vulkan フレーム | H.264、HEVC に対応 |
| FFmpeg のソフトウェアエンコード | システムメモリ上のフレーム | ソフトウェアエンコーダーが対応する形式 |
フレームアダプターの価値がいちばんよくわかるのが NVENC です。すべてのフレームを先に CUDA にする必要はありません。CUDA フレームはデバイス上で 2D コピー、D3D11 フレームは相互運用、D3D12 は D3D11 を経由して CUDA へ、Vulkan は外部メモリ、OpenGL はピクセルバッファの橋渡しを使います。最初からシステムメモリにあるフレームだけが 1 回アップロードされます。HEVC と AV1 では HDR のマスタリング情報とコンテンツの明るさ情報をエンコーダー設定に書き込み、ネイティブの項目がない H.264 では SEI に独自に書き込みます。
補足: NVIDIA の対応表によると、エンコーダーを持つ GeForce カードの同時エンコードセッションは最大 12 です。セッションが尽きると KwaFlux の NVENC プラグインは自分から身を引き、次のエンコーダーに仕事を渡すので、途中でエラーになって止まるのを避けます。
プラグインにはバージョンチェックがあり、一致しなければ読み込まれません。能力の判定はプラグインを読み込まずに採点できます。新しい世代の GPU が出ればプラグインを足すだけで、上のプレーヤーやコンバーターは変わりません。
5 段階のはしご:D3D11 テクスチャを OpenGL に渡す
デコーダーと表示用 API はしばしば一致しません。NVIDIA は CUDA や D3D11 でデコードするのに画は OpenGL に入れたい、Intel は D3D11 でデコードするのにフィルターは OpenGL テクスチャ上で動く、といった具合です。KwaFlux のグラフィックスコアが橋を架け、D3D11 と OpenGL の間ではマシンが許す限り上の段を使う 5 段階のはしごになっています。
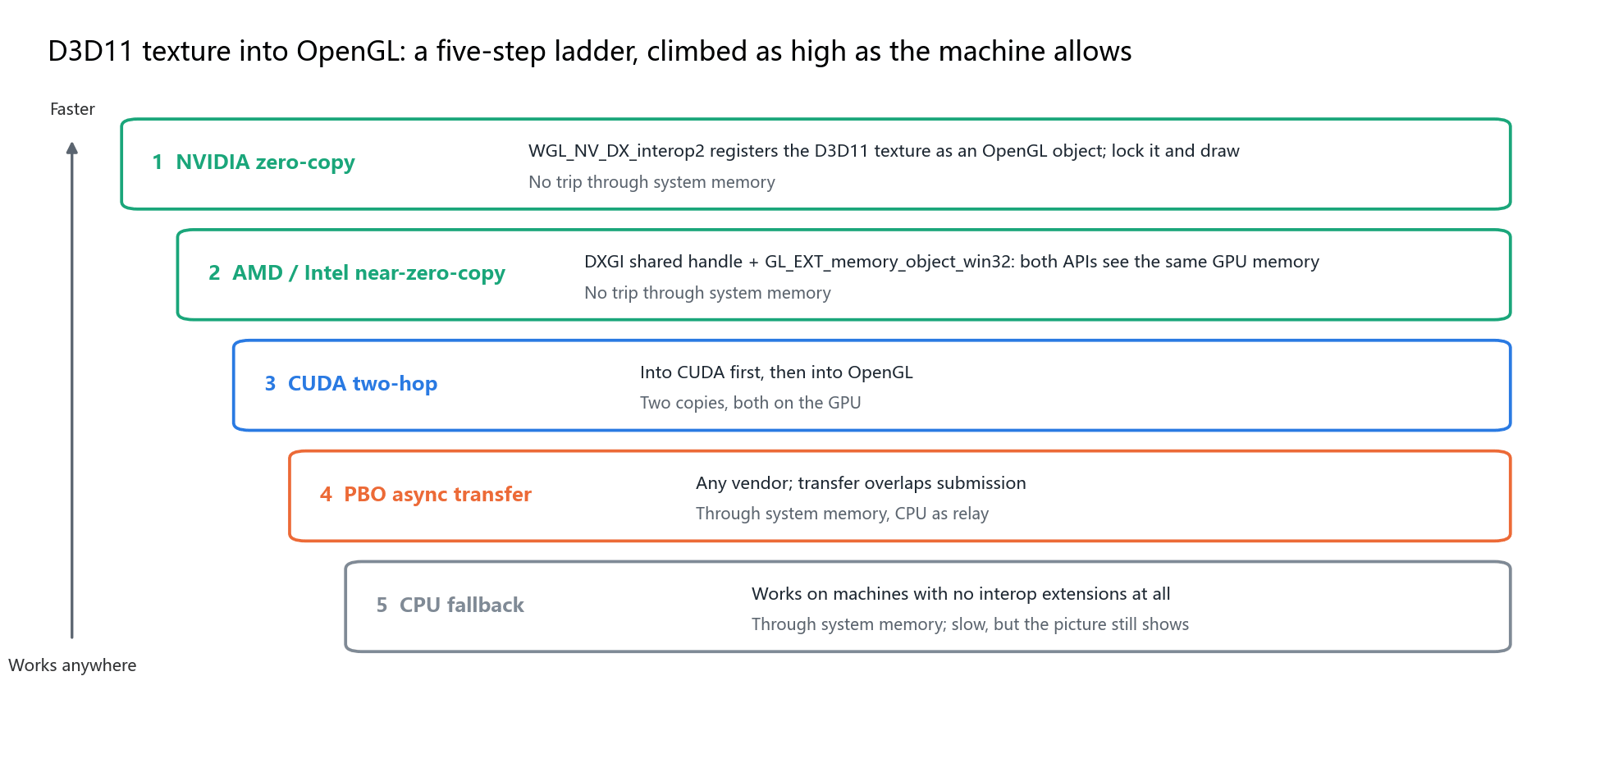
- NVIDIA のコピーなしの共有。
WGL_NV_DX_interop2拡張で D3D11 テクスチャを OpenGL オブジェクトとして登録し、ロックすれば OpenGL がそのまま読み書きします。画素はシステムメモリを通りません。 - AMD と Intel のほぼコピーなしの共有。 DXGI 共有ハンドルと
GL_EXT_memory_object_win32拡張で、2 つの API が同じ GPU メモリを見ます。 - CUDA 経由の 2 段転送。 いったん CUDA に入れてから OpenGL へ。2 回のコピーはどちらも GPU 上です。
- ピクセルバッファオブジェクト(PBO)による非同期転送。 メーカーを選ばず、転送と描画命令の発行を重ねて進めます。CPU は中継するだけです。
- CPU によるフォールバック。 相互運用の拡張がまったくないマシンでも、遅くはなりますが映像は出ます。
はしごのほかに専用の橋もあります。CUDA と D3D11 は互いに登録し合い、D3D12 と D3D11 は DXGI 共有ハンドルとフェンスで同期するので、D3D12 はすべての API への直通路を個別に持つ必要がありません。Vulkan と D3D11 は外部メモリを使います。CUDA 側の色変換カーネルはライブラリに組み込まれており、NV12 や P016 から BGRA への変換は GPU 上で行われ、10 ビットの画は 16 ビット RGBA のまま保持できるので、入口で 8 ビットに切り詰められることはありません。
Mac:VideoToolbox でデコード、Metal で表示
macOS ではプラグインの数を競いません。Apple はチップのメディアエンジンにエンコードとデコードを組み込んでおり、KwaFlux はそのエンジンを同じフレームの言葉につなぎます。
- デコード は VideoToolbox で行い、受け取った
CVPixelBufferを CVPixel フレームとして包みます。H.264、HEVC、VP9、ProRes に対応しています。 - エンコード は
h264_videotoolbox、hevc_videotoolbox、prores_videotoolboxを使い、ProRes の書き出しも VideoToolbox が担当します。 - 表示 は Metal です。
CAMetalLayerがディスプレイの拡張ダイナミックレンジ(EDR)対応を確認し、対応していれば HDR を EDR で表示し、対応していなければ Windows と同じ計算のトーンマッピングで PQ や HLG を SDR に変換します。
プレーヤー、エフェクト、変換処理から見れば、Windows の D3D11 テクスチャも Mac の CVPixelBuffer も同じ「1 枚のフレーム」なので、機能を OS ごとに 2 通り作る必要がありません。
プレーヤー:音声を時計にし、HDR はフレームごとに切り替える
音声をマスタークロックにしています。 人の耳は映像のカクつきよりも音の揺れにずっと敏感なので、画を音に合わせ、音を画に合わせることはしません。時計は音声コールバックの間をシステム時刻で線形補間し、指数移動平均で揺れをならします。判定のしきい値は固定のミリ秒ではなくフレーム間隔に比例させています。各フレームに下す判断は「待つ」「描く」「捨てる」の 3 つだけです。捨てるのは間に合わなかったフレームで、再生位置ではありません。
シークは 1 つのトランザクションとして処理します。 デコードを中断し、古いフレームのキューを空にし、世代番号で古いフレームを締め出し、時計をリセットします。新しい位置の画が実際に描かれてから、音声の時計が再び時を刻み始めます。見えるのはシーク先の画で、キューに残っていた直前の 1 秒ではありません。
HDR はファイル全体で一度に切り替えるわけではありません。 フレームごとに自分の伝達特性を見て、PQ と HLG のときだけ HDR のスワップチェーンを要求します。次の区間が SDR ならスワップチェーンを戻すので、通常の映像が PQ 信号として扱われて灰色になることはありません。HLG はシェーダーで PQ に変換してからディスプレイに渡します。
| 表示バックエンド | 用途 | HDR の扱い |
|---|---|---|
| D3D11 の経路 | Windows のメイン経路 | 10 ビットのスワップチェーンで PQ と BT.2020 をパススルー。HDR 非対応のディスプレイではシェーダーで SDR に変換 |
| Vulkan の経路 | 新しいグラフィックス経路 | HDR10 サーフェス(10 ビットまたは半精度浮動小数点) |
| Metal の経路 | macOS 向け | CAMetalLayer の拡張ダイナミックレンジと共通のトーンマッピング |
| OpenGL の経路 | 全プラットフォーム共通 | HDR のパススルーはせず、HDR を SDR に変換する |
通常のディスプレイでの HDR。 4 つのバックエンドは同じトーンマッパーを共有します。PQ や HLG をまずニト単位の実際の輝度に換算し、IPT 色空間に移してトーンテーブルと色域テーブルを引き、BT.709 と sRGB として出力します。トーンテーブルは画のピークに追従し、ピークはとても小さなオフスクリーン画像で測定して、GPU を止めずに読み戻し、シーンが変わるときはなめらかに移行します。マスタリング輝度が書かれていないファイルでは、見栄えのよい定数を当てずに 1,000 ニトから始めます。sRGB の字幕を HDR のスワップチェーンに入れるときは PQ の基準白まで持ち上げるので、明るい場面で白い文字が灰色にくすみません。
比較再生では元の画と処理後の画を 2 つの処理系に分け、境界線の左右でそれぞれ明るさの履歴を持ちます。左が夜景でも、右の昼間の画が暗くマッピングされることはありません。再生中はバックグラウンドのタスクが GPU を譲り、止めると少しずつ取り戻します。リアルタイムの再生が優先で、書き出しは順番待ちです。
libplacebo:スケーリング、トーンマッピング、デバンド
libplacebo は mpv プレーヤーから切り出された GPU 画質ライブラリです。KwaFlux はこれをエフェクトノードとして組み込み、入ってくるフレームに応じてバックエンドを選びます。OpenGL フレーム、ソフトウェアデコードのフレーム、CUDA フレーム、CVPixel フレームは OpenGL を通り、D3D11 の NV12 は D3D11 バックエンドに直接入って色の往復を 1 回省き、Vulkan フレームは Vulkan のままです。
- 拡大は EWA Lanczos、縮小は Lanczos。速さを優先するならバイリニアに切り替えます。
- HDR から SDR への変換では BT.2390、Reinhard、Spline、Hable のカーブを選べ、ピークは画から測定できます。
- デバンド、ディザリング、リンギング抑制で、グラデーションの空が縞模様になるのを防ぎます。
- インターレース解除は 1 フレームずつ推測するのではなく、前・現在・次のフレームからなる時間窓を使います。
- プリセットは高速と高品質の 2 つ。プレビューとエンコード前のスケーリングは高速、最終書き出しは高品質です。
自動調整(回転、画素アスペクト比、インターレース、色差の位置)とエンコード前のスケーリングは、まず libplacebo に任せます。アップスケールで解像度が変わっても、スケーリングのノードはエンコーダーの前に置かれるので、エンコーダーが受け取るのは目標のサイズです。libplacebo が起動できなければ FFmpeg の scale、zscale、yadif フィルターが引き継ぐので、モジュールが 1 つ欠けても処理は止まりません。
1 回の書き出しで画素がたどる理想の道のり
ここまでをつなげると、Windows での 1 回の書き出しは次のようになります。
- ファイルをパケットにデマックスし、セレクターがそのマシンに合ったハードウェアデコーダーを選びます。
- フレームはシステムメモリに確保されたブロックとしてではなく、CUDA ポインタや D3D11 テクスチャとして生まれます。
- 回転、アスペクト比の調整、インターレース解除、SDR 版を納品するためのトーンマッピングは、libplacebo が GPU 上で行います。
- AI モデル(アップスケール、画質修復、SDR→HDR 変換など)が GPU 上で 1 フレームずつ処理します。途中でフレームの種類が変わっても、処理側はどの橋を渡ったかを知る必要がありません。
- 解像度を目標に合わせる必要があれば、もう一度高速スケーリングを行います。
- 各エンコーダーが自分に合った形でフレームを受け取ります。NVENC は CUDA、oneVPL と AMF は D3D11 です。
- パケットがマルチプレクサーに入り、タイムスタンプが整えられ、ファイルが書き出されます。
ひと言でまとめると、ハードウェアデコードがテクスチャを残し、相互運用が別の API にそれを見せ、画質処理は GPU に留まり、ハードウェアエンコーダーが同じ GPU メモリからフレームを読み込んでビットストリームを生成する、ということです。システムメモリが登場するのは、そのマシンにより上の橋がないときか、ある工程が CPU 上の画素を本当に読む必要があるときだけです。それはあくまでフォールバックであって、設計の中心ではありません。
Mac では同じことを別の方言で言います。VideoToolbox がメディアエンジンでデコードし、フレームは CVPixelBuffer として処理系に入り、Metal が EDR で HDR を画面に届け、ProRes と HEVC の書き出しは再び VideoToolbox に戻ります。
分割並列の書き出しではタイムラインをいくつかの区間に分けますが、各区間が通るのはこの同じ処理系で、速さのために色の処理を省く近道を別に用意しているわけではありません。
KwaFlux で変更できる設定
ほとんどは自動ですが、次の設定で動き方を変えられます。
- ハードウェアデコード(設定 › パフォーマンス):自動(既定)、オン、オフ から選びます。特定のファイルでデコードが乱れたりエラーが出たりする場合は、オフにしてソフトウェアデコードで切り分けます。変更はアプリの再起動後に反映されます。
- AI プロセッサ(設定 › パフォーマンス):AI 処理に GPU を使うか、アプリに任せるかを選びます。通常は GPU のほうが速く、次の書き出し、プレビュー、マスク生成から反映されます。
- AI 書き出しのリソース使用量:低負荷(1 本だけ処理し、複数 GPU では 1 枚だけ使用)、バランス(既定)、全速、カスタム(使う GPU と、1 枚あたりの同時処理数を指定)があります。下げると実行中の書き出しにすぐ反映され、完了済みの区間は失われません。
よくあるトラブルと対処
| 問題 | 考えられる原因 | 対処 |
|---|---|---|
| 特定のファイルのプレビューが乱れる、緑色になる | その GPU のハードウェアデコーダーがそのコーデックの種類に十分対応していない | ハードウェアデコードをオフにし、再起動してソフトウェアデコードを使う |
| HDR 再生中に SDR の区間が灰色っぽく見える | プレーヤーがフレームごとに表示モードを切り替えていない、またはファイルのタグが誤っている | ffprobe で各区間の伝達特性のタグを確認する |
| 書き出し中に CPU 使用率が高く、GPU が空いている | システムメモリを経由する段まで経路が下がっている、または CPU でしか動かないフィルターがある | GPU ドライバーを更新し、CPU でしか処理できない設定を使っていないか確認する |
| 並列書き出しで NVIDIA のエンコードがセッション不足を報告する | 同時のエンコードセッションがドライバーの上限を超えている | 並列のジョブを減らすか、リソース使用量を低負荷かバランスにする |
| GPU を 2 基積んだノート PC で書き出しが遅い | デコードと表示が別の GPU で行われ、GPU 間コピーが発生している | OS のグラフィックス設定で KwaFlux が単体 GPU を使うようにする |
このアーキテクチャにできないこと
- すべての経路でのコピーなしの共有。 はしごの 4 段目と 5 段目はシステムメモリを経由し、古い GPU や相互運用の拡張がないドライバーではここを使います。
- Dolby Vision の再現。 HDR で確かに言えるのは、静的な HDR10 と HLG です。
- Mac での Windows 並みの全面的な相互運用。 Mac の強みは VideoToolbox、ProRes、CVPixel フレーム、Metal EDR であって、Windows と同じ数の橋ではありません。
- 速度向上の倍率の約束。 コピーが減るとどれだけ速くなるかは、GPU、ドライバー、解像度、処理工程によって変わります。ご自身の素材でプレビューし、測ってください。
まとめ
全工程 GPU はスローガンではなく、段階的にフォールバックできるルーティング表です。速いマシンでは画素が最後まで GPU に留まり、遅いマシンでも 1 段ずつ下りて仕事を終えます。次に書き出すときは GPU と CPU の使用率を見てみてください。画素がどの道を通ったかがわかります。
ご自身の素材で効果をテスト
KwaFlux はご自身の GPU でフォーマット変換とすべての AI ツールを実行し、デコード、処理、エンコードをできる限り GPU 上で行います。AI 処理はご自身の GPU 上で実行され、メディアファイルが処理のためにアップロードされることはありません。Windows 10(64 ビット、バージョン 1809 以降)、Windows 11、Apple Silicon 搭載の macOS 12 以降で動きます。プレビューにアカウントは不要です。どのクリップでも 1・3・5 秒のプレビューを出せます。ログインと有料プランが必要なのは、書き出し、変換、ファイル修復、リンクからのファイルダウンロードだけです。
ご自身の素材で効果をテスト
KwaFlux を入手し、支払う前に自分の素材で効果を無料プレビュー。アカウント不要、処理はご自身の GPU で行い、メディアはアップロードしません。 動画のプレビューは 1、3、または5 秒、手ぶれ補正のプレビューは 5、15、または30 秒から選べます。
よくある質問
コピーなしの共有(zero-copy)とは何ですか?
2 つの部品が同じメモリを共有し、画素をコピーせずにアクセス権だけを受け渡すことです。たとえば NVIDIA の WGL_NV_DX_interop2 拡張は D3D11 テクスチャを OpenGL オブジェクトとして登録でき、ロックすれば OpenGL がシステムメモリを通さずに読み書きします。
GPU を 2 枚にすると書き出しは速くなりますか?
場合によります。ソフトウェアがタイムラインを区間に分けて 2 枚の GPU で並列に処理するなら 2 枚目が役に立ちます。1 本の処理は速くならず、1 枚でデコードしてもう 1 枚で表示すると GPU 間コピーが増え、かえって時間がかかります。
コンシューマー向けの NVIDIA カードでは、ハードウェアエンコードを同時にいくつ動かせますか?
NVIDIA の現在の対応表では、エンコーダーを持つ GeForce カードで最大 12 です。プロ向けやデータセンター向けのカードの多くには上限がありません。上限を超えた新しいエンコードは失敗するので、複数のファイルを並列で書き出すときは注意してください。
ハードウェアデコードはソフトウェアデコードより優れていますか?
いつもそうとは限りません。GPU メモリが逼迫している、コーデックがとても新しい、ファイルのパラメーターが特殊、といった場合はハードウェアデコードが失敗したり画が乱れたりします。CPU が強ければソフトウェアデコードも遅くありません。両方を残して状況に応じて選び、ハードウェアで無理ならソフトウェアに戻すのが妥当な設計です。
ハードウェアアクセラレーションをオンにしても書き出しが遅いのはなぜですか?
たいていはデコードがボトルネックではないからです。AI 推論、フィルター、エンコードにも時間がかかり、どこか 1 つがシステムメモリに戻ると、処理全体がコピー待ちで止まります。まずどこが待っているかを確かめてください。GPU 使用率が低く CPU 使用率が高いなら、どこかが CPU に戻っている可能性が高いです。ローカル AI とクラウド AI の動画処理もご覧ください。
参考資料
- NVIDIA, Video Encode and Decode GPU Support Matrix (up to 12 concurrent encode sessions on GeForce; AV1 hardware decoding from 5th-gen NVDEC) (2026-10-22 閲覧)
- Khronos, WGL_NV_DX_interop2 (registering D3D10 and D3D11 resources as OpenGL objects) (2026-10-22 閲覧)
- Khronos, EXT_external_objects_win32 (`GL_EXT_memory_object_win32`, importing external GPU memory through Win32 handles) (2026-10-22 閲覧)
- libplacebo, Options (EWA Lanczos, tone-mapping curves, debanding, fast and high-quality presets) (2026-10-22 閲覧)
- PCI-SIG, Specifications (PCIe 4.0 at 16 GT/s per lane; bandwidth here computed for x16 with 128b/130b encoding) (2026-10-22 閲覧)
- Apple Developer, Video Toolbox (hardware-accelerated encoding and decoding framework) (2026-10-22 閲覧)
- Apple Developer, CAMetalLayer wantsExtendedDynamicRangeContent (extended dynamic range on Metal layers) (2026-10-22 閲覧)
- FFmpeg Filters Documentation (`scale`, `zscale`, `yadif`) (2026-10-22 閲覧)
Kw「KwaFlux の舞台裏」のほかの記事
続けて読む

KwaFlux のすべて:機能、対応環境、料金、アップデート
KwaFlux とは何か、何ができるか、どのシステムで動くか、何が無料で何が有料か、ライセンスの仕組み、各バージョンの変更点をまとめました。
Mac 版 KwaFlux:対応する Mac、セットアップ、パフォーマンスのコツ
KwaFlux が動く Mac、インストール方法、GPU アクセラレーションコンポーネントと標準モードの意味、Apple Silicon で処理を速く保つコツを解説します。
AI 動画高画質化を速くする方法:ワークフロー、設定、ハードウェア
AI 動画の高画質化が遅い理由と速くする方法を解説。処理する量を減らす、出力サイズを決める、手順の順番を整える、GPU とアプリの設定を見直す、の 4 点です。